2、元数据知识库
2.1 先理解什么是元数据知识库
上一节已经从整体上看过:问数智能体真正依赖的,不是整个数据仓库本身,而是经过整理、可检索、可解释的数仓元数据。顺着这个思路往下看,元数据知识库其实就是整套系统的“语义底座”。
这里先区分两个很容易混淆的概念:
- 数据仓库存的是订单、商品、地区、时间这类真实分析数据。
- 元数据知识库存的是“有哪些表和字段、字段是什么意思、字段可能有哪些取值、指标怎么定义”这类关于数据的数据。
也就是说,数据仓库负责“提供可查询的数据”,元数据知识库负责“帮助智能体理解这些数据”。
还要再区分一层:元数据库不等于元数据知识库,但它是元数据知识库的一部分。
在当前项目里,元数据知识库并不是某一个单独的库,而是由下面三部分协作组成的:
- 元数据库:用
MySQL保存最完整、最权威的结构化元数据。 - 向量索引:用
Qdrant负责字段和指标的语义召回。 - 全文索引:用
Elasticsearch负责字段取值的关键词匹配。
如果没有这层知识库,大模型虽然可能知道 SQL 语法,但它依然不知道:
- 当前数仓里到底有哪些表和字段
- 某个指标在这个项目里的业务定义是什么
- 用户问题里的自然语言表达,应该落到哪个字段、哪个字段值上
所以元数据知识库的作用,并不是直接替大模型生成 SQL,而是在生成 SQL 之前,先把“应该关注哪些表、哪些字段、哪些取值、哪些指标”准备好。没有这一步,后续 SQL 生成就很容易不稳定。
如果一定要用一个便于记忆的比喻,可以这样记:数据仓库更像“数据仓库房”,元数据知识库更像“这间仓库的说明书、索引卡和检索系统”。
如果你更习惯用“表格”来记忆,先看下面这个总表:
| 组件 | 主要存什么 | 解决什么问题 | 典型使用时机 |
|---|---|---|---|
MySQL 元数据库 | 表信息、字段信息、指标信息、字段与指标关系 | 保存最完整、最权威的结构化元数据 | 召回完成后回表取完整信息 |
Qdrant 向量索引 | 字段与指标的向量表示 | 解决“用户换个说法也能召回”的问题 | 字段召回、指标召回 |
Elasticsearch 全文索引 | 字段的实际取值 | 解决“问题里的自然语言值如何映射到真实字段值”的问题 | 字段值检索 |
2.2 元数据库
上面已经知道了:元数据知识库并不是一个单体,而是 MySQL + Qdrant + Elasticsearch 的协作结果。接下来我们先从其中最基础的一层开始,也就是元数据库。
元数据库负责存放完整、权威的结构化元数据。它不是业务数据本身,而是“关于数据的数据”。在当前项目中,这部分主要放在 MySQL 里,并包含四张核心表,用于保存数据仓库中的表信息、字段信息、指标信息以及字段与指标之间的关联关系。
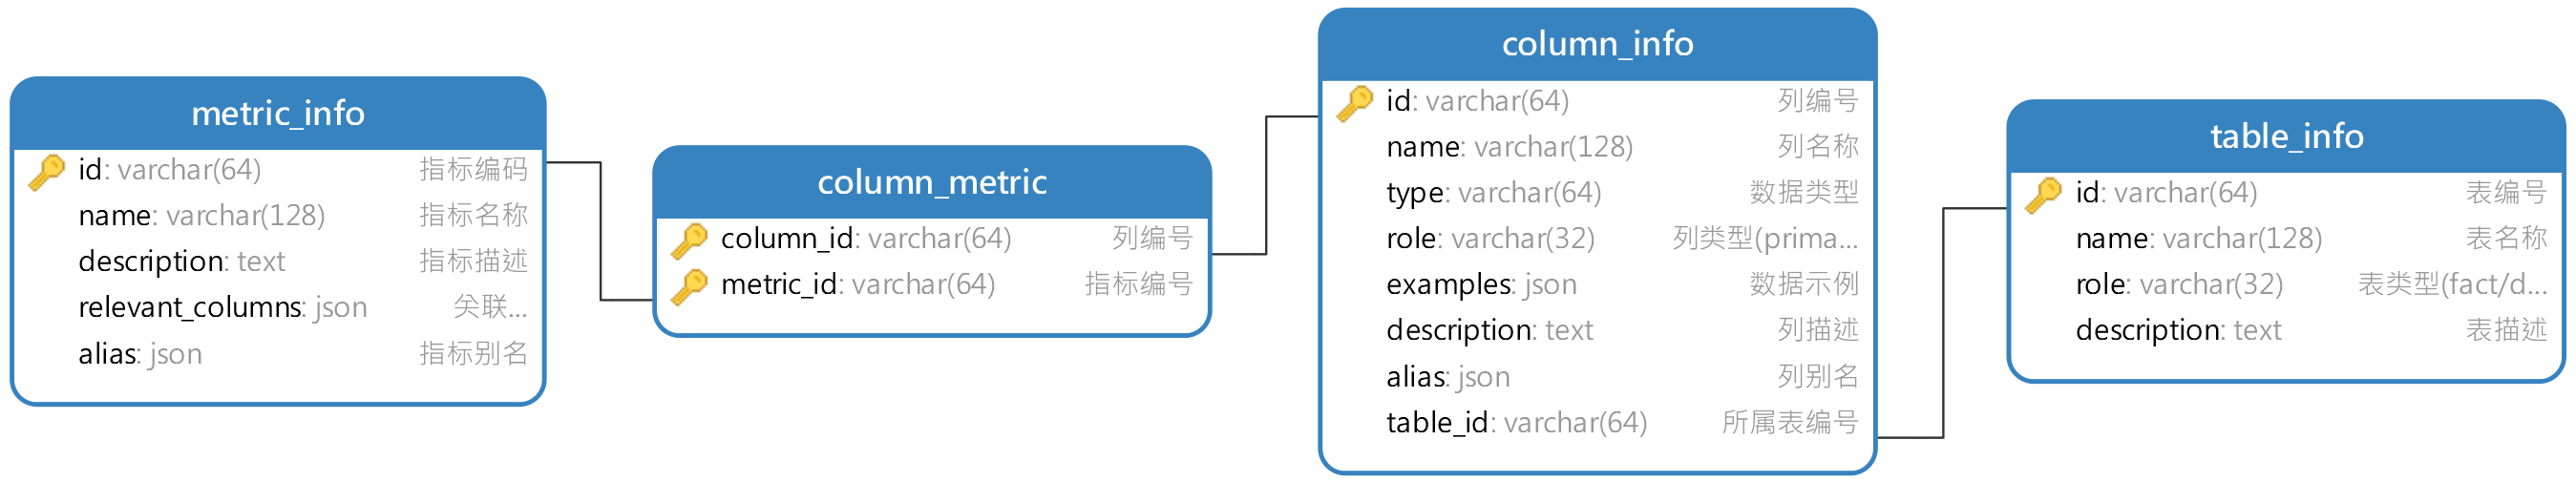
各表具体内容示例如下。为了便于快速建立直觉,先把这几张表的中文含义记住:
metric_info:指标信息表column_metric:字段与指标关联表column_info:字段信息表table_info:表信息表
这里还需要先澄清一个很容易误解的点:元数据库里的这四张表,虽然最终都是由同步脚本写进去的,但它们的来源并不完全一样。
更具体地说,它们通常是由“配置文件 + 数据仓库查询结果”共同组织出来的:
table_info和column_info主要围绕数据仓库中的表和字段构建metric_info和column_metric则更多来自配置文件中定义的指标信息及其字段关联关系
也就是说,这四张表并不都是“直接从数据仓库原封不动同步”过来的,而是同步脚本在读取配置、查询数仓、整理关系之后,统一写入元数据库的结果。
如果再展开一点,可以这样理解:
table_info:表名、表角色、表说明这类信息,通常主要来自配置文件中对表的定义。同步脚本会根据这些配置,生成最终的表信息记录。column_info:字段名、字段角色、字段说明、字段别名这类业务语义信息,通常主要来自配置文件;字段类型和部分示例值,则会由同步脚本再去数据仓库中实际查询并补齐。所以它既依赖配置,也依赖数仓中的真实结构。metric_info:指标名、指标说明、指标别名、相关字段这类信息,通常不是直接从数据仓库表结构里扫描出来的,而是来自配置文件中的指标定义。因为像GMV、AOV这种指标,本身更偏业务口径,而不是数据库天然自带的信息。column_metric:这张表保存的是“指标和字段之间的关系”。它通常也是由同步脚本根据配置中的指标定义和relevant_columns整理出来的,而不是靠扫描数据仓库自动推导出来。
metric_info 示例(指标信息表):
| id(指标 ID) | name(指标名) | description(指标说明) | relevant_columns(相关字段) | alias(指标别名) |
|---|---|---|---|---|
| AOV | AOV | 全称 Average Order Value,表示所有订单的成交金额平均值。 | ["fact_order.order_quantity"] | ["平均单价", "平均订单金额"] |
| GMV | GMV | 全称 Gross Merchandise Value,表示所有订单的成交金额总和。 | ["fact_order.order_amount"] | ["成交总额", "订单总额"] |
column_metric 示例(字段与指标关联表):
| column_id(字段 ID) | metric_id(指标 ID) |
|---|---|
| fact_order.order_amount | GMV |
| fact_order.order_quantity | AOV |
column_info 示例(字段信息表):
| id(列编号) | name(列名称) | type(数据类型) | role(字段角色) | examples(示例值) | description(字段说明) | alias(字段别名) | table_id(所属表 ID) |
|---|---|---|---|---|---|---|---|
| dim_customer.customer_id | customer_id | varchar(64) | primary_key | ["C001", "C002", "C003", "C004", "C005", "C006", "C007", "C008", "C009", "C010"] | 客户唯一标识。 | ["客户ID", "用户ID"] | dim_customer |
| dim_customer.customer_name | customer_name | varchar(128) | dimension | ["李伟", "王芳", "张敏", "刘洋", "陈静", "赵磊", "黄秀英", "吴斌", "周燕", "徐浩"] | 客户名称。 | ["客户名称", "用户名称"] | dim_customer |
| dim_customer.gender | gender | varchar(16) | dimension | ["男", "女"] | 客户性别。 | ["性别"] | dim_customer |
| dim_customer.member_level | member_level | varchar(32) | dimension | ["黄金", "白银", "青铜", "铂金"] | 客户会员等级。 | ["会员等级", "用户等级"] | dim_customer |
| dim_date.date_id | date_id | int | primary_key | [20250101, 20250102, 20250103, 20250104, 20250105, 20250106, 20250107, 20250108, 20250109, 20250110] | 日期唯一标识,格式 yyyyMMdd。 | ["日期ID", "日期"] | dim_date |
| dim_date.day | day | int | dimension | [1, 2, 3, 4, 5, 6, 7, 8, 9, 10] | 日。 | ["日", "天"] | dim_date |
| dim_date.month | month | int | dimension | [1, 2, 3] | 月份。 | ["月", "月份"] | dim_date |
| dim_date.quarter | quarter | varchar(8) | dimension | ["Q1"] | 季度。 | ["季度"] | dim_date |
| dim_date.year | year | int | dimension | [2025] | 年份。 | ["年", "年份"] | dim_date |
| dim_product.brand | brand | varchar(64) | dimension | ["苹果", "三星", "华为", "戴森", "美的", "耐克", "阿迪达斯", "优衣库", "李维斯", "雀巢"] | 商品品牌名称。 | ["品牌", "品牌名称"] | dim_product |
| dim_product.category | category | varchar(64) | dimension | ["手机数码", "家用电器", "鞋靴", "服饰", "食品饮料", "休闲零食"] | 商品所属品类。 | ["商品类别", "品类", "分类"] | dim_product |
| dim_product.product_id | product_id | varchar(64) | primary_key | ["P001", "P002", "P003", "P004", "P005", "P006", "P007", "P008", "P009", "P010"] | 商品唯一标识。 | ["商品ID", "产品ID"] | dim_product |
| dim_product.product_name | product_name | varchar(128) | dimension | ["iPhone 15 Pro", "Galaxy S24 Ultra", "Mate 60 Pro", "戴森 V15 吸尘器", "美的空调 KFR-35GW", "耐克 Air Max 270 运动鞋", "阿迪达斯 Ultraboost 跑鞋", "优衣库 Heattech 保暖夹克", "李维斯 501 牛仔裤", "雀巢金牌速溶咖啡"] | 商品名称。 | ["商品名称", "产品名称"] | dim_product |
| dim_region.country | country | varchar(64) | dimension | ["中国"] | 地区所属国家名称。 | ["国家", "国家名称"] | dim_region |
| dim_region.province | province | varchar(64) | dimension | ["广东省", "浙江省", "四川省", "北京市", "上海市", "湖北省"] | 订单所属的省份名称。 | ["省份", "省", "所在省份"] | dim_region |
| dim_region.region_id | region_id | varchar(64) | primary_key | ["R001", "R002", "R003", "R004", "R005", "R006"] | 地区唯一标识。 | ["地区ID", "区域ID"] | dim_region |
| dim_region.region_name | region_name | varchar(64) | dimension | ["华南", "华东", "西南", "华北", "华中"] | 订单所属的大区名称,如华东、华南等。 | ["地区", "区域", "大区"] | dim_region |
| fact_order.customer_id | customer_id | varchar(64) | foreign_key | ["C001", "C005", "C003", "C008", "C012", "C015", "C002", "C007", "C010", "C019"] | 关联客户维度的外键。 | ["客户ID", "用户ID"] | fact_order |
| fact_order.date_id | date_id | int | foreign_key | [20250101, 20250102, 20250103, 20250104, 20250105, 20250106, 20250107, 20250108, 20250109, 20250110] | 关联时间维度的外键。 | ["日期", "下单日期"] | fact_order |
| fact_order.order_amount | order_amount | decimal(10,2) | measure | [8999.0, 6999.0, 125.0, 899.0, 60.0, 1399.0, 40.0, 299.0, 200.0, 9499.0] | 订单金额。 | ["销售额", "订单金额", "收入"] | fact_order |
| fact_order.order_id | order_id | varchar(64) | primary_key | ["ORD20250101001", "ORD20250101002", "ORD20250102001", "ORD20250102002", "ORD20250103001", "ORD20250103002", "ORD20250104001", "ORD20250105001", "ORD20250105002", "ORD20250106001"] | 订单唯一标识。 | ["订单ID"] | fact_order |
| fact_order.order_quantity | order_quantity | int | measure | [1, 5, 12, 8, 2, 10, 3, 6, 25, 4] | 订单中商品的购买数量。 | ["销量", "购买数量", "件数"] | fact_order |
| fact_order.product_id | product_id | varchar(64) | foreign_key | ["P001", "P003", "P010", "P006", "P011", "P014", "P012", "P008", "P002", "P013"] | 关联商品维度的外键。 | ["商品ID", "产品ID"] | fact_order |
| fact_order.region_id | region_id | varchar(64) | foreign_key | ["R001", "R005", "R002", "R004", "R003", "R006"] | 关联地区维度的外键。 | ["地区ID", "区域ID"] | fact_order |
table_info 示例(表信息表):
| id(表 ID) | name(表名) | role(表角色) | description(表说明) |
|---|---|---|---|
| dim_customer | dim_customer | dim | 客户维度表,描述下单客户的基本属性。 |
| dim_date | dim_date | dim | 时间维度表,用于多时间粒度分析。 |
| dim_product | dim_product | dim | 商品维度表,描述商品的基本属性信息。 |
| dim_region | dim_region | dim | 地区维度表,用于描述订单发生的地理区域信息。 |
| fact_order | fact_order | fact | 订单事实表,记录订单数量和金额等核心指标。 |
从设计思路上看,这四张表并不是随意拆出来的,而是各自承担了不同职责。与其把它们混在一起记,不如结合上面的示例表格,按表来理解。
table_info表负责回答:有哪些表,这些表是做什么的结合上面的示例,你会看到
fact_order被标记为fact,而dim_customer、dim_product、dim_region、dim_date被标记为dim。这里的role用来区分事实表和维度表,description用来解释这张表的业务作用。这样当大模型拿到table_info时,就不只是知道“有一张叫fact_order的表”,还知道它是一张订单事实表,主要记录订单数量和金额等核心指标。column_info表负责回答:表里有哪些字段,这些字段应该怎么理解和使用这是四张表里最关键的一张。比如在
dim_region.region_name这条记录里,系统不仅知道字段名是region_name,还知道它的类型是varchar(64),角色是dimension,示例值里可能有华南、华东、华北,描述是“大区名称”,别名还可能有“地区”“区域”“大区”。有了这些信息,系统后面才能理解:当用户问“华北地区销售额”时,华北很可能要落到这个字段上。column_info里几个字段尤其重要:type决定 SQL 应该怎么写,例如字符串、整数、日期的处理方式并不一样。role用来区分主键、外键、维度字段和度量字段。维度字段更适合分组和过滤,度量字段更适合sum、avg、count这类聚合,主键和外键则关系到多表join。description帮助大模型理解这个字段的业务含义。alias帮助系统在向量召回时匹配不同说法。比如“会员等级”和“用户等级”其实都可能指向member_level。examples则帮助模型理解真实取值格式。例如用户问“统计河北省的销售额”,系统必须知道库里到底存的是河北还是河北省;又比如性别字段,到底存的是男/女、male/female,还是1/0。这些差异都会直接影响 SQL 能不能写对。
当然,
examples只适合保存部分示例值,而不是所有值。像性别、季度这类取值很少的字段,全部放进去问题不大;但品牌名、商品名这类字段取值很多,就更适合交给后面的全文索引去处理。metric_info负责回答:有哪些业务指标,这些指标是什么意思比如上面的
GMV和AOV。系统不能只知道“有这个缩写”,还要知道它的业务含义、别名,以及它和哪些字段相关。因为真实业务里很多指标都是公司内部约定的,大模型未必天然理解。如果用户问“成交总额”或“平均订单金额”,系统就需要依赖metric_info去理解这其实是在问GMV或AOV。这里还有一个设计点值得注意:
metric_info里保存了relevant_columns。从规范化角度看,这个信息似乎已经可以通过关系表去表达,但把它直接冗余在这里,会让系统在组装提示词时更方便地拿到“某个指标依赖哪些字段”,减少额外查询成本。column_metric负责回答:某个指标和哪些字段有关这张表结构最简单,但作用很清楚,就是把字段和指标之间的关系单独保存出来。例如
fact_order.order_amount对应GMV,fact_order.order_quantity对应AOV。这样做的价值在于,它把“指标和字段之间的多对多关系”表达得更清楚,也方便后续扩展。
如果把这四张表再压缩成一句话,可以这样记:
table_info管“表”column_info管“字段”metric_info管“指标”column_metric管“字段和指标的关系”
有了这部分结构化元数据,系统才知道“销售额”对应的可能是哪个字段,“地区”可能对应哪张维度表中的哪个列,“GMV”到底是什么意思,也才有可能进一步做精准召回和 SQL 生成。
如果把这一节再总结成一句话,可以这样理解:元数据库的设计目标,不只是“把表和字段记下来”,而是要尽量把那些会影响 SQL 生成准确性的关键信息都提前整理好,等到真正生成 SQL 时,大模型才能“有据可依”。进一步说,SQL 生成质量通常取决于两个核心因素:模型自身的基础能力,以及元数据知识库的设计质量。模型能力决定理解、推理和生成上限,而元数据设计则决定模型在生成 SQL 时能不能拿到足够准确、完整、贴近业务语义的上下文信息。
2.3 向量索引
仅仅依赖精确匹配,往往很难满足自然语言问数场景。比如用户说“成交总额”,而字段说明中写的是“订单金额”;用户说“用户等级”,而字段元数据中写的是“会员等级”。这时如果只靠关键词逐字匹配,就很容易召回失败。
因此,需要把元数据库中部分字段信息和指标信息进一步构建成语义向量索引,让系统具备“语义相近也能找到”的能力。
向量索引主要作用于两类信息:column_info,也就是字段信息;metric_info,也就是指标信息。
这里需要特别说明一点:本项目并没有对 table_info 单独建立向量索引。原因并不是表信息不重要,而是字段信息本身已经带有 table_id。也就是说,只要把字段召回出来,我们就可以根据字段所属的 table_id 反查出它对应的表信息。因此在实际设计中,没有必要再额外对表信息做一套独立的向量召回。
也就是说,本项目的思路是:
- 先召回字段信息和指标信息
- 再根据字段里的
table_id回到元数据库中拿到对应表信息
这样设计既能减少重复索引,也能让整体检索逻辑更集中。
- column_info
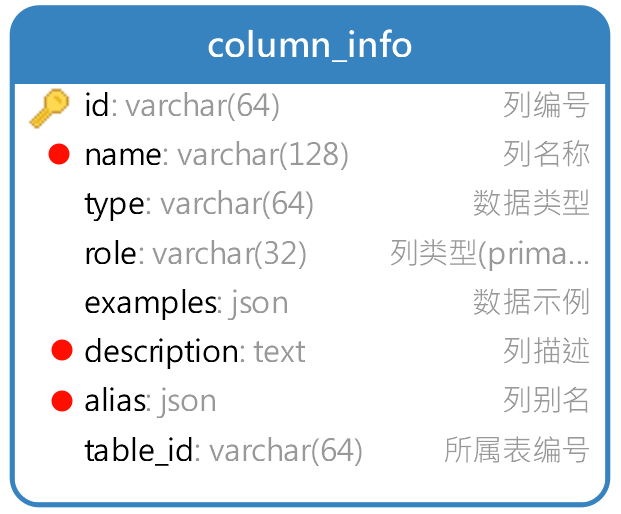
column_info 中需要建立向量索引的字段如下图所示:
具体示例如下图所示:
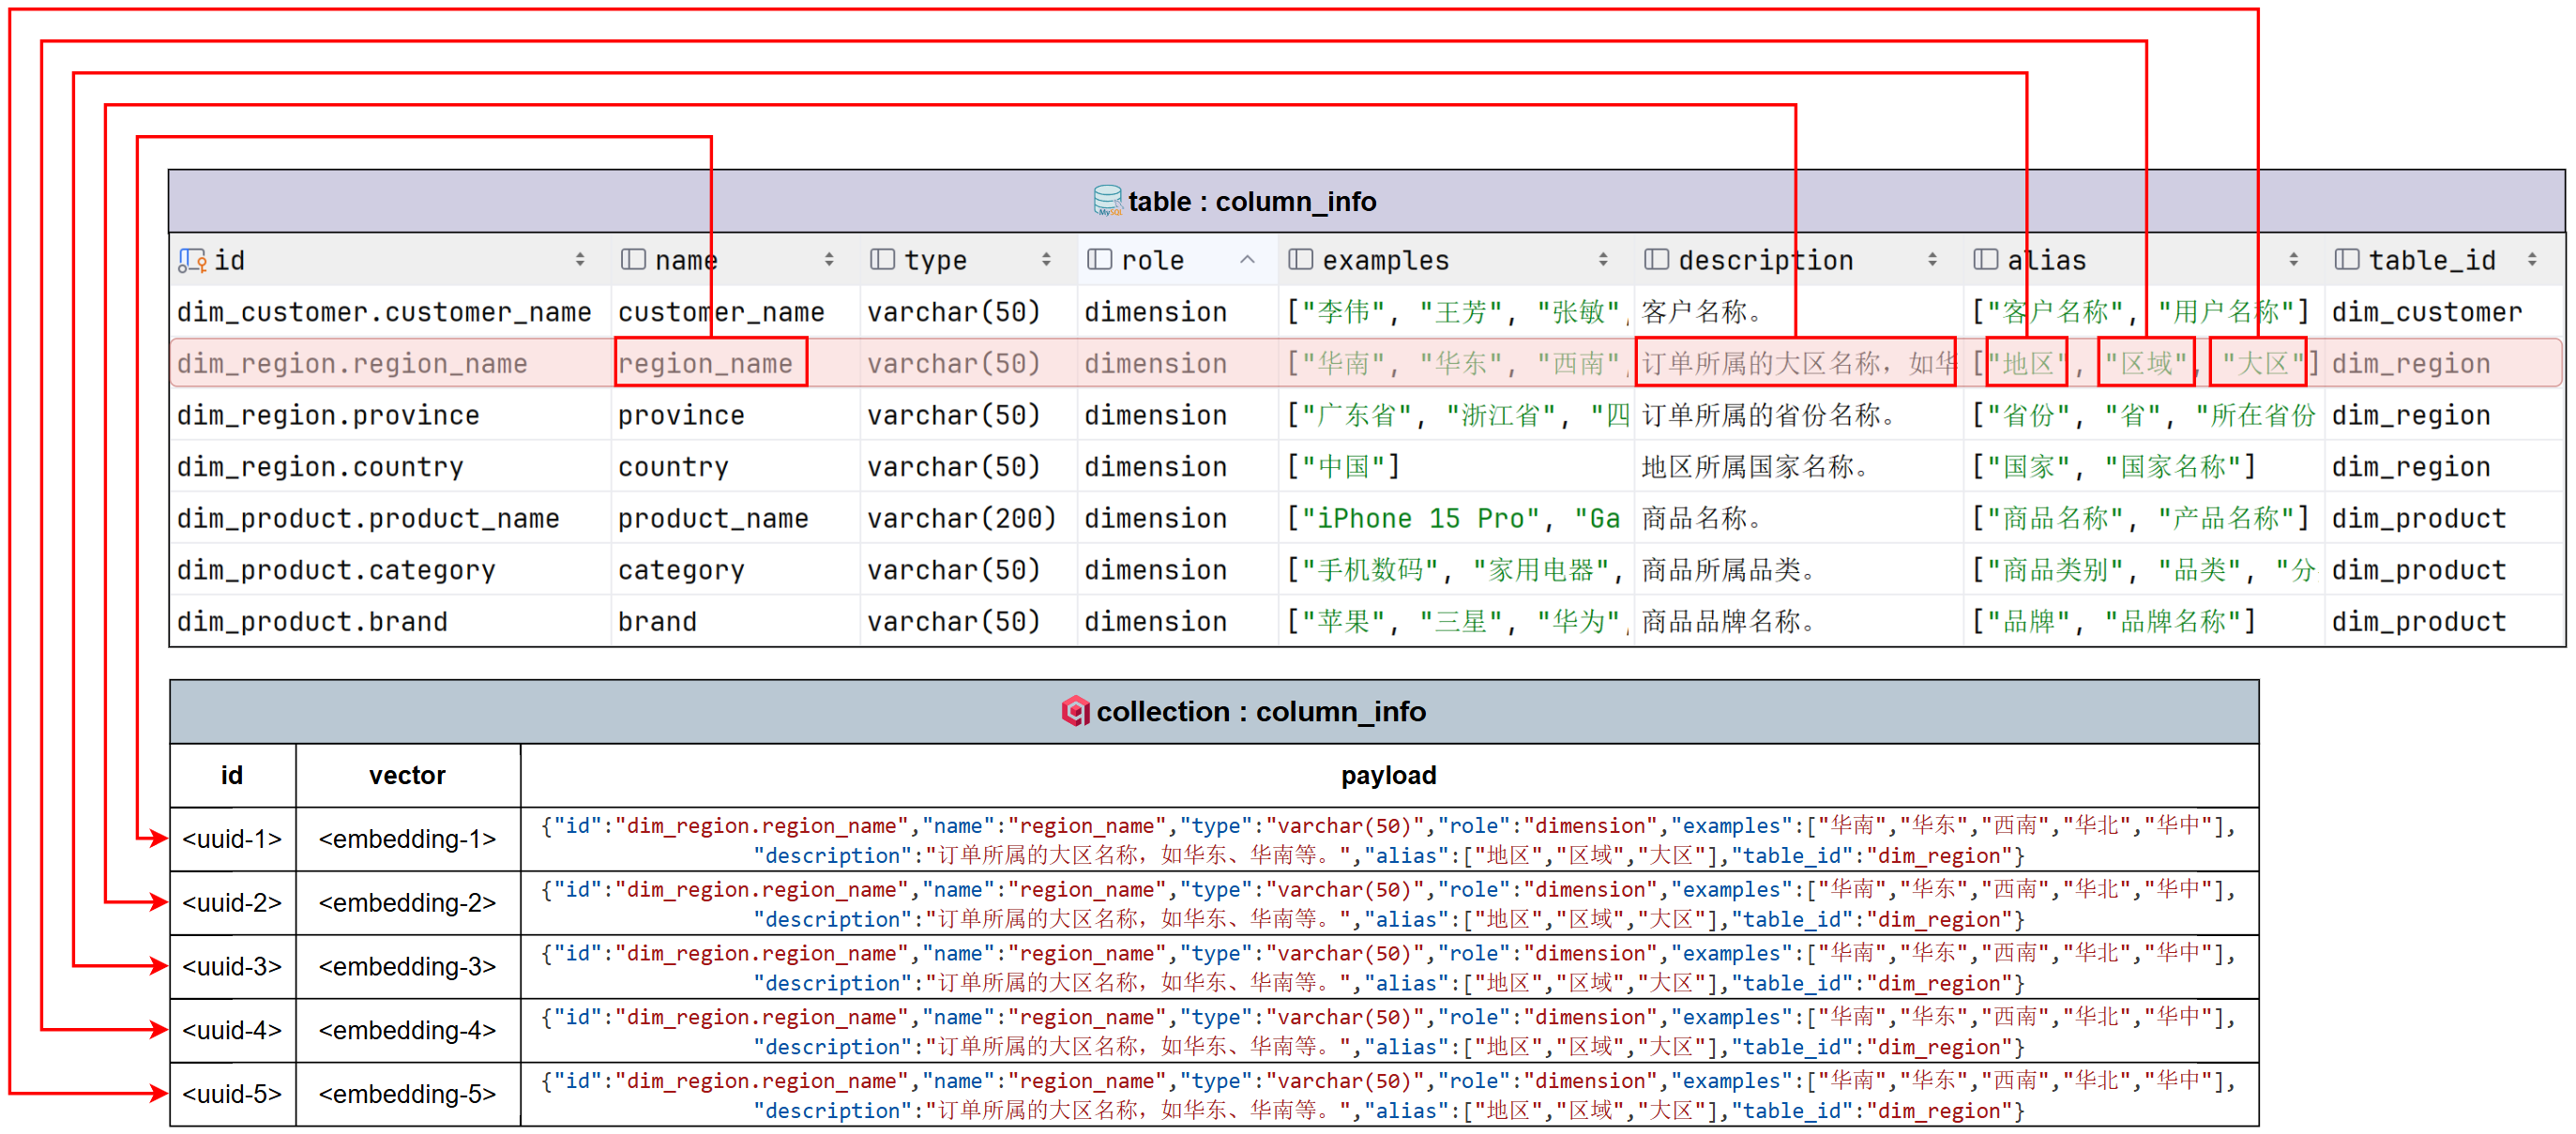
这里的核心思想不是“给一整行字段信息只建一个向量”,而是对同一行中的多个关键文本分别建向量。以 column_info 为例,一条字段记录通常会对应多个向量点:
- 字段名
name会生成一个向量 - 字段描述
description会生成一个向量 - 每一个字段别名
alias也都会各自生成一个向量
这意味着,column_info 中的一行记录,在向量数据库里往往不是一个点,而是多个点。这样做的好处是,不管用户问题更接近字段原名、字段描述,还是字段别名,系统都有更大概率把正确字段召回出来,从而提高召回率。
这里的“召回率”可以简单理解为:对于一个用户问题,本来真正相关的字段或指标有若干个,如果系统能够把这些相关对象尽可能多地找出来,召回率就高;如果明明相关,但系统没有把它们检索出来,召回率就低。也正因为如此,我们才会同时对 name、description 和 alias 建立向量索引,目的就是尽量减少“相关信息没有被找出来”的情况。
再进一步看,每个向量点除了会保存向量本身,还会带上对应的 payload。你可以把 payload 看作“这个向量点附带的业务信息”。在本项目里,payload 中保存的是完整的字段信息,而不只是一个简单的字段 ID。这样当系统在 Qdrant 中检索到最相近的向量点后,就可以直接从 payload 中取出完整字段信息,少做一次额外的数据库反查。
当然,这也是一种工程上的取舍。如果只保存 ID,向量库里的数据会更轻,但召回后还要回数据库再查一次;如果直接保存完整字段信息,召回后读取更方便,但当元数据库中的字段信息发生变化时,也要同步更新向量库中的 payload。本项目选择的是后者,目的是让查询链路更直接。
- metric_info
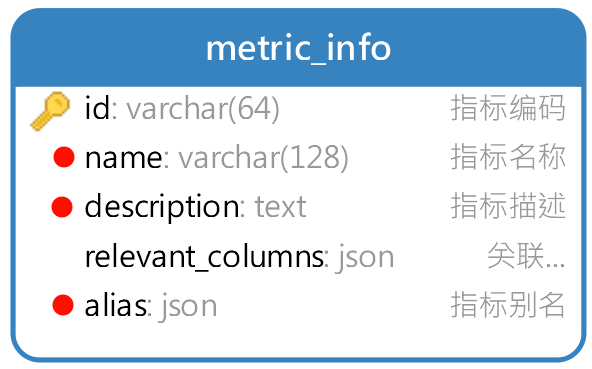
metric_info 中需要建立向量索引的字段如下图所示:
具体示例如下图所示:
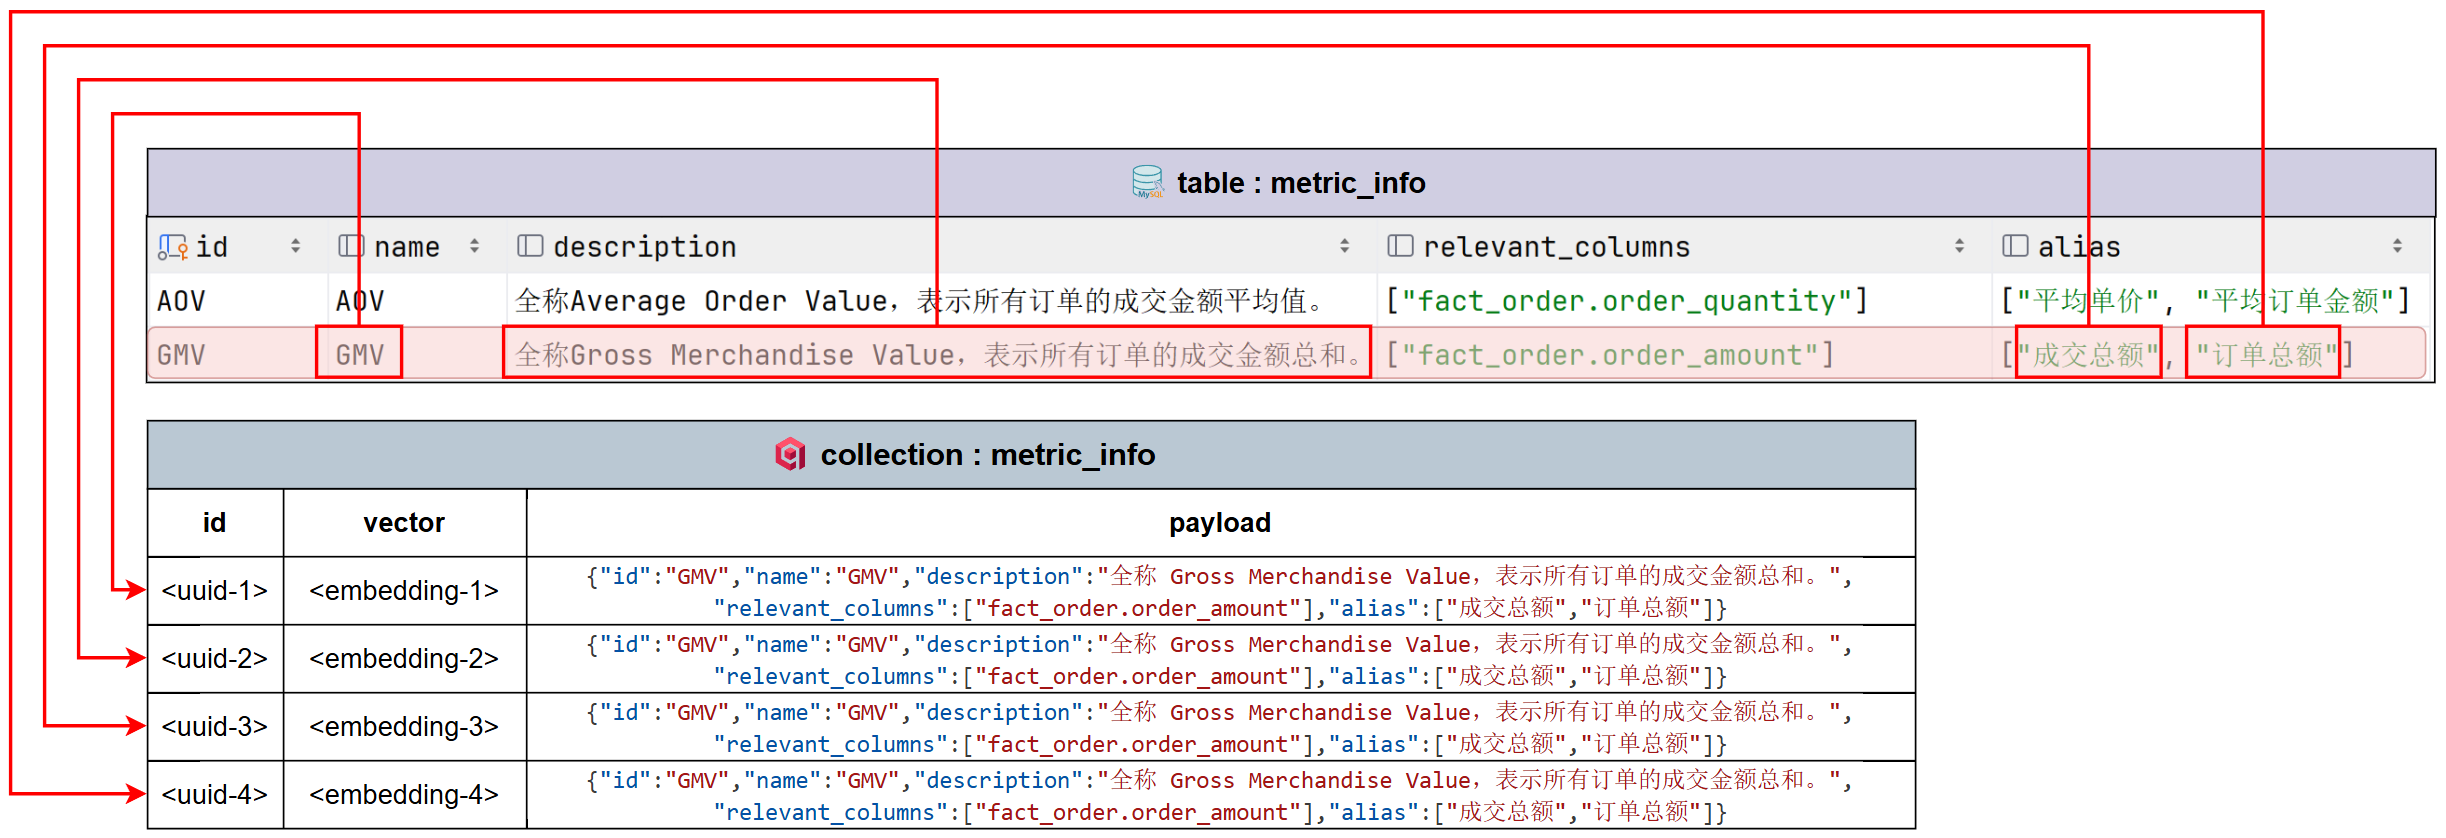
metric_info 的思路和 column_info 完全类似。对于一条指标记录,我们同样会对 name、description 和 alias 分别建立向量索引。这样当用户提问中出现某个业务指标的简称、别称,或者一种更口语化的表达时,系统也更容易把正确指标召回出来。
在实际实现中,我们会把字段名、字段描述、字段别名,以及指标名、指标描述、指标别名等文本分别送入 Embedding 模型,得到向量后存入 Qdrant,用于后续的语义召回。
如果把这部分再总结成一句话,可以这样理解:向量索引的目标,不是机械地“存一堆 embedding”,而是尽量让用户问题能够从不同表达方式出发,都能更稳定地召回到真正相关的字段和指标。
2.4 全文索引
除了字段和指标,问数系统还有一类非常关键的信息需要检索,那就是字段的实际取值。
例如用户提到:华北地区,黄金会员,某个具体商品名称。
这类信息往往不是“字段名”,而是“字段里的值”。为了让系统能把自然语言中的这些描述准确映射到数据库中的真实取值,我们还需要建立全文索引。
这一点其实和前面 column_info.examples 的设计是连起来的。examples 的作用,是先告诉大模型某个字段大概会有哪些取值格式;但如果一个字段的实际取值特别多,比如品牌名、商品名、地区名、品类名等,就不可能把所有取值都直接塞进 examples 里交给大模型。这样不仅上下文会变得很长,也会拖慢整体生成效率。
因此,本项目采用了一种更适合工程落地的做法:对于那些将来很可能会出现在 SQL 过滤条件中的字段取值,单独建立全文索引。当用户问题中出现“华北”“黄金会员”“手机数码”这类文本时,系统会先去全文索引中检索最相关的真实取值,再把这些检索结果补充回后续的提示词和 SQL 生成流程中。
这里还需要理解一个判断标准:并不是所有字段都适合做全文索引。一般来说,**全文索引主要针对的是“文本类型的维度字段”,因为这类字段最有可能作为过滤条件出现。**例如地区、省份、品牌、品类、商品名称、会员等级等,都很适合建立全文索引。
相反,像 order_amount、order_quantity 这类度量字段,通常更多是拿来做聚合统计,而不是拿来做关键词过滤;像 year、month、day 这种数值型字段,虽然也可能参与过滤,但它们并不适合按全文检索的方式处理。因此,全文索引并不是覆盖所有字段,而是有选择地覆盖那些“文本型、维度型、可能作为过滤条件”的字段。
具体示例如下图所示:
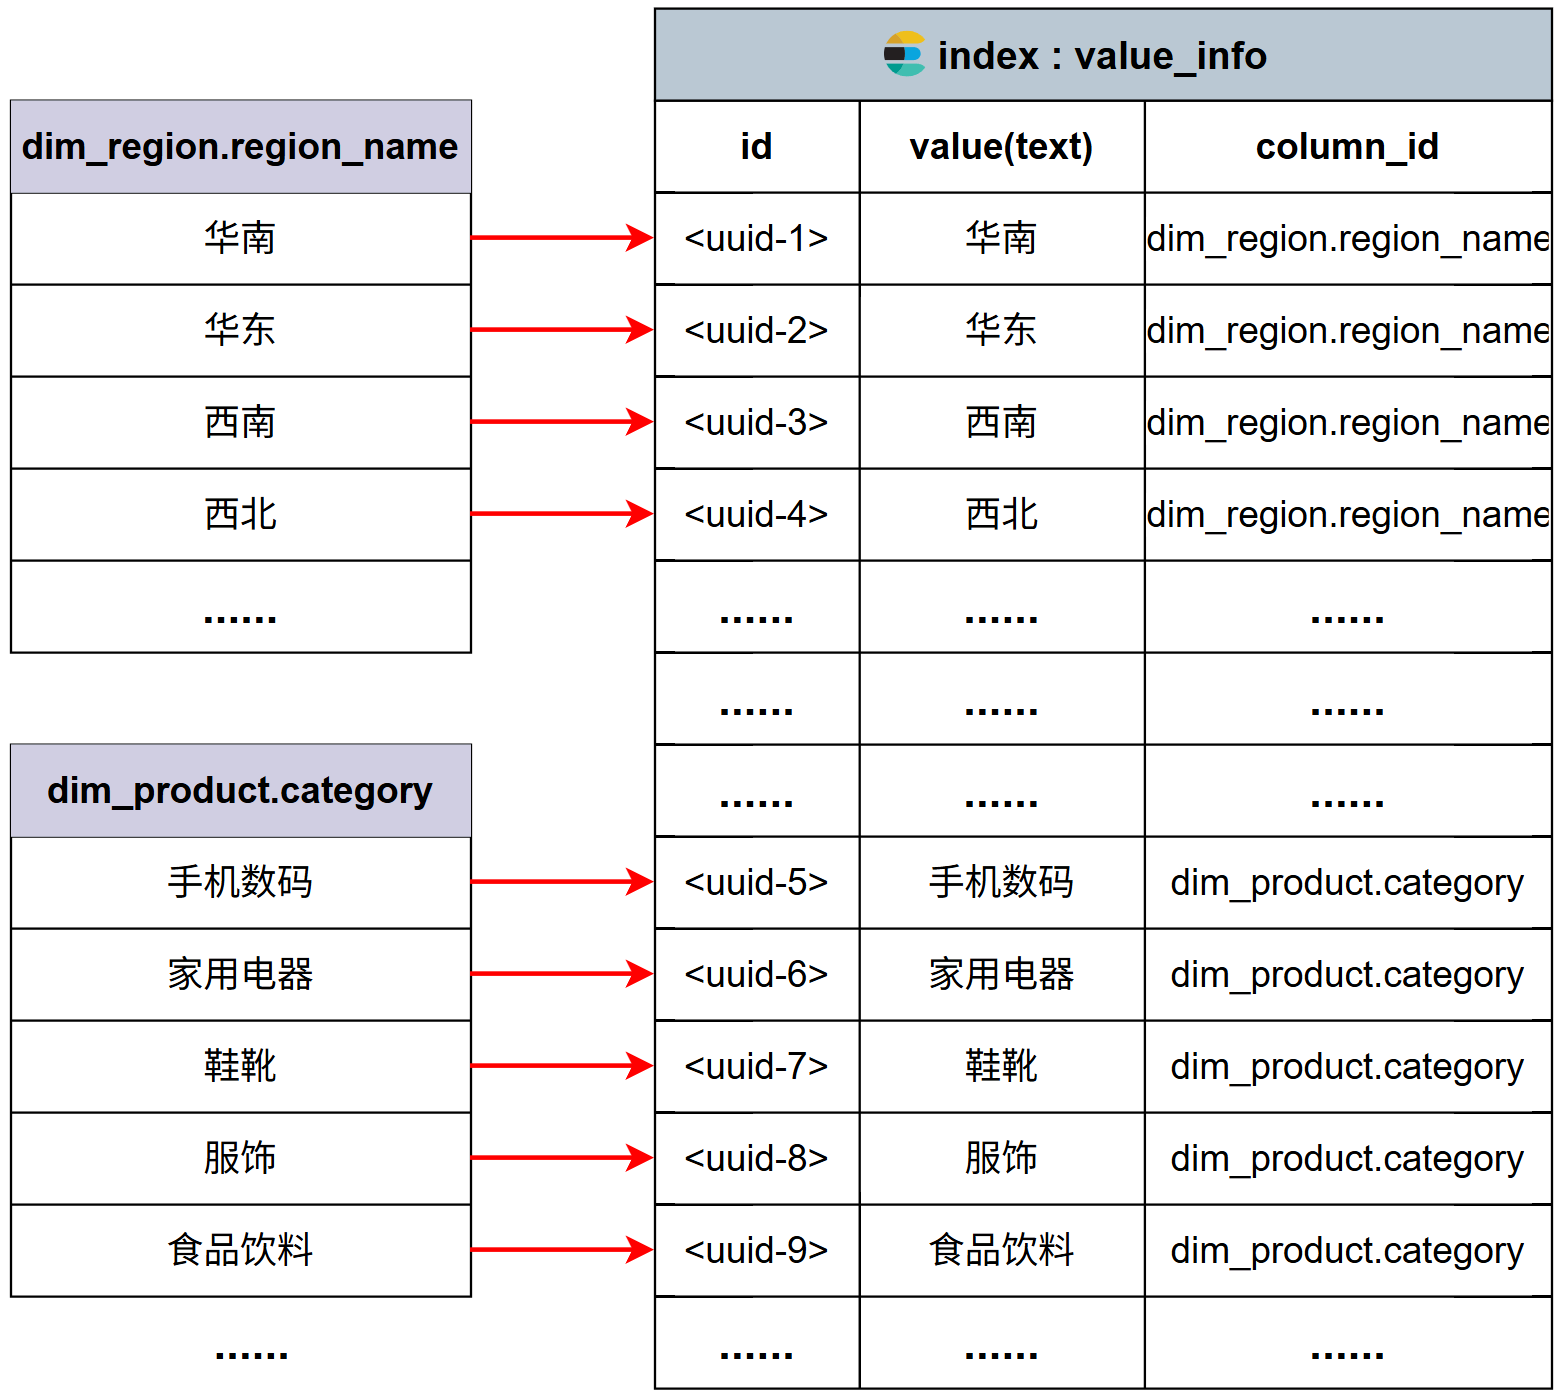
在项目实现中,这部分能力由 Elasticsearch 提供。每一个字段取值都会作为一条独立索引记录写入 ES,其中至少包括三个核心信息:
id:该取值的唯一标识value:字段的实际取值column_id:这个取值属于哪个字段
这样做的好处是,当系统检索到一个值之后,不仅知道“匹配到了什么文本”,还知道“这个值属于哪个字段”,于是就可以把检索结果重新挂回到对应字段上。
例如,用户问题里提到了“华南”,全文索引检索到这个值后,系统不仅知道它命中了文本 华南,还知道它属于 dim_region.region_name。于是后续在组织字段信息时,就可以把这个值补充到对应字段的候选取值中,为生成 WHERE region_name = '华南' 这样的 SQL 条件提供依据。
从更理想的方案来看,字段取值检索其实可以进一步做成“混合检索”,也就是同时结合全文检索和向量检索。因为某些特殊情况下,用户问题里的写法和数据库里的真实取值不一定完全一致,可能会涉及别称、拼音、同义表达等问题。在这种情况下,单纯依赖全文检索有时会漏掉结果,而混合检索通常会更稳。
不过在本项目中,这部分先做了工程上的简化:字段取值检索主要使用全文检索。这是因为在大多数常见场景下,字段取值更关注的是“文本是否相近”,而不是“语义是否抽象相近”,所以全文检索已经能够覆盖绝大多数需求。后续如果要进一步提升效果,再在这个基础上叠加向量检索,会是更自然的优化方向。
如果把这一节再总结成一句话,可以这样理解:全文索引解决的,不是“字段叫什么”的问题,而是“字段里到底存了什么值”的问题。它的核心作用,就是帮助系统把用户问题中的自然语言描述,映射成数据库中真实存在的过滤值。
2.5 元数据同步脚本
前面几小节讲的是“元数据知识库里有什么”。接下来这一小节要回答的是另一个工程问题:这些内容是怎么进去的。
在实际工程里,元数据知识库不是手工一点点录入的,而是要通过同步脚本来构建和维护。本项目中,有一项非常重要的基础工作,就是编写一个“元数据同步脚本”。它的作用可以概括为一句话:根据配置文件,把指定表、指定字段和指定指标同步到元数据知识库中。
如果你想先直观看到这些原始数仓表长什么样,可以回看第 1 章中的 数据仓库表示例。同步脚本读取的,就是这类事实表和维度表中的结构信息、字段信息和部分示例值。
这个过程大致包括:
- 读取配置文件,确定需要同步哪些表、哪些字段、哪些指标
- 从数据仓库中读取对应表结构、字段类型和部分字段取值示例
- 将完整元数据写入
MySQL - 为字段信息和指标信息构建向量索引
- 为适合检索的字段取值构建全文索引
这样设计的好处是,整个知识库的构建过程是可配置、可重复执行、可增量扩展的。
举个例子:
- 如果最开始数仓里有 100 张表,我们可以通过配置文件一次性把这 100 张表同步进知识库
- 如果后面又新增了 10 张表,只需要更新配置文件,再运行一次同步脚本,就可以把新增内容补进去
也就是说,元数据知识库并不是静态写死的,而是能够随着数仓变化持续演进的。
如果你后面要对照代码来看,这里先知道有两个相关文件:
app/scripts/build_meta_knowledge.pyapp/services/meta_knowledge_service.py
这一部分在后面的章节里还会继续展开,这里先有一个印象即可。