2、单卡显存排查与优化
第 30 章已经介绍过:训练显存中有模型权重,也有梯度、优化器状态和中间计算结果。现在把这些概念用于排查:
图中的优化项不是要求全部打开。先找出占用来自哪里,再选择对应的方法。
2.1 单卡 batch 与梯度累积
沿用第 31 章的配置,单卡 batch 为 4,梯度累积为 8。
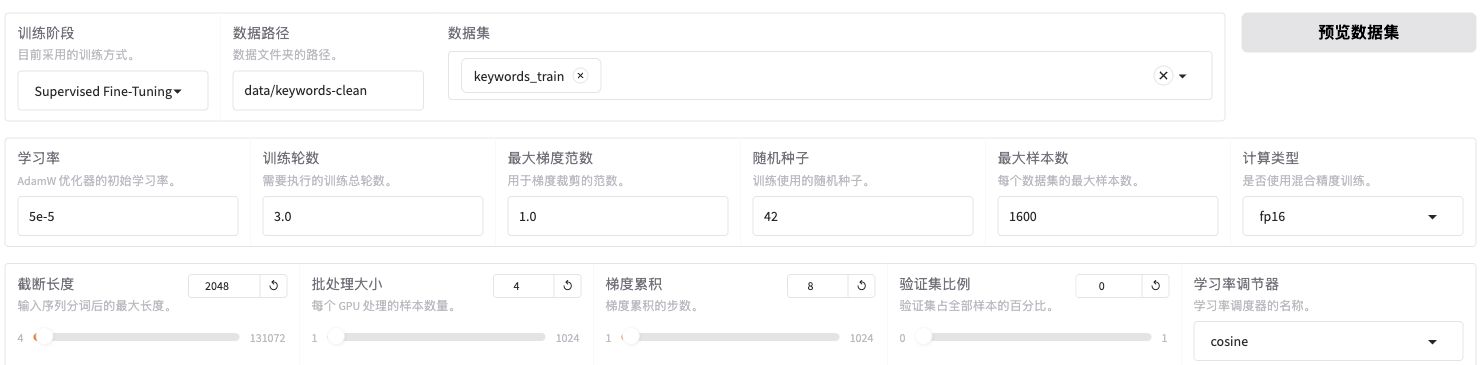
在截图下方找到 批处理大小和梯度累积。它们分别对应配置中的 per_device_train_batch_size 和 gradient_accumulation_steps;本节先只看这两个输入框,不重新讲其他训练参数。
可以先用文章数量理解:每次处理 4 篇文章,连续处理 8 批以后,再更新一次参数。因此一次更新合计使用:
4 篇 / 批 × 8 批 = 32 篇现在假设换了一个更大的模型,权重已经加载,但第一批训练出现 OOM。可以先把 batch 从 4 改为 2,让一次同时参与计算的文章少一些。
若这样能够继续训练,再把梯度累积从 8 改为 16:
| 设置 | 每次同时处理 | 更新前累计处理 | 有效批次 |
|---|---|---|---|
| 调整前 | 4 篇 | 8 批 | 32 篇 |
| 只降低 batch | 2 篇 | 8 批 | 16 篇 |
| 同时补足累积次数 | 2 篇 | 16 批 | 32 篇 |
减少 batch 是为了降低一次计算的占用;增加累积次数,是为了保持每次更新所用的数据量。 这是两个作用,不要把显存下降归因于梯度累积次数变大。
实际调整时,先把“批处理大小”改为 2;需要保持 32 篇的有效批次时,再把“梯度累积”改为 16。点击“预览命令”,核对这两个字段,并为试跑使用新的输出目录。上图展示的是调整前的设置。
有效批次相同,也不表示速度与训练结果完全相同。处理批次的次数、计算顺序等已经变化,仍要观察日志和验证表现。
如果权重本体就放不下,batch 从 4 改成 1 也不会把权重变小,应先处理流程图中的加载分支。
2.2 长度上限与实际训练长度
接着上面的例子:如果 batch 降到 2 后仍然报错,就检查长样本,再判断是否需要调整截断长度(cutoff_len)。
先回顾第 29~30 章的一点:训练序列包含模板、用户内容和参考答案,要按它们合计产生的 token 数判断长度。长度上限只是最多保留多少,不等于每条样本都已经这么长。
先看第 30 章已经得到的预处理检查结果:
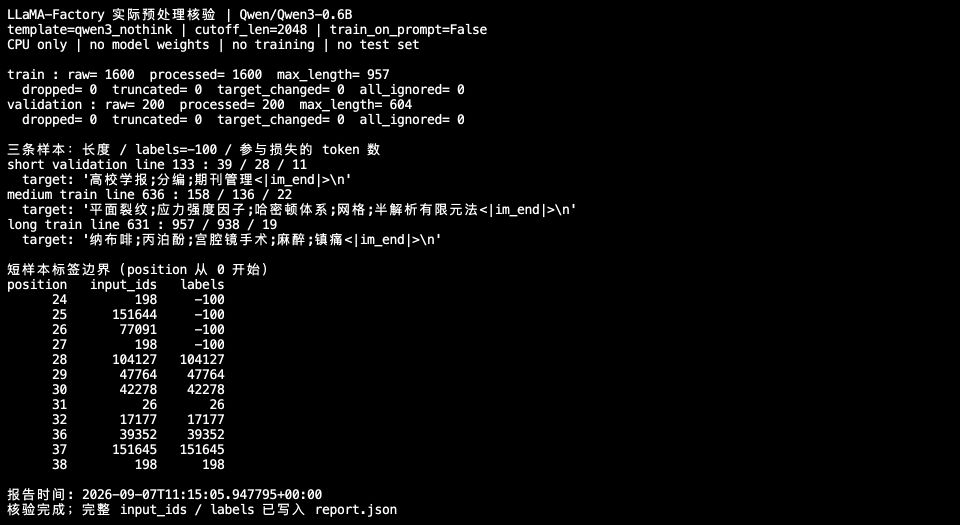
截图上方的 train、validation 两行显示:训练集 1,600 条,最长 957 token;验证集 200 条,最长 604 token。truncated=0 表示本次检查没有截断样本。
这份结果使用 Qwen3-0.6B、qwen3_nothink 模板和当前数据;具体方法见第 30 章“检查实际训练长度”。
同一批次的样本通常需要整理成相同长度。例如,两条样本分别有 200 和 500 个 token,按批次最长样本**填充(padding)**时,会在短样本上补 300 个占位,让两条都按 500 个位置组织计算;占位不增加文章内容。
在这个例子中,长度上限从 2048 改成 1024,两条样本仍保留原内容,填充后的批次也仍是 500 个位置。当前课程数据最长只有 957 token,同样不能仅凭上限减半就推断显存减半。
若把上限降到 512,则可能截掉长文章的后半段或参考答案。调整前要检查保留下来的训练内容;换模型、分词器或数据后,重新统计实际长度。任务确实需要长文章时,继续考虑下面的显存方案。
2.3 混合精度与梯度检查点
前面两项调整的是“每次放进多少数据”。接下来两项,调整的是“计算时怎样表示数值、保存多少中间结果”。
混合精度:
混合精度让适合的运算使用较低精度,必要部分仍保留较高精度,原理见第 30 章。本课 V100 基线已使用 fp16: true、bf16: false,梯度检查点也已启用;排查时先核对现状,不能把已经打开的选项当成新优化。换环境再按第 31 章的 GPU 实算检查确认适用精度。
梯度检查点:
反向传播要用到前面计算的中间结果。梯度检查点选择少保存一些,需要时重新计算,以额外计算换取显存空间。
跟着图中的 a2 看:不使用这项方法时,把它保存下来,反向时直接取用;采用图示的保存方式后,需要 a2 时,就用保留的 a1 重算第 2 层。省下的是部分中间结果的存储,代价是多做一次相应的计算。
课程已有训练日志中出现了:
Gradient checkpointing enabled.这条日志可用来确认梯度检查点已启用。它负责减少计算中间结果的存储;每隔 50 步保存的 checkpoint 文件则用于训练存档。
这两种方法不必同时改变。混合精度在合适硬件上还可能提速;梯度检查点通常需要增加重算,实际速度要看运行结果。
2.4 CPU 卸载:用系统内存分担显存
AutoDL 实例除了 GPU 显存,还有 CPU 使用的系统内存。**CPU 卸载(CPU offload)**就是让部分训练数据或状态不一直留在 GPU 上。
它适合分担选定状态或参数的占用,但搬运数据和 CPU 计算需要时间。先确认是哪部分放不下:LoRA 的可训练参数少,优化器状态可能本来就不大,仅卸载优化器不一定能解决基础权重过大的问题。
<details> <summary>进一步理解:GPU 与 CPU 分别保存什么、计算什么</summary>以优化器为例。第 30 章讲过,优化器会保存一些帮助后续更新的信息。在支持优化器卸载的方案中,这些状态可以放在 CPU 内存中,有些实现还会让 CPU 执行相应的更新计算。
下图以优化器状态和更新计算都卸载到 CPU 的方案为例:
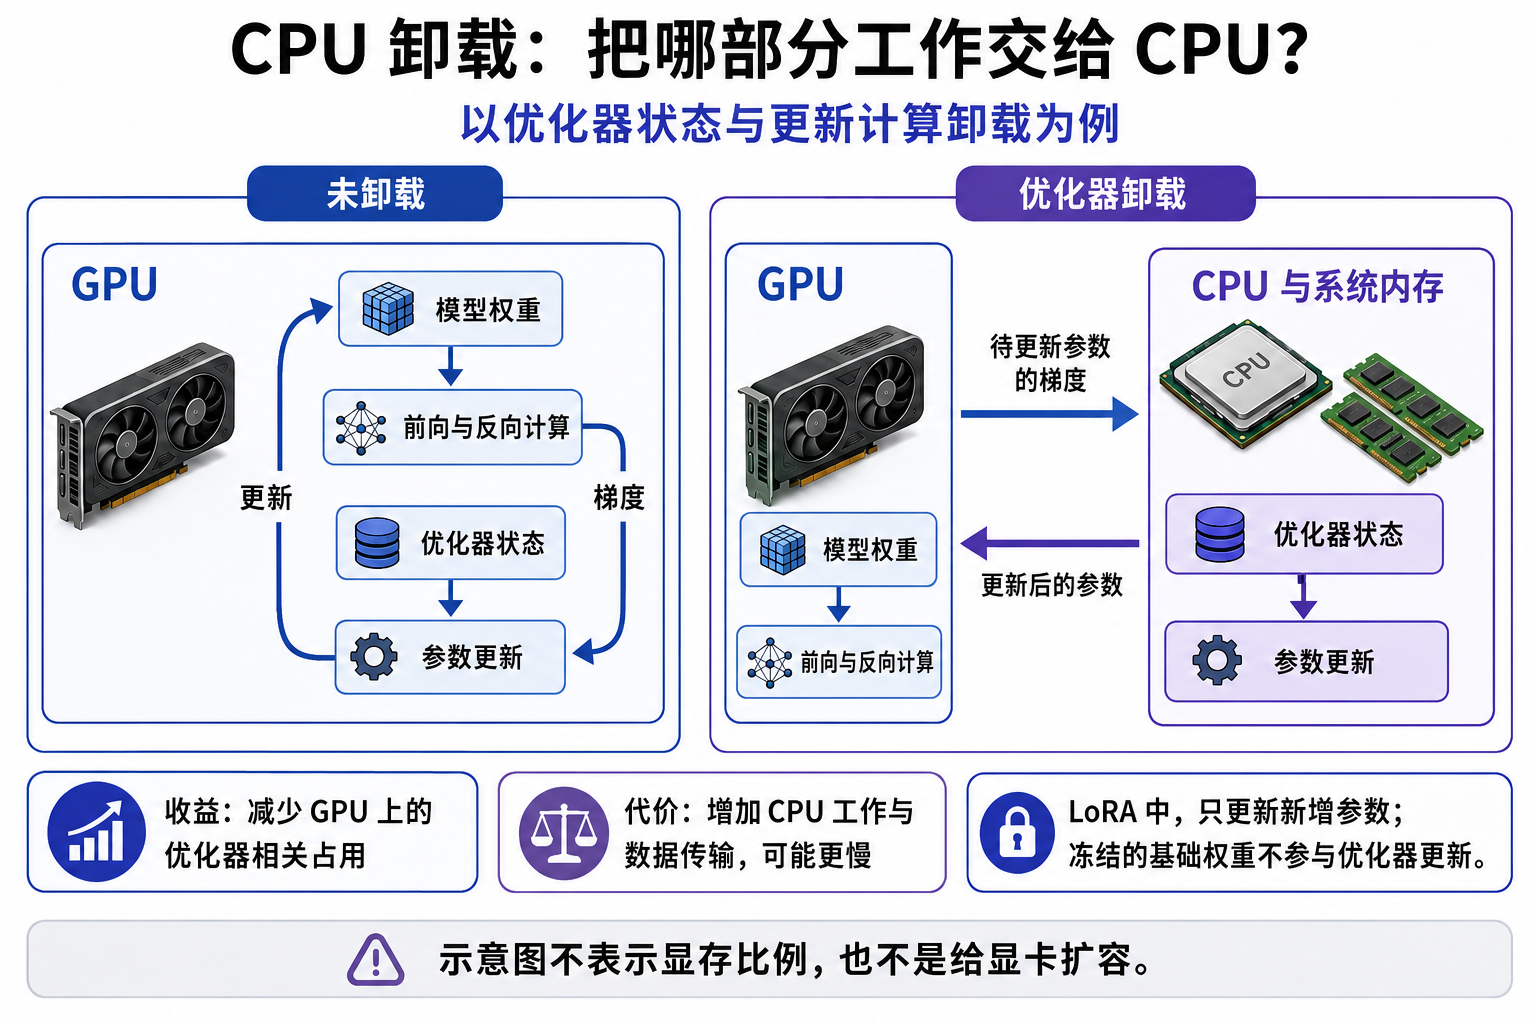
读图时沿右侧的两条箭头走一遍:GPU 完成前向与反向计算,把需要更新的参数的梯度交给 CPU;CPU 利用优化器状态计算更新,再把更新后的参数传回 GPU,供后续计算使用。基础模型仍然参与 GPU 上的计算,并不是整套训练都搬到了 CPU。
在 LoRA 中,基础权重被冻结,优化器主要处理新增的可训练参数。因此,卸载优化器能省多少,取决于这部分原本占了多少空间;不能照搬全参数训练的节省比例。图示原理可对照 DeepSpeed ZeRO-Offload 官方说明。
如果还启用了参数卸载,模型参数的存放与取用也会变化。后面介绍 DeepSpeed 时,会分别看到 优化器卸载和参数卸载,两者不能混写。
</details>系统内存也有容量限制;CPU 处理和数据传输也需要时间。模型能放下以后,若每步明显变慢,就要判断这种取舍是否能接受,而不是只看显存数字变小。
2.5 从普通 LoRA 到 QLoRA(选做)
如果主要压力来自基础模型权重,可以考虑第 30 章介绍的 QLoRA:用低位数保存基础权重,仍训练新增的 LoRA 参数。
普通 LoRA 使用未量化的基础权重;QLoRA 增加量化加载环节,两者都训练新增的 LoRA 参数。
先掌握选择依据:基础权重占用大时,量化值得考虑;如果主要是长序列的中间结果放不下,还要继续处理长度和批次。4 bit 描述权重的存储方式,训练计算仍可以使用 FP16。
量化可能节省显存,也可能影响速度与输出质量。准备比较时,保持其他条件一致,分别记录资源与实际回答;安装、NF4 和双重量化字段在下面查阅。
先检查量化依赖。
在 AutoDL 的 LLaMA-Factory 目录中,进入第 31 章创建的 Python 环境:
cd /root/autodl-tmp/LLaMA-Factory
source .venv/bin/activate
uv pip show torch bitsandbytes
sed -n '1,20p' requirements/bitsandbytes.txt
bitsandbytes 是这里用于量化的依赖。若没有安装,只在准备选做量化实验时处理它,不需要为了普通 LoRA 提前安装。
可以先查看安装会带来哪些变化:
uv pip install --dry-run -r requirements/bitsandbytes.txt若计划替换当前已验证的 PyTorch 或 CUDA 相关包,先停下来核对兼容性,不要直接升级。确认适合当前环境后,才执行实际安装:
uv pip install -r requirements/bitsandbytes.txt
uv pip check
安装完成后,还要用短训练检查量化加载、前向和反向计算是否正常。
再对照页面与参数。
先在模型设置区找到“量化等级”和“量化方法”:
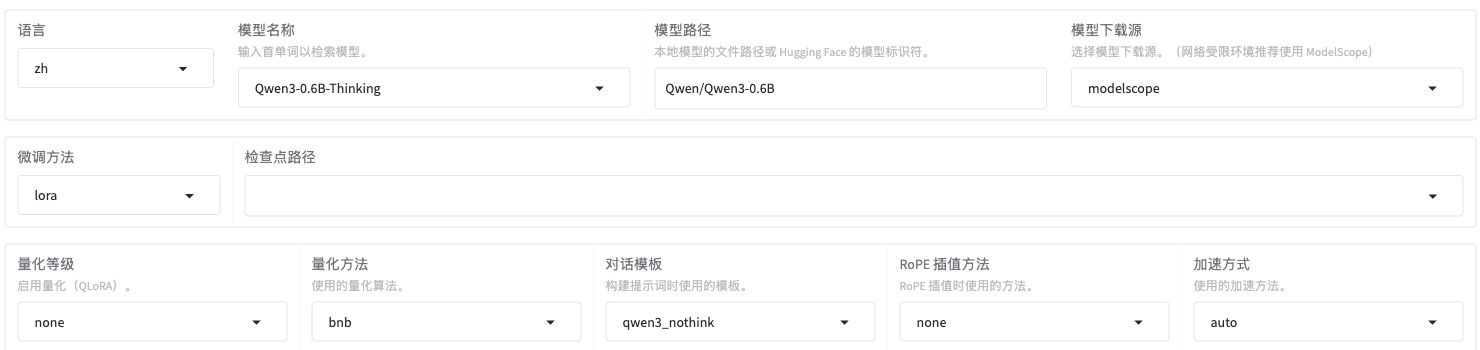
上图仍是普通 LoRA 的设置:量化等级为 none。即使旁边显示了 bnb,也不表示已经启用了 4 bit 量化。
准备选做 QLoRA 时,保持模型、数据和 LoRA 设置,将量化等级从 none 改为 4,量化方法选择 bnb(即 bitsandbytes)。再预览命令,检查量化字段。该版本的相关配置可写成:
# 量化相关设置片段,不是完整训练配置
# 微调方式:仍然训练 LoRA 新增参数
finetuning_type: lora

# 量化工具:bnb 是 bitsandbytes 的简称
quantization_method: bnb

# 量化位数:基础权重采用 4 bit 编码保存
quantization_bit: 4

# 量化类型:NF4,针对权重分布设计的 4 bit 表示方式
quantization_type: nf4

# 双重量化:进一步量化缩放因子等辅助数据,减少存储开销
double_quantization: true

# 计算精度:本次使用 FP16 混合精度,不启用 BF16
fp16: true
bf16: false
其中 nf4 与双重量化沿用该版本的默认设置;预览命令可能省略未改动的默认值。
4 bit 说的是权重存储方式;fp16 说的是相应训练计算的精度设置。它们不是二选一,也不表示所有计算都使用 4 bit。
为 QLoRA 练习另设输出目录,例如 saves/Qwen3-0.6B-Thinking/lora/keywords-qlora-trial/。此路径由训练程序创建,不能当作已经包含权重的模型目录。
比较普通 LoRA 与 QLoRA 时,尽量保持模型、数据、batch、长度和累积次数相同,再看显存与速度。量化可能节省显存,但不保证更快,也不保证回答质量完全不变。
配置字段可核对本课程版本的量化参数定义;硬件要求见bitsandbytes 官方说明。
2.6 怎样判断调整是否有效
权重已加载、第一批才报 OOM 时,先降低 batch,观察能否通过原来的报错位置;需要保持有效批次,再增加累积次数。仍报错就继续检查实际长度和已有优化。每次只围绕一个问题调整,才能知道哪项改变起了作用。
观察 GPU 使用情况时,在 AutoDL 的 JupyterLab 中另开一个终端,不要占用正在运行训练的终端,执行:
watch -n 1 nvidia-smi这表示每秒刷新一次。在这个监控终端按 Ctrl+C 只会退出 watch,不会停止另一个终端中的训练。
还要继续留意:
- 更长的样本进入批次时,会不会重新报错;
- 验证开始后,占用是否变化,验证 batch 是否需要单独调整;
- 首次更新参数、保存检查点时,是否出现新的问题。
实际对照:batch 减半以后,发生了什么?
下面两组使用同一张 V100 32 GB、Qwen3-0.6B 和 keywords-clean 数据,都做普通 LoRA 训练,其他设置保持一致。只把 batch / 累积从 4 / 8 改成 2 / 16,再比较相同工作量下的结果:
| 配置 | 全程最高采样显存 | 整次命令耗时 | 运行结果 |
|---|---|---|---|
| batch 4,累积 8 | 28,588 MiB(约 27.92 GiB) | 300.54 秒,约 5 分钟 | 出现过显存分配告警,随后正常结束并保存 checkpoint-50 |
| batch 2,累积 16 | 22,230 MiB(约 21.71 GiB) | 560.27 秒,约 9 分 20 秒 | 正常结束,保存 checkpoint-50 |
两组都完成 50 个更新步,有效批次都是 32,相当于各处理 1,600 条训练样本。耗时包含加载、训练、验证和保存;显存是全程每 200 毫秒采样的最高读数,可能漏掉瞬时高点。
把两组数字相减,可以看清这次调整的代价:batch 2 的最高采样占用减少了 6,358 MiB,约 6.21 GiB;整次命令则多用了 259.73 秒,约 4 分 20 秒。
<details> <summary>核对证据:两组原始日志、截图与计时差异</summary>两组使用第 29 章的 keywords-clean 数据:1,600 条训练样本、200 条验证样本。模板为 qwen3_nothink,长度上限为 2048,计算精度为 FP16,LoRA rank 为 8、alpha 为 16,学习率为 5e-5。模型、数据和其他设置保持一致,各自从原始模型新建 Adapter,使用不同的输出目录。
先看第一组实际保存的日志。找到 Instantaneous batch size、Gradient Accumulation steps 和 Total train batch size,分别是 4、8、32:
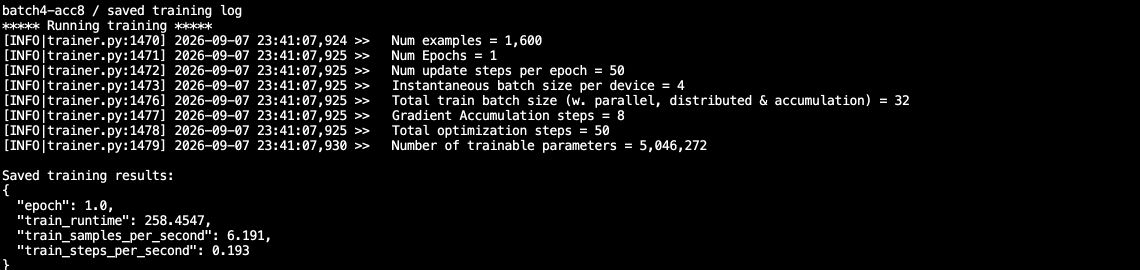
图中 train_runtime: 258.4547 是 Trainer 自身记录的运行时间,Num Epochs = 1 对应这次 50 步短跑。正文表格以 300.54 秒 记录从命令启动到退出的整体耗时,包含 Trainer 计时范围之外的工作,两者的起止范围不同。
再看第二组运行时的截图。三个位置变成 2、16、32,也就是说,每次同时处理的文章少了,但更新一次参数前仍累计处理 32 篇:
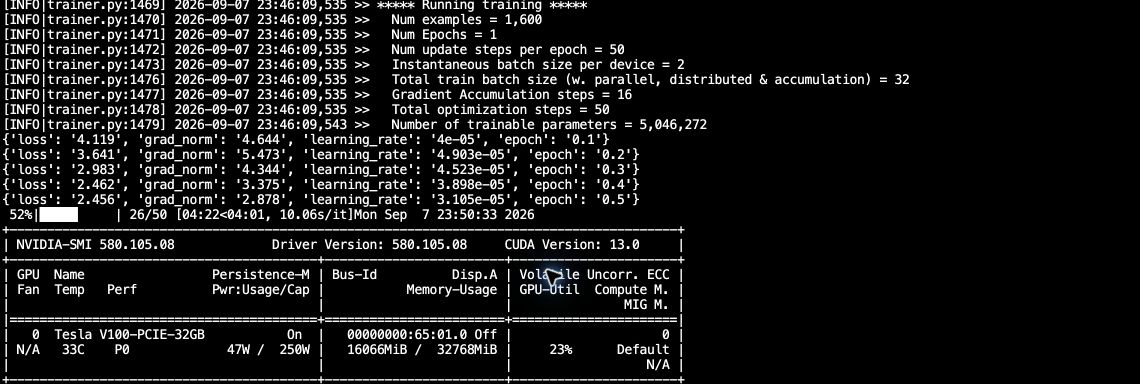
两组都运行 50 个更新 step:50 × 32 = 1,600 条,恰好练完当前训练集一轮;在第 50 步验证并保存 checkpoint-50。配置中的 max_steps: 50 优先于 num_train_epochs: 3,这次对照按 50 步结束。
统计口径: 耗时包含命令启动后的加载、训练、验证和保存;表中显存取同一范围内每 200 毫秒采样的最高读数,可能漏掉采样间隔中的瞬时高点。第二张图里的 16066MiB 只是截图当时的占用。两组使用相同的 Trainer 内存统计设置;其分阶段指标与这里的整卡显存读数分别记录。
batch 4 的日志在第 30 步附近出现过一次约 2.17 GiB 的显存分配失败,随后仍继续到第 50 步并正常退出。这说明它虽然完成了任务,运行中仍遇到过显存压力。
</details>为什么同样处理 1,600 篇文章,小 batch 仍可能更慢?每次更新都累计 32 篇,但训练时执行的小批次数量变了:
batch 4、累积 8:50 次更新 × 8 批 = 400 个小批次
batch 2、累积 16:50 次更新 × 16 批 = 800 个小批次
第二组每个小批次只处理一半文章,却需要执行更多次。单批更省显存,有效批次相同也不保证速度相同;实际耗时还受计算效率、加载、验证和保存影响。
如果 batch 4 在自己的任务中能稳定运行,可以保留它的速度优势;若已出现告警,或接下来需要处理更长文章,就应考虑是否值得用额外时间换取显存余量。这里的差值只属于本次模型、数据和环境,换任务后仍需重新比较。
需要复算资源对照时,从配套文件说明进入 results/batch-comparison/,查看 comparison.json、配置、日志和采样数据。这里保留资源统计、日志和曲线,不含 Adapter 权重或完整续训检查点;自己训练后应检查实际输出目录中的文件。
两组验证 Loss 都约为 2.171,关键词质量仍需按第 32 章检查实际回答。资源记录到这里应得出一个选择:自己需要多少显存余量,愿意为此多花多少时间。 不要求照搬本例的某一组设置。
先按第 31 章准备环境、模型和当前课程数据,确认没有其他 GPU 任务。在 AutoDL 的 JupyterLab 终端中准备配置目录:
cd /root/autodl-tmp/LLaMA-Factory
source .venv/bin/activate
mkdir -p configs
然后在 JupyterLab 文件面板中上传两份本机文件:
本机 案例与源码-4-微调/ 中的文件 | 上传到 AutoDL 的位置 |
|---|---|
compare_batch_resources.py | LLaMA-Factory/ 根目录 |
configs/keywords_clean_train.yaml | LLaMA-Factory/configs/ |
第 31 章走 WebUI 路线时,可能没有上传过这份 YAML;不能只传脚本就直接运行。这里使用课程附带的 CLI 配置,不使用 WebUI 的“保存训练参数”文件。同名文件已经存在时,先检查是否还是课程配置,不覆盖自己改过的版本。
脚本固定检查 model_name_or_path: Qwen/Qwen3-0.6B,并按仓库 ID 查找 ModelScope 缓存;不能直接换成本地路径或 8B 模型。若前面移动过默认缓存,先确认仓库 ID 仍能找到模型,否则可能重新下载。
回到刚才的 AutoDL 终端,核对文件和配置:
ls compare_batch_resources.py configs/keywords_clean_train.yaml
ls data/keywords-clean/keywords_train.jsonl data/keywords-clean/keywords_validation.jsonl
sed -n '1,100p' configs/keywords_clean_train.yaml
全部准备好,且确实要启动两组训练时,再执行:
python compare_batch_resources.py \
  --config configs/keywords_clean_train.yaml \
  --output-root /root/autodl-tmp/keywords-batch-trial \
  --steps 50
--output-root 必须是尚不存在的新目录。脚本会核对单张 V100、模型、精度和课程数据指纹,再依次启动两组训练,不会安装依赖或修改原训练配置。每组命令最多运行 10 分钟;失败或超时后停止,不自动重试。这个限制不会替你关闭 AutoDL 实例,仍要按第 5.6 节保存结果并关机。
输出中的 comparison.json 汇总结果;两组各有 config.yaml、train.log 和 gpu-samples.csv。采样文件保存时间、显存占用(MiB)、GPU 利用率(%)和功率(W),统计口径见上表说明。