1、整体架构概述
1.1 先看整体链路
第 1 章已经回答过「电商问数」是什么项目,也介绍了它为什么属于典型的 NL2SQL 场景。因此进入这一章后,我们重点看:这套系统在工程上到底是怎么跑起来的。
一句话来说这套系统的工作方式,可以概括成下面这句话:
先把数据仓库里的表、字段、指标、字段取值等知识整理成一套可检索的元数据知识库,再让问数智能体基于这套知识库生成、校验并执行 SQL。
可以把整条链路看作下面这个顺序:
- 用户先用自然语言提问
- 智能体先理解问题,并抽取适合检索的关键信息
- 系统再去元数据知识库里召回相关表、字段、指标和字段取值
- 把这些信息整理成更适合大模型理解的上下文
- 由大模型生成 SQL,并做校验与必要的纠错
- 最后到数据仓库执行 SQL,返回查询结果
这里最关键的设计思想是:不让大模型直接面对整个数仓“盲写 SQL”,而是先让它拿到经过整理和筛选的元数据上下文。
因为大模型即使懂 SQL,也天然不知道你当前数仓里:
- 有哪些表可以查
- 哪些字段代表销售额、地区、会员等级
- 用户说的“华北”“黄金会员”“成交总额”在库里到底对应什么
所以从系统本质上看,「电商问数」一直在做两件事:
- 先构建和维护元数据知识库
- 再基于元数据知识库实现问数智能体
前者解决的是“系统知道什么”,后者解决的是“系统怎么利用这些知识回答问题”。
1.2 本项目涉及的核心模块与基础服务
如果把整套系统拆开看,它大致可以分成两层:
- 上层是业务模块:数据仓库、同步脚本、元数据知识库、问数智能体
- 下层是基础服务:
MySQL、Qdrant、Elasticsearch、Embedding服务、大模型编排框架等
先看业务模块这一层:
- 数据仓库:负责存放真实分析数据。当前教学环境中没有真的部署
Hive,而是用MySQL来模拟数仓,里面主要是fact_order、dim_customer、dim_product、dim_region、dim_date这些表。 - 配置文件与同步脚本:负责规定同步范围,也就是要从数据仓库中抽取哪些表、哪些字段、哪些指标,并把它们同步到元数据知识库。
- 元数据知识库:负责把抽取出来的元数据组织成可检索、可解释、可召回的知识底座。
- 问数智能体:负责在用户提问时调用这套知识,完成召回、过滤、生成 SQL、校验 SQL 和执行 SQL。
再看支撑这些模块运行的基础服务:
| 基础服务 | 当前项目使用什么 | 主要作用 |
|---|---|---|
| 数据仓库 / 元数据库 | MySQL | 在当前项目里,MySQL 同时承担两类角色:一套是教学数仓库 dw,负责存放分析数据;另一套是 meta 元数据库,负责保存 table_info、column_info、metric_info、column_metric 等结构化元数据 |
| 向量数据库 | Qdrant | 保存字段信息和指标信息的向量,用于语义相似度检索 |
| 全文检索服务 | Elasticsearch | 保存字段取值索引,用于把“华北”“黄金会员”这类自然语言值映射到真实字段取值 |
| Embedding 服务 | TEI + BAAI/bge-large-zh-v1.5 | 负责把字段名、字段描述、指标描述、用户问题等文本转成向量,供 Qdrant 检索使用 |
| 智能体编排框架 | LangGraph | 负责把关键词抽取、多路召回、合并过滤、生成 SQL、校验 SQL、执行 SQL 串成可分步骤运行的工作流 |
如果只记一句话,也可以概括为:MySQL 管结构化存储,Qdrant 管语义召回,Elasticsearch 管字段取值检索,TEI 负责向量化,LangGraph 负责把整条问数流程组织起来。
1.3 对照架构图理解整条链路
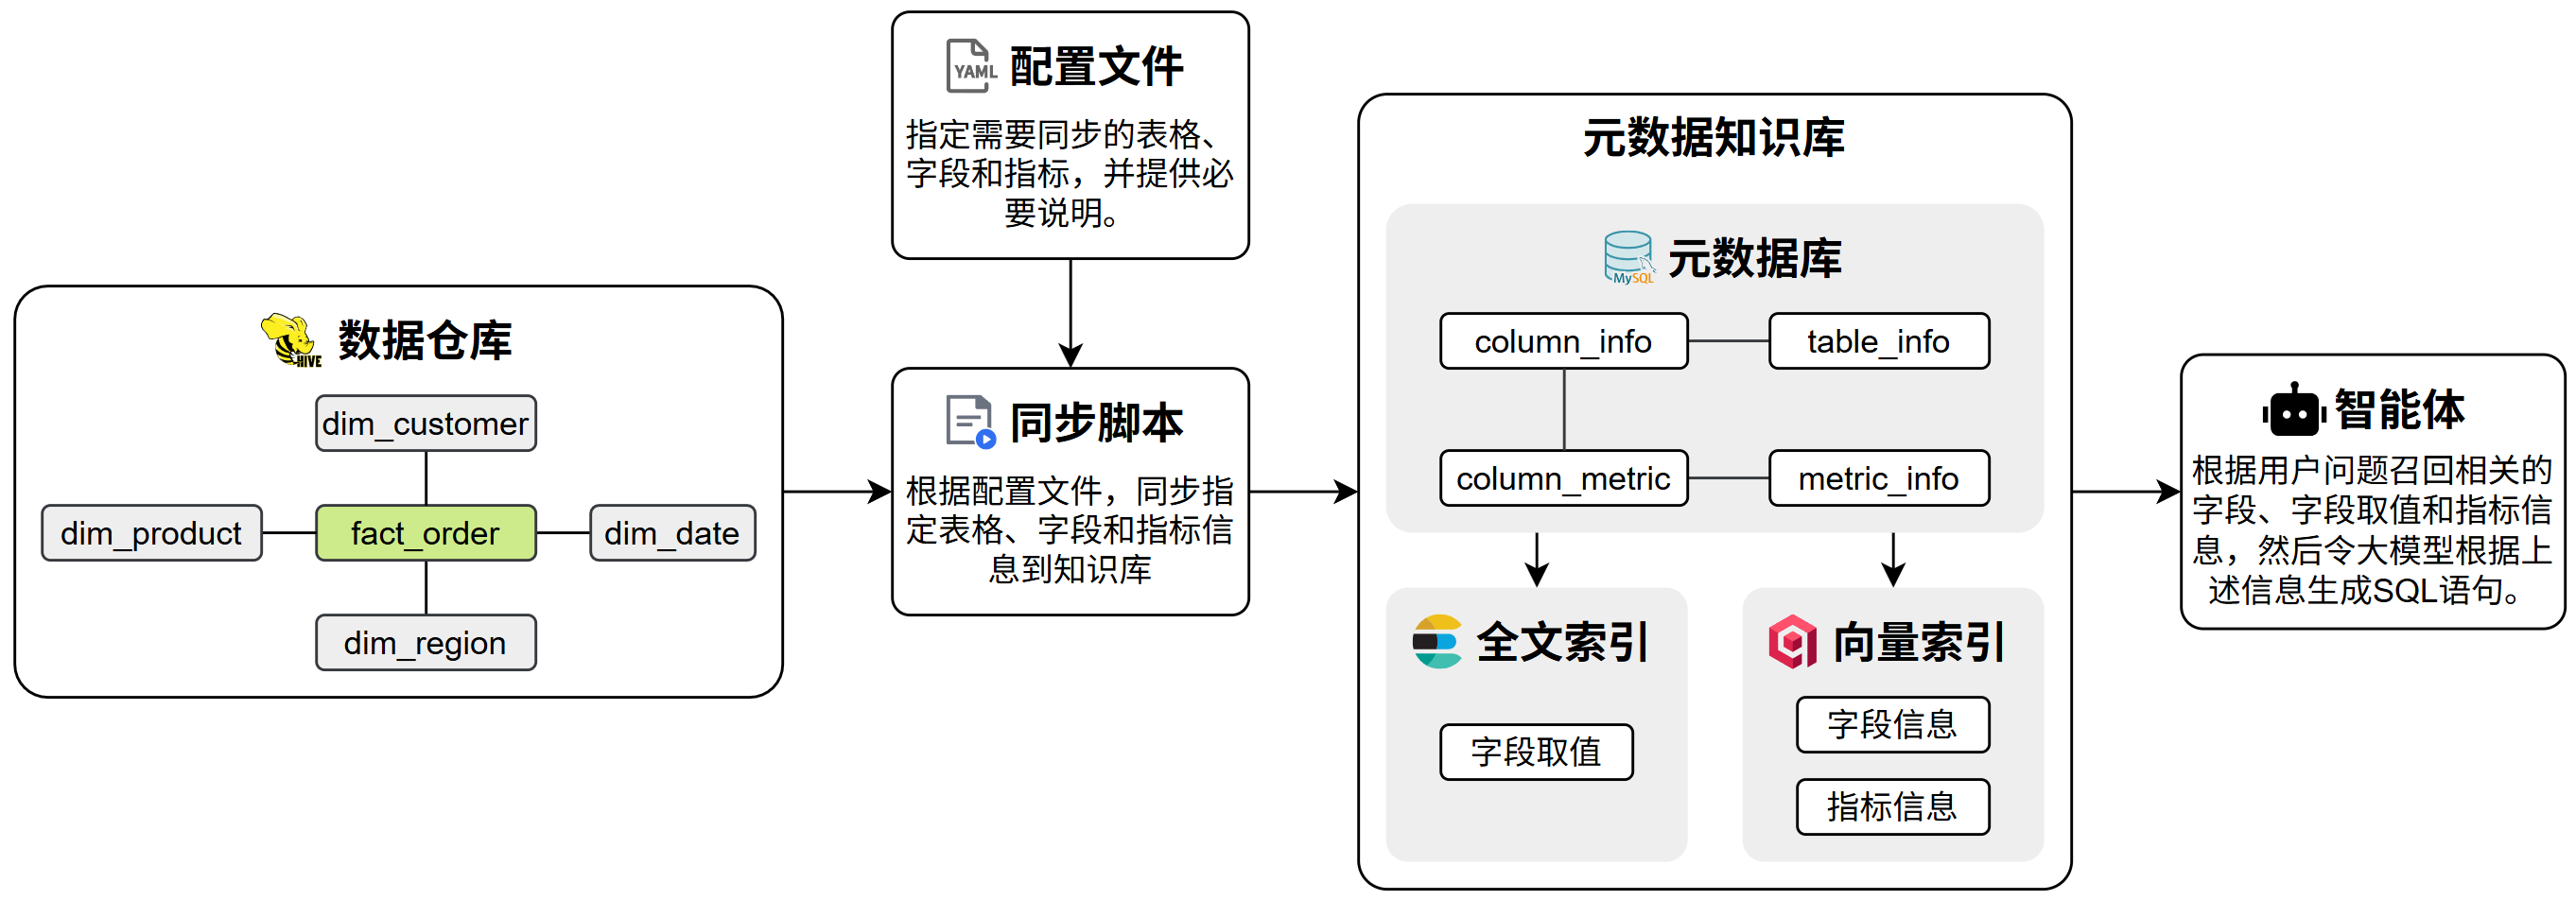
这张图如果第一次看,最容易晕的地方就是箭头很多、模块很多。更简单的看法是:整套系统其实只有两条主线。
- 构建期:先把知识准备好
- 查询期:再拿这些知识去回答问题
先看第一条主线,也就是构建期。
- 配置文件先告诉同步脚本:这次要纳入元数据知识库的有哪些表、哪些字段、哪些指标。
- 同步脚本再结合配置文件和数据仓库查询结果,组织出最终需要构建的元数据内容。其中,表和字段的业务语义、角色、别名等信息主要来自配置文件;字段类型、字段示例值以及部分真实取值,则由脚本再到数据仓库中查询补齐。
- 这些内容不会直接交给大模型,而是会先被整理并写入元数据知识库。
- 写入时会分三路落地:
meta MySQL保存结构化元数据,Qdrant保存字段和指标经过向量化后的语义索引,Elasticsearch保存部分字段的真实取值,方便后续全文检索。
这条链路做完之后,系统就不再只是“知道有一堆数仓表”,而是已经拥有了一套可检索、可解释、可供问数智能体调用的元数据知识库。
再看第二条主线,也就是查询期。
- 用户先提一个自然语言问题,比如“统计华北地区的销售总额”。
- 问数智能体先理解问题,再到元数据知识库里召回相关字段、相关指标和相关字段取值。
- 系统把这些召回结果整理成更适合大模型理解的上下文。
- 大模型基于这些上下文生成 SQL。
- 系统再做 SQL 校验,必要时纠错。
- SQL 通过后,才会真正到数据仓库执行,并把结果返回给用户。
所以这套系统最关键的点,不是“大模型会不会写 SQL”,而是:在写 SQL 之前,系统有没有先把正确的上下文准备好。
如果你更喜欢用“模块 + 技术栈”的方式去记,可以直接看下面这张表:
| 模块 | 作用 | 当前项目使用什么 |
|---|---|---|
| 数据仓库 | 存放真实分析数据 | MySQL(教学环境中用来模拟数仓) |
| 同步脚本 | 从数据仓库抽取元数据 | Python 脚本 + 配置驱动 |
| 元数据库 | 保存结构化元数据 | MySQL |
| 向量检索 | 召回相关字段和指标 | Qdrant |
| 全文检索 | 检索字段真实取值 | Elasticsearch |
| 向量化服务 | 把字段描述、指标描述、用户问题转成向量 | TEI + BAAI/bge-large-zh-v1.5 |
| 智能体编排 | 把召回、过滤、生成 SQL、校验、执行串起来 | LangGraph |
把它们连成一句最容易记住的话,就是:
构建期用 MySQL + Qdrant + Elasticsearch + TEI 把元数据知识库建好,查询期再由 LangGraph 驱动问数智能体调用这套知识,最终生成并执行 SQL。