15 - 电商问数:API 接口基础与 FastAPI 入门
本章课程目标:
- 理解为什么问数智能体最后要封装成 HTTP API。
- 搭建一个最小可测试的
/api/query接口。 - 理解普通响应、流式响应和 SSE 协议之间的关系。
- 理解 FastAPI 的三个工程基础:
lifespan、middleware、Depends。 - 为下一章接入真实
QueryService做好准备。
学习建议: 这一章先学 API 骨架,不急着接入真实问数工作流。重点看请求怎么进来、响应怎么出去、为什么要流式返回、SSE 每段数据如何约定,以及 FastAPI 的路由、依赖、生命周期分别管什么。把这些基础看清,下一章再接 QueryService 时就不会觉得文件关系散。
对应代码分支: 15-api-streaming-basics
官方文档参考:
- FastAPI 流式响应:https://fastapi.org.cn/advanced/custom-response/#streamingresponse
- SSE 协议讲解:https://www.ruanyifeng.com/blog/2017/05/server-sent_events.html
- FastAPI 生命周期事件:https://fastapi.org.cn/advanced/events
- FastAPI 中间件:https://fastapi.org.cn/tutorial/middleware
- FastAPI 依赖注入:https://fastapi.org.cn/tutorial/dependencies
第 14 章结束后,问数智能体的核心链路已经能在后端内部跑通,但是,到这一步它还不是一个真正的应用。因为现在调用方式更像内部调试:开发者在命令行里运行图,观察日志和输出。真正交付给前端或其他系统时,需要把这条能力封装成一个 HTTP API。
本章只做第一步:先把 API 的基础形态和流式协议讲清楚。真正接入 QueryService 会放到下一章。
1、查询接口要解决什么问题
最终我们需要一个查询接口,接收前端提交的自然语言问题:
{
  "query": "统计华北地区的销售总额"
}
后端收到问题后,要调用前面已经搭好的 LangGraph 问数智能体,并把执行过程持续返回给前端。
这个接口至少要满足四个要求:
| 要求 | 说明 |
|---|---|
| 接收用户问题 | 前端通过请求体传入 query |
| 执行问数工作流 | 后端调用 graph.astream(...) |
| 实时返回进度 | 每执行到关键节点,就把进度推给前端 |
| 返回最终结果 | SQL 执行完成后,把查询结果返回给前端 |
这里最关键的是“实时返回进度”。问数智能体不是普通 CRUD 接口,它中间会经过多个步骤。如果后端等所有节点都执行完再一次性返回,用户只能看到页面一直转圈,不知道系统是在正常执行、卡住了,还是已经失败了。
更好的体验是:
正在抽取关键词...
正在召回字段信息...
正在召回指标信息...
正在生成 SQL...
正在执行 SQL...
查询完成这就是本章要引出的第一个核心概念:流式响应。
2、先搭一个最小 FastAPI 接口
FastAPI 是一个用于构建 API 服务的 Python Web 框架。简单说,它负责把 Python 函数暴露成 HTTP 接口,让前端、Apifox、Postman 或其他业务系统可以通过 URL 调用后端能力。
一个最小 FastAPI 应用大概长这样:
from fastapi import FastAPI

# 创建 FastAPI 应用对象,后续所有路由、中间件、生命周期事件都会注册到 app 上
app = FastAPI()

@app.get("/health")
async def health_check():
    # 返回普通 dict 时,FastAPI 会自动把它序列化成 JSON 响应
    return {"status": "ok"}
这里有三个关键信息:
| 代码 | 含义 |
|---|---|
app = FastAPI() | 创建 FastAPI 应用实例 |
@app.get("/health") | 声明一个 GET 接口 |
return \{"status": "ok"\} | 返回字典,FastAPI 自动转成 JSON |
本项目不会把所有接口都堆在 main.py 里,而是先按下面的结构拆开:
shopkeeper-agent/
├─ main.py
└─ app/
   └─ api/
      ├─ routers/
      │  └─ query_router.py
      └─ schemas/
└─ query_schema.py| 文件 | 职责 |
|---|---|
main.py | 创建 FastAPI 应用,并挂载路由 |
query_router.py | 定义查询接口,例如 /api/query |
query_schema.py | 定义请求体结构,例如 query: str |
2.1 定义请求体 QuerySchema
项目对应文件路径:shopkeeper-agent/app/api/schemas/query_schema.py
from pydantic import BaseModel

class QuerySchema(BaseModel):
    # 前端请求体中的 query 字段,用来承载用户输入的自然语言问题
    query: str
QuerySchema 的作用是告诉 FastAPI:当前接口的请求体里应该有一个字符串字段 query。
当前端发送:
{
  "query": "统计华北地区的销售总额"
}
路由函数里就可以通过 query.query 取出用户问题。这里两个 query 含义不同:
第一个 query:函数参数名,是 QuerySchema 对象
第二个 query:请求体字段名,是用户问题字符串
2.2 创建查询路由 query_router
项目对应文件路径:shopkeeper-agent/app/api/routers/query_router.py
本章先用 fake_streamer() 模拟流式输出,不接入真实问数智能体:
import asyncio

from fastapi import APIRouter
from starlette.responses import StreamingResponse

from app.api.schemas.query_schema import QuerySchema

# 当前模块只负责查询相关接口,后续接口变多时可以继续拆分其他 router
query_router = APIRouter()

async def fake_streamer():
    # 先用 10 个 step 模拟智能体执行过程,方便验证流式响应是否可用
    for i in range(10):
        # 暂停 1 秒只是为了观察流式效果;真实项目中这里会被节点执行耗时代替
        await asyncio.sleep(1)

        # SSE 消息以 data: 开头,并以两个换行符结尾
        # 客户端会把每次 yield 的内容识别为一条独立事件
        yield f"data: step:{i}\n\n"

@query_router.post("/api/query")
async def query_handler(query: QuerySchema):
    # query 参数会由 FastAPI 根据请求体自动解析成 QuerySchema 对象
    # StreamingResponse 会把 fake_streamer() 每次 yield 的内容持续写给客户端
    return StreamingResponse(fake_streamer(), media_type="text/event-stream")
这段代码先抓住两点。
第一,APIRouter 用来组织一组接口。虽然当前只有一个查询接口,也先放进 query_router,后续接口变多时不至于全部挤在 main.py 里。
第二,fake_streamer() 是一个异步生成器。它不是一次性 return 一个完整结果,而是每隔 1 秒 yield 一段内容。下一章接入真实智能体时,会把它替换成 QueryService.query(...)。
2.3 在 main.py 中挂载路由
项目对应文件路径:shopkeeper-agent/main.py
from fastapi import FastAPI

from app.api.routers.query_router import query_router

# 创建后端应用实例
app = FastAPI()

# 把 query_router.py 中定义的 /api/query 注册到应用上
# 如果没有这一行,/docs 页面里看不到该接口,客户端也访问不到它
app.include_router(query_router)
app.include_router(query_router) 很关键。如果只在 query_router.py 里定义了接口,但没有挂载到 app 上,FastAPI 应用并不知道这个路由存在。打开 /docs 时,也看不到 /api/query。
3、为什么查询接口要用流式响应
普通 HTTP 接口通常是这样的:
客户端发起请求
  -> 服务端处理完整逻辑
  -> 服务端一次性返回响应
如果用 Python 类比,普通响应更像 return:
async def query():
    result = await run_all_steps()
    return result
它的特点是:必须等所有逻辑执行完,客户端才能拿到响应。
流式响应更像 yield:
async def query_stream():
    yield "抽取关键词"
    yield "召回字段信息"
    yield "生成 SQL"
    yield "执行 SQL"
每 yield 一次,后端就可以向客户端写出一段内容。套到问数接口上,就是:
客户端提交问题
  -> 后端返回:抽取关键词
  -> 后端返回:召回字段信息
  -> 后端返回:生成 SQL
  -> 后端返回:执行 SQL
  -> 后端返回:最终结果
所以,流式响应解决的不是“能不能返回结果”的问题,而是“长流程执行过程中能不能持续给用户反馈”的问题。
4、流式响应:FastAPI 如何持续写出数据
官方文档参考:
- FastAPI 流式响应(StreamingResponse):https://fastapi.org.cn/advanced/custom-response/#streamingresponse
FastAPI 中实现流式返回,核心就是 StreamingResponse。官方文档中说明,StreamingResponse 可以接收生成器、异步生成器或其他可迭代对象,并把其中产出的内容持续写入响应。
本章示例里对应这段代码:
return StreamingResponse(
    # 传入异步生成器,StreamingResponse 会不断消费其中 yield 出来的内容
    fake_streamer(),
    # 声明为 SSE 事件流,客户端才会按流式事件来处理响应
    media_type="text/event-stream",
)
这里要注意三件事。
4.1 StreamingResponse 接收的是生成器
fake_streamer() 内部使用 yield:
async def fake_streamer():
    for i in range(10):
        # 放慢输出速度,方便在浏览器 Network 或 Apifox 中观察逐条返回
        await asyncio.sleep(1)

        # 每 yield 一次,后端就向客户端写出一条 SSE 消息
        yield f"data: step:{i}\n\n"
return 会结束函数,yield 会暂停函数,把当前内容先交出去,下一次还能继续执行。这个特性天然适合“边执行边输出”的问数工作流。
4.2 sleep 只是为了看清流式效果
示例中的:
await asyncio.sleep(1)不是业务逻辑,只是为了测试时能肉眼看到 step:0、step:1、step:2 一条一条返回。如果没有暂停,十条消息瞬间输出,看起来就像一次性返回。真实项目里,这个等待时间会被实际节点耗时代替,例如召回、调用大模型、执行 SQL。
4.3 media_type 要声明为 text/event-stream
这一行也很重要:
media_type="text/event-stream"它告诉客户端:这不是普通 JSON,也不是普通文本,而是一段 SSE 事件流。如果不声明这个类型,后端即使在持续写出数据,前端或接口测试工具也不一定会按事件流处理。
5、SSE 协议:前后端约定的流式格式
StreamingResponse 解决的是“服务端怎么持续写出响应”。SSE 解决的是“持续写出的文本应该是什么格式,前端才容易解析”。
SSE 全称是 Server-Sent Events,可以理解成“服务端向客户端持续发送事件”。它的交互方式是:
客户端发起一次 HTTP 请求
  -> 服务端保持连接
  -> 服务端持续发送多条事件消息
  -> 发送完成后关闭连接
这正好适合本项目:用户先提交一个问题,后续主要是服务端把执行进度和结果推回来。
5.1 SSE 和 WebSocket 怎么选
先看结论:当前项目的问题提交是一次性的,后续主要是后端持续返回进度和结果,所以 SSE 更贴合需求;WebSocket 更适合前后端都要持续主动发送消息的场景。

| 方案 | 特点 | 适合场景 |
|---|---|---|
| WebSocket | 双向通信,客户端和服务端都能持续发送消息 | 在线协作、聊天、游戏 |
| SSE | 主要是服务端持续向客户端推送消息 | 任务进度、日志流、模型输出流 |
本项目里,前端只需要先提交一次问题,后续接收服务端推送即可。因此用 SSE 更轻量,也更贴合当前需求。
5.2 SSE 的最小消息格式
SSE 消息本质上是 UTF-8 文本。最常见格式是:
data: 这里是要发送的内容注意一条消息后面要有一个空行,也就是两个换行符:
\n\n所以在 Python 中通常写成:
yield "data: step:0\n\n"如果要发送 JSON,也可以写成:
yield 'data: {"type": "progress", "step": "抽取关键词"}\n\n'下一章 QueryService 会使用类似写法:
yield f"data: {json.dumps(chunk, ensure_ascii=False, default=str)}\n\n"这行代码可以拆成三层理解:
data:        # SSE 的 data 字段
JSON 字符串  # 本项目自己的业务消息
\n\n         # 一条 SSE 消息结束
5.3 SSE 外层和 JSON 内层
本项目后续会把流式消息设计成几类:
| 类型 | 用途 | 示例 |
|---|---|---|
progress | 返回节点执行进度 | 抽取关键词、生成SQL |
result | 返回最终查询结果 | SQL 查询出的数据 |
error | 返回异常信息 | SQL 执行失败、模型调用失败 |
也就是说,外层是 SSE:
data: ...\n\n内层是项目自己的 JSON 协议:
{ "type": "progress", "step": "抽取关键词", "status": "running" }这层关系一定要分清:SSE 是传输格式,JSON 是业务内容。
6、测试最小流式接口
启动后端服务:
uv run fastapi dev main.py然后打开:http://127.0.0.1:8000/docs
如果能看到 POST /api/query,说明 query_router 已经成功挂载。
在 Swagger UI 中发送:
{
  "query": "test"
}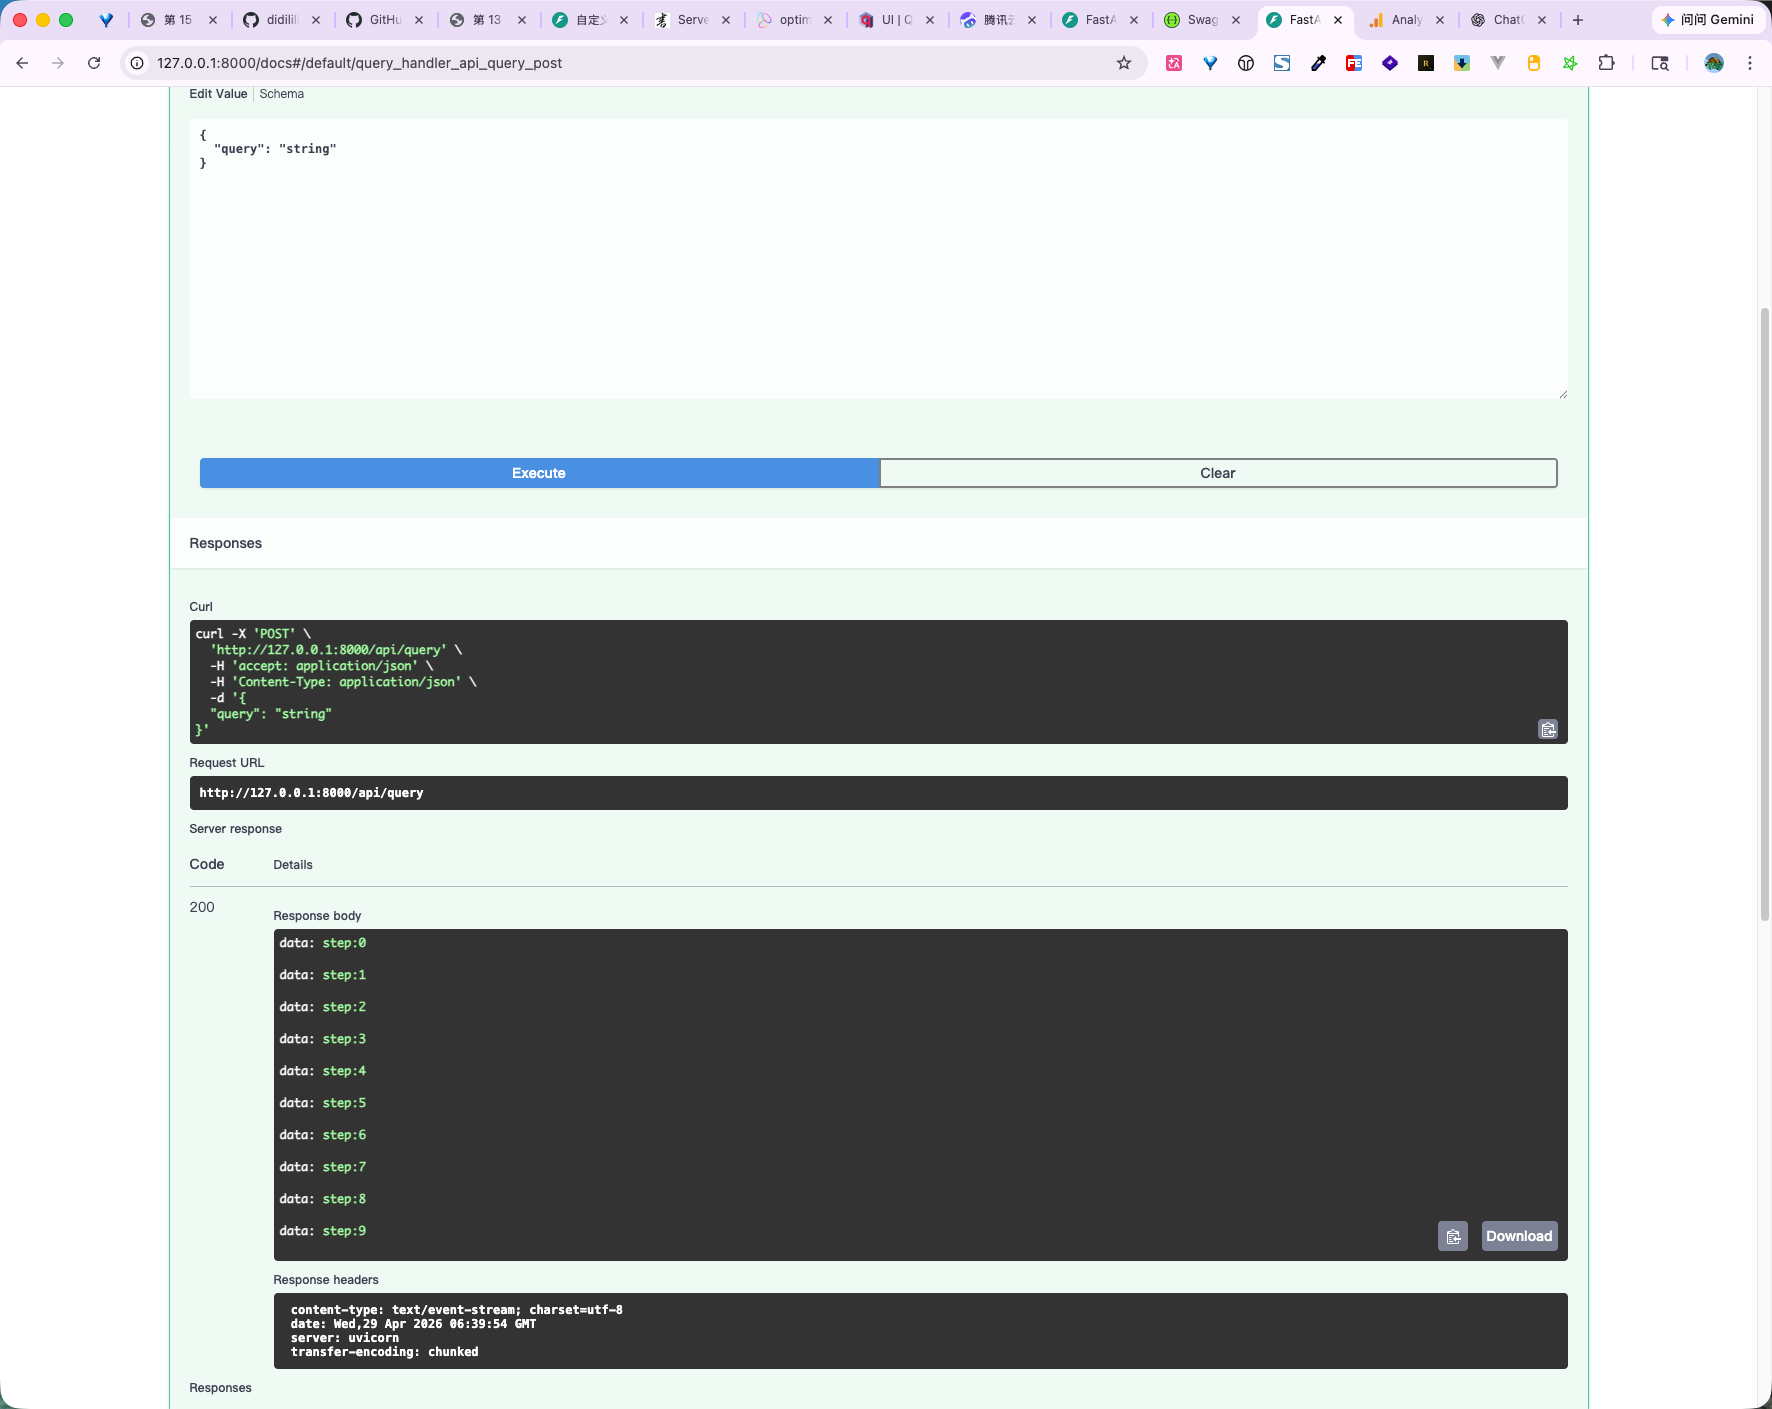
Swagger 中可能会发现页面一直 loading,等全部结束后才一次性展示完整结果。这不代表后端没有流式输出,只是 Swagger UI 通常不会逐条渲染 SSE。
想观察真实流式效果,可以用两种方式:
| 工具 | 观察方式 |
|---|---|
| 浏览器开发者工具 | Network 面板查看响应是否持续增长 |
| Apifox / Postman | 选择 POST /api/query,观察 SSE 是否一条条出现 |
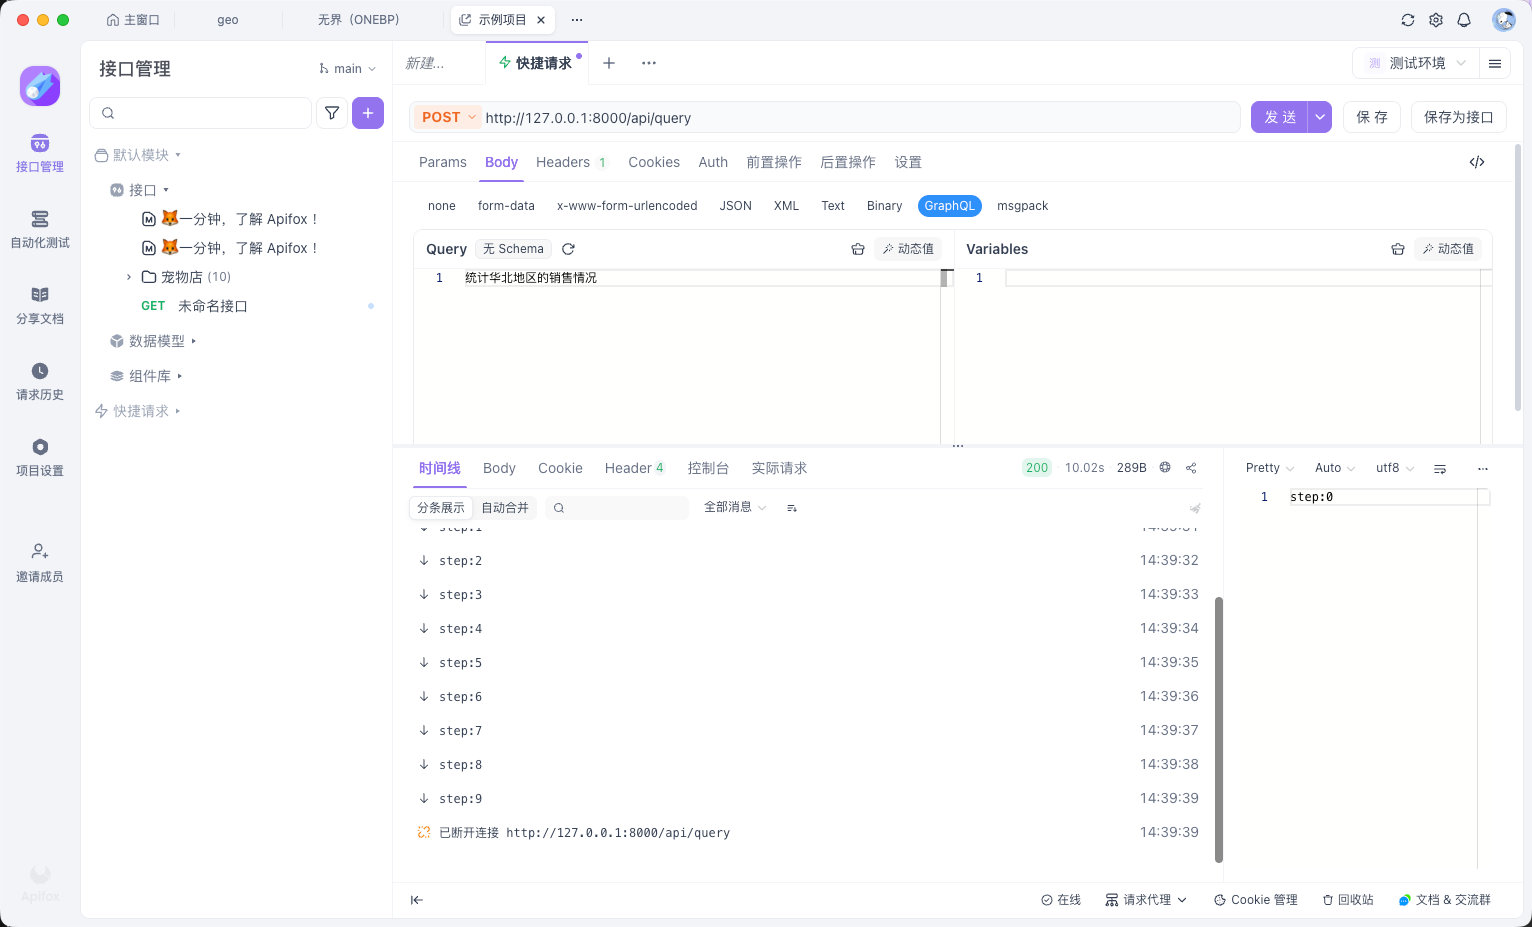
如果看到 step:0 到 step:9 大约每秒出现一条,就说明本章的最小流式接口已经跑通。
7、FastAPI 三件套:lifespan、middleware、Depends
前面已经把最小查询接口和流式协议跑通了。接下来再补三个 FastAPI 工程基础。
它们分别解决不同问题:
| 工程问题 | FastAPI 能力 | 本项目中的用途 |
|---|---|---|
| 应用启动和关闭时如何管理资源 | lifespan | 初始化和关闭外部客户端 |
| 每个请求前后如何统一执行逻辑 | middleware | 生成 request_id,辅助日志追踪 |
| 路由函数依赖的对象如何创建 | Depends | 组装 QueryService、Repository、Session |
这三个概念本章先理解到“各自管什么”就够了,具体代码会在后面两章展开。
7.1 lifespan:应用级资源什么时候初始化
FastAPI 的生命周期事件用于在应用开始接收请求前执行初始化逻辑,并在应用关闭时执行清理逻辑。现在推荐的写法是通过 FastAPI(lifespan=...) 传入一个异步上下文管理器。
为什么本项目需要它?因为问数接口依赖很多外部资源:
- Embedding 客户端;
- Qdrant 客户端;
- Elasticsearch 客户端;
- 元数据库 MySQL 连接;
- 数仓 MySQL 连接。
这些资源不应该每来一个请求就重新初始化一次。更合理的方式是:
应用启动时:
  -> 初始化客户端和连接能力

请求处理期间:
  -> 复用已经初始化好的客户端

应用关闭前:
  -> 统一释放连接
FastAPI 中的 lifespan 写法类似下面这样:
from contextlib import asynccontextmanager

from fastapi import FastAPI

@asynccontextmanager
async def lifespan(app: FastAPI):
    # yield 之前:应用启动时执行,适合初始化客户端、连接池等应用级资源
    init_clients()

    # yield 处:FastAPI 应用进入运行状态,开始接收和处理请求
    yield

    # yield 之后:应用关闭前执行,适合释放连接、关闭客户端
    await close_clients()

# 把生命周期函数交给 FastAPI,框架会在启动和关闭时自动调用
app = FastAPI(lifespan=lifespan)
可以先把 yield 理解成分界线:
yield 前:应用启动时执行
yield 后:应用关闭时执行
下一章会把真实代码写成:
@asynccontextmanager
async def lifespan(app: FastAPI):
    # 应用启动时初始化外部客户端,后续请求可以直接复用这些客户端
    qdrant_client_manager.init()
    embedding_client_manager.init()
    es_client_manager.init()
    meta_mysql_client_manager.init()
    dw_mysql_client_manager.init()

    # 应用运行期间停在这里,开始处理请求
    yield

    # 应用关闭前释放外部连接,避免连接泄漏
    await qdrant_client_manager.close()
    await es_client_manager.close()
    await meta_mysql_client_manager.close()
    await dw_mysql_client_manager.close()
7.2 middleware:所有请求都经过的统一逻辑
这里的中间件不是 Kafka、RabbitMQ 那类消息中间件,而是 Web 框架中的请求中间件。它可以理解成包在所有接口外层的一段逻辑。
一次请求大致会经过:
客户端请求
  -> 中间件前半段
  -> 路由处理函数
  -> 中间件后半段
  -> 客户端响应
FastAPI 中定义 HTTP 中间件的基本写法是:
from fastapi import Request

@app.middleware("http")
async def add_process_time_header(request: Request, call_next):
    # call_next 之前:请求还没有进入具体路由,适合做鉴权、打 request_id 等统一处理
    response = await call_next(request)

    # call_next 之后:路由已经生成响应,适合补充响应头、记录耗时等
    return response
这里两个参数很重要:
| 参数 | 含义 |
|---|---|
request | 当前请求对象,可以读取路径、方法、请求头等 |
call_next | 把请求继续交给后续路由处理函数 |
中间件适合放所有接口都需要的横切逻辑,例如:
- 统一鉴权;
- 统计请求耗时;
- 添加响应头;
- 记录访问日志;
- 为每个请求生成
request_id。
本项目第 17 章会用中间件为每次请求生成唯一 request_id,让并发日志可以按请求维度追踪。
7.3 Depends:声明“我需要什么”
依赖注入(Depends)可以先按字面理解:接口函数只声明自己需要什么对象,FastAPI 负责在请求到来时调用依赖函数,把对象创建好并传进来。
官方示例的简化写法如下:
from typing import Annotated

from fastapi import Depends, FastAPI

app = FastAPI()

async def common_parameters(skip: int = 0, limit: int = 100):
    # 依赖函数可以像普通函数一样接收参数、组织数据,并返回给接口使用
    return {"skip": skip, "limit": limit}

@app.get("/items/")
async def read_items(
    # Annotated[真实类型, Depends(依赖函数)]
    # 表示 commons 的类型是 dict,获取方式是调用 common_parameters
    commons: Annotated[dict, Depends(common_parameters)],
):
return commons这段代码里,read_items() 没有手动调用 common_parameters(),它只是声明:
我需要一个 commons
commons 的获取方式是 Depends(common_parameters)
请求进来时,FastAPI 会自动调用依赖函数。
放回本项目,查询接口最终会这样写:
@query_router.post("/api/query")
async def query_handler(
    # 请求体参数:FastAPI 会把 JSON 请求体解析成 QuerySchema
    query: QuerySchema,
    # 业务服务参数:FastAPI 会调用 get_query_service 来创建 QueryService
    query_service: Annotated[QueryService, Depends(get_query_service)],
):
    return StreamingResponse(
        # 下一章会把真实问数工作流封装到 query_service.query(...) 中
        query_service.query(query.query),
        media_type="text/event-stream",
    )
这表示:
query 来自请求体
query_service 来自 get_query_service 这个依赖函数
路由层不需要关心 QueryService 里面又依赖哪些 Repository、Session、Client。这些对象会交给下一章的 dependencies.py 分层组装。
8、依赖注入再往下看一层
上一节只讲了 Depends 的基本写法。本节再补两个后面马上会用到的特性:子依赖和带 yield 的依赖项。
8.1 子依赖
依赖可以继续依赖别的依赖。例如:
query_router
  -> QueryService
      -> MetaMySQLRepository
          -> meta_session
      -> DWMySQLRepository
          -> dw_session
      -> Qdrant / ES / Embedding client
FastAPI 会自动解析这棵依赖树。更重要的是,同一个请求里,如果多个依赖共用同一个子依赖,FastAPI 会做请求级缓存,不会在一次请求中重复创建同一个依赖对象。
注意这个缓存是请求级别,不是全局单例。每来一个新请求,依赖函数仍然会重新执行。
8.2 带 yield 的依赖项
数据库 Session 这类请求级资源,适合用带 yield 的依赖项:
async def get_meta_session():
    # 每次请求需要数据库 Session 时,先从 session_factory 创建一个请求级 Session
    async with meta_mysql_client_manager.session_factory() as meta_session:
        # yield 把 Session 交给 Repository 使用;请求结束后会回到这里并退出 async with
        yield meta_session
执行顺序可以理解为:
请求需要 meta_session
  -> 进入 async with,创建 session
  -> yield session 给 Repository 使用
  -> 请求结束
  -> 退出 async with,session 被关闭或归还
这里也要区分 lifespan 和带 yield 的依赖项:
| 对比项 | lifespan | 带 yield 的依赖项 |
|---|---|---|
| 生命周期范围 | 整个应用 | 单次请求 |
| 典型资源 | 客户端、连接池、全局配置 | 数据库 Session、请求级临时资源 |
| 本项目例子 | 初始化 Qdrant、ES、MySQL manager | get_meta_session()、get_dw_session() |
简单记:
lifespan 管应用级资源
yield 依赖项管请求级资源
本章小结:
/api/query不是普通 JSON 接口,而是一个需要持续返回执行过程的流式接口。- 本章先用
fake_streamer()验证 API 骨架和流式响应,下一章再接入真实QueryService。 - FastAPI 用
StreamingResponse承接异步生成器,每yield一次就向客户端写出一段内容。 - 本项目用 SSE 作为前后端流式协议,最核心格式是
data: xxx\n\n。 lifespan、middleware、Depends分别解决应用级资源管理、请求级统一逻辑、依赖对象组装问题。
下一章会正式把 fake_streamer() 替换成真实的 QueryService.query(...),让 /api/query 接到 LangGraph 问数工作流上。