1、训练资源问题的判断
1.1 从小模型练习到实际任务
前几章使用 Qwen3-0.6B 完成关键词抽取任务,学会了数据准备、训练和验证。现在继续用这个任务,考虑输入更长或模型更大时的资源需求。
假设现在要处理更长、专业词汇更多的文章。按第 32 章的方法检查后,发现小模型仍经常漏掉主题,就可以继续比较更合适的候选模型。
但这里有两件事需要分开:
- 回答是否更好: 用未参与训练的输入检查,比较关键词内容和格式。
- 当前机器能否训练: 看模型是否能加载、训练是否报错,以及需要多长时间。
本章集中解决第二个问题:判断资源是否够用,以及怎样调整。例如,模型已经加载,处理第一批文章时才报显存不足,先检查 batch 和实际长度;如果连权重都没加载完,就换一个排查方向。下面先把这两种情况分清,回答质量继续按第 32 章的方法比较。
1.2 区分加载失败、训练报错与速度过慢
启动训练后,程序要先加载模型、读取和处理数据,然后才进入计算损失、计算梯度、更新参数的训练过程。
同样一句“跑不动”,发生的位置不同,处理办法也不同:
| 看到的现象 | 先判断什么 | 优先检查 |
|---|---|---|
| 模型权重还没加载完,就出现显存不足 | 模型或加载过程是否放得下 | 模型路径、加载精度、GPU 已有占用 |
| 权重已加载,处理训练批次时显存不足 | 同时参与计算的数据是否太多 | 单卡 batch、实际序列长度、中间计算结果 |
| 前向和反向计算后,在参数更新时报错 | 更新参数所需空间是否不足 | 优化器状态、训练方式,必要时考虑卸载或分片 |
| step 持续增长,但每一步都很慢 | 单位时间实际完成了多少工作 | 样本数、速度、数据准备与卡间通信 |
| 训练结束,关键词仍不合要求 | 这不是单纯的显存问题 | 数据质量、模板、Adapter 加载与验证方法 |
OOM 是 out of memory 的缩写,意思是内存不足。这里看到的 CUDA out of memory,通常指 GPU 显存不够,不是硬盘满了。
第 31 章的 AutoDL 页面同时显示显存、系统内存和数据盘容量。它们分别用于 GPU 计算、CPU 侧运行和文件存储,不能直接互相替代。增加数据盘容量能多存模型文件,但不会让显卡多出计算空间。
1.3 先检查已有占用
假设一张 32 GB 显存的卡,另一个模型服务已经占用了其中一部分。此时训练报错,不一定说明目标模型本身无法在这张卡上训练。
在 AutoDL 的 JupyterLab 中另开一个终端,执行:
nvidia-smi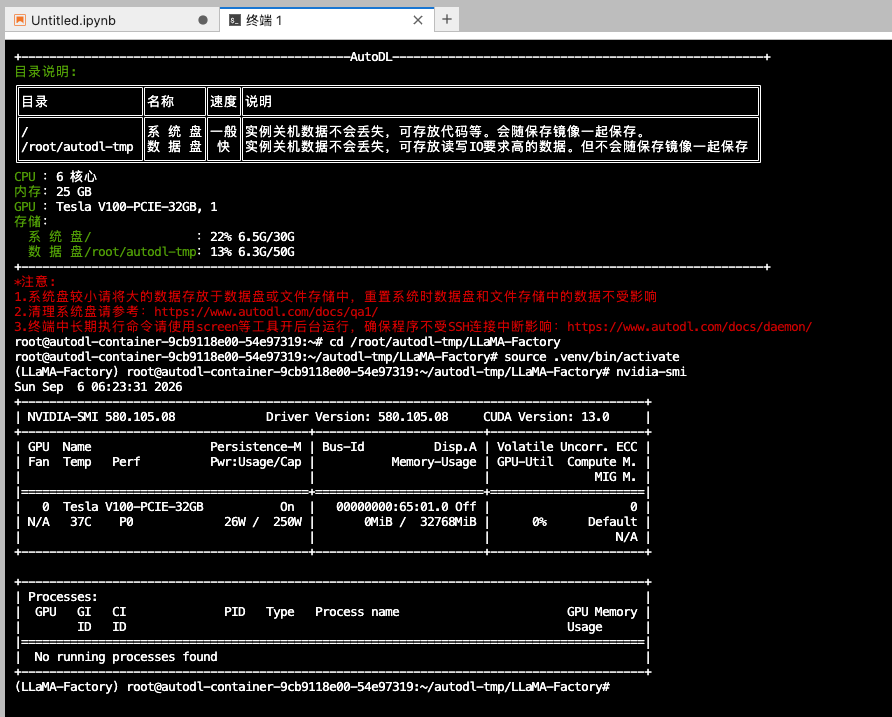
按从上到下的顺序看这张图:
- GPU 型号:
Tesla V100-PCIE-32GB,先确认程序看到的是哪张卡。 - Memory-Usage:
0MiB / 32768MiB,斜线前是此刻已用的显存,后面是总容量。 - Processes:
No running processes found,表示这次检查没有列出正在使用 GPU 的进程。
这张图展示空闲状态。如果自己的页面已有明显占用,就继续核对它来自哪个任务。
容器中有时会出现“显存已有占用,但进程列表没有列出任务”的情况。因此还要结合上方的显存读数和训练日志判断,不能仅凭 No running processes found 就认定 GPU 空闲。
若之前在 LLaMA-Factory 的 Chat 页加载过模型,先点击该页的 “卸载模型”。仍在运行的训练与推理服务,要先确认是否可以结束,再按第 5.6 节选择对应的停止方法;不能只关闭网页。
排除额外占用之后,再调整训练设置。这样才能分清,是同一张卡上任务太多,还是当前训练本身确实需要更多显存。