5、模型合并与导出
5.1 从 Adapter 到完整模型
第 30 章解释过:LoRA 训练的主要产物是新增的权重,通常保存为:
adapter_config.json        # Adapter 配置与基础模型信息
adapter_model.safetensors  # LoRA 增量权重
这两个文件需要对应的基础模型一起工作。第 31 章的示例 Adapter 约 20 MB,并不是把完整 Qwen 模型压缩到了 20 MB。
Chat 页面已经帮我们把两者一起加载。若希望另一个程序只指定一个模型目录,可以把增量合并进基础权重,导出完整模型:
导出前:Qwen3-0.6B 基础模型 + keywords-clean Adapter
导出后:keywords-clean-merged/ 完整模型目录
导出会另外生成合并后的模型文件,原 Adapter 仍可保留使用。基础模型与 Adapter 分开加载的服务路线见第 6.5 节。
5.2 导出配置与操作
在本地编辑器中查看导出配置 案例与源码-4-微调/configs/keywords_clean_export.yaml,核对:
| 配置项 | 值 | 用途 |
|---|---|---|
model_name_or_path | Qwen/Qwen3-0.6B | 训练时的基础模型 |
adapter_name_or_path | saves/Qwen3-0.6B-Thinking/lora/keywords-clean | 本次选定的 Adapter |
template | qwen3_nothink | 沿用本次对话模板 |
export_dir | /root/autodl-tmp/exports/keywords-clean-merged | 保存完整模型的新目录 |
export_device / infer_dtype | cpu / float16 | 在 CPU 上完成导出,设置权重数据类型 |
export_size | 2 | 单个权重分片的大小上限,配置按 GB 表示 |
export_legacy_format | false | 使用 safetensors,不导出旧格式 |
分片就是把较大的权重拆成几个文件保存。export_size: 2 设置每个分片的大小上限,超过时工具会把权重分到多个文件;加载时仍使用整个目录。
在 WebUI 的 **Export(导出)**页,可以找到最大分块大小、导出设备、旧格式和目录等对应选项。本次不做导出量化,也不填写自动上传到 Hugging Face 的仓库信息;导出设备为 CPU,不表示以后只能用 CPU 推理。
先通过 JupyterLab 文件面板,将本机的 案例与源码-4-微调/configs/keywords_clean_export.yaml 上传到云端 /root/autodl-tmp/LLaMA-Factory/configs/。如果云端已有自己的同名配置,先打开核对,不要直接覆盖。确认 adapter_name_or_path 指向自己要导出的 Adapter,export_dir 是尚未使用的新目录。
在 Chat 页卸载模型后,在 AutoDL 终端执行:
cd /root/autodl-tmp/LLaMA-Factory
source .venv/bin/activate
USE_MODELSCOPE_HUB=1 llamafactory-cli export configs/keywords_clean_export.yaml
CPU 导出仍需要内存和磁盘空间。开始前确认目标目录尚不存在;已有同名目录时换一个导出目录,避免新旧文件混在一起。使用 WebUI 导出,也按上表核对基础模型、Adapter 和选项。
5.3 查看导出文件
日志提示导出成功后,在 AutoDL 执行:
ls -lh /root/autodl-tmp/exports/keywords-clean-merged下面是课程示例的完整导出目录,包含 7 个文件:
keywords-clean-merged/
├── config.json                 # 模型配置
├── model.safetensors           # 合并后的完整权重
├── generation_config.json      # 生成配置
├── tokenizer.json              # 分词器文件
├── tokenizer_config.json       # 分词器配置
├── chat_template.jinja         # 保存的对话模板
└── Modelfile                   # 工具生成的附加模型配置
示例 model.safetensors 约 1.19 GB,文件内的权重类型为 FP16,没有拆成多个分片。其他模型可能生成多个 model-00001-of-...safetensors 及权重索引文件,它们是一份模型的不同部分,不是多个可以单独使用的模型。复制时不要遗漏分片或索引。
保存到本机时,下载整个目录或完整压缩包,不只保留权重文件。按第 31 章的备份方法检查压缩包大小、SHA-256 和包内文件;确认模型配置、分词器及所有权重都已保存。
第 28 章介绍模型目录时见过权重、配置与分词器;这里保存的已经是合并后的模型。目录存在只能证明创建过位置,还应检查导出日志,并实际加载一次。
5.4 独立加载合并模型
回到 Chat 页,按下面顺序操作:
- 卸载当前模型。
- 将模型路径改为
/root/autodl-tmp/exports/keywords-clean-merged。 - 清空检查点路径,不再选择 Adapter。
- 保持
qwen3_nothink、float16与第 2 节的生成设置,关闭思考模式。 - 加载模型、清空历史,提交第 2 节同一条验证输入。
这里清空检查点,是因为合并目录已经包含本次 LoRA 的修改,不应再次叠加同一 Adapter。
检查时先确认:模型能否只凭这个完整目录加载,能否正常生成回答。再对照合并前的结果,检查格式与关键词;如果出现差异,先核对输入、模板、历史和生成设置,不直接认定合并失败。不同数值实现也可能导致输出差异。
独立加载的对照示例: 使用前三条验证输入,保持模板、生成设置和 FP16 精度一致。加载配置只指定合并目录,不再填写 adapter_name_or_path,再比较合并前后的回答:
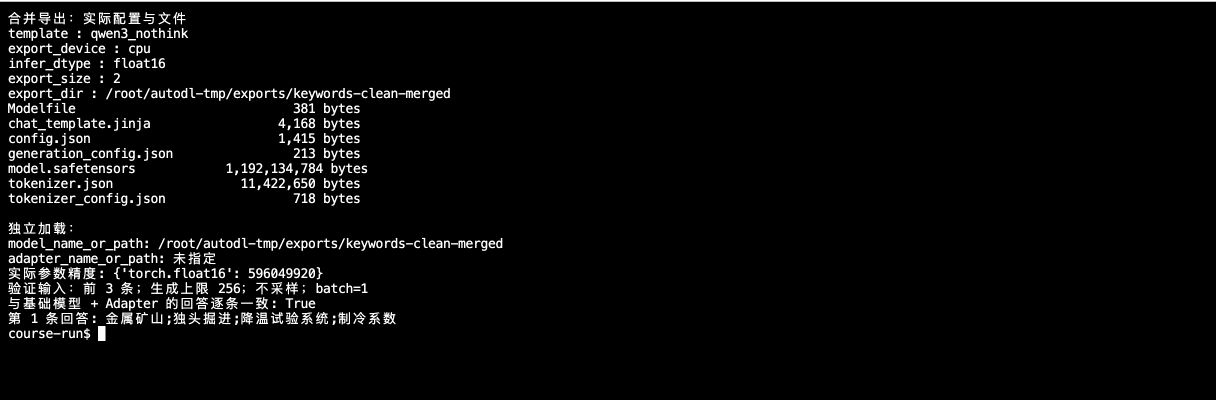
三条输入均正常生成,回答与合并前逐条一致。第 2 节那条矿山文章的回答仍是:
金属矿山;独头掘进;降温试验系统;制冷系数这三条回答说明示例的合并目录可以独立加载,并保留了合并前的表现;第 4 节发现的漏词问题也仍存在。合并解决的是权重组织和交付问题,不会自动修复任务错误。