7、LoRA 训练参数配置
模型、模板和数据选好后,填写 训练页主参数、其它参数设置、LoRA 参数设置 三处;RLHF、多模态等区域保持默认。第 30 章已解释取值原因,这里照位置填写,最后在第 8.1 节确认设置确实传给程序;各处完整字段表供查阅。
7.1 训练方式与输出目录
沿用第 5 节的模型设置:SFT、LoRA、量化等级 none、qwen3_nothink,关闭思考模式。模型显示名保留 Qwen3-0.6B-Thinking,输出目录填写 keywords-clean;按这个显示名与微调方法,结果路径应为:
saves/Qwen3-0.6B-Thinking/lora/keywords-clean若该目录已经存在,换一个新实验名,并同步更改后续预测、导出配置里的 Adapter 路径。仅想重新打开日志时,不要再次点“开始”。
本轮从基础模型新建 Adapter,因此上方“检查点路径”留空,不选择过去的训练结果。加载已有 Adapter 和从中断位置续训是另外的操作,不混入这次首次训练。
7.2 独立验证集配置
训练页填写:
| 页面项目 | 值 |
|---|---|
| 数据路径 | data/keywords-clean |
| 数据集 | 只选 keywords_train |
| 最大样本数 | 1600 |
| 验证集比例 | 0 |
这里有两处设置需要配合:主页面的“验证集比例”设为 0,表示不再从训练数据中切分;独立验证文件则在“额外参数”中指定。展开 其它参数设置,找到右侧的 额外参数 JSON 输入框,用下面完整内容替换原来的 \{"optim": "adamw_torch"\},不要在已有大括号后再拼一段:
{
  "optim": "adamw_torch",
  "preprocessing_num_workers": 4,
  "eval_dataset": "keywords_validation",
  "val_size": 0,
  "eval_strategy": "steps",
  "eval_steps": 50,
  "per_device_eval_batch_size": 4,
  "load_best_model_at_end": true,
  "metric_for_best_model": "eval_loss",
  "greater_is_better": false
}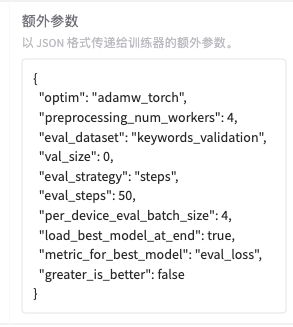
这张局部截图对应上面的整个 JSON 输入框。填好后,先找到 eval_dataset 和 eval_steps 两行,分别核对验证文件的登记名与检查间隔;最终是否传给训练程序,还要看第 8.1 节的命令预览。
每 50 步在这 200 条验证数据上计算损失,并按较低的验证 Loss 选择检查点。它只是候选选择依据,不代表关键词内容一定更好;下一章还会检查实际回答。
<details> <summary>查阅:额外参数中各字段的含义</summary>按字段逐项对照:
| 中文名称与配置字段 | 本次取值 | 在这次训练中做什么 |
|---|---|---|
优化器optim | adamw_torch | 使用 PyTorch 的 AdamW 更新参数 |
数据预处理进程数preprocessing_num_workers | 4 | 使用 4 个进程处理数据,区别于一次训练几条样本 |
验证集eval_dataset | keywords_validation | 从登记表找到 200 条验证数据 |
自动验证划分val_size | 0 | 不再从 1,600 条训练数据中额外划分 |
验证策略eval_strategy | steps | 按参数更新步数安排验证 |
验证间隔eval_steps | 50 | 每完成 50 个更新步,运行一次验证 |
| 单卡验证批次 <code style="white-space: normal; overflow-wrap: anywhere;">per_device_eval_batch_size</code> | 4 | 每张卡验证时每批处理 4 条,与训练批次分别设置 |
结束时加载最佳检查点load_best_model_at_end | true | 训练结束后加载选中的最佳检查点 |
最佳检查点的比较指标metric_for_best_model | eval_loss | 使用验证损失比较候选检查点 |
指标是否越大越好greater_is_better | false | 本例验证损失越小越好 |
已有独立 eval_dataset 时,val_size 必须为 0;eval_dataset 与非零 val_size 同时出现会报错。这里配置的是训练期间验证;“评估与预测”标签页是单独的操作入口。WebUI 参数合并、数据参数约束。
7.3 批次、学习率与训练轮次
先按第 6.3 节只选择 keywords_train,再填写 Train 页直接显示的参数。下面将同一张真实截图分区放大,按从上到下的顺序核对;窄屏可在图内横向滚动。
先看学习率、训练轮数、随机种子、最大样本数和计算类型。
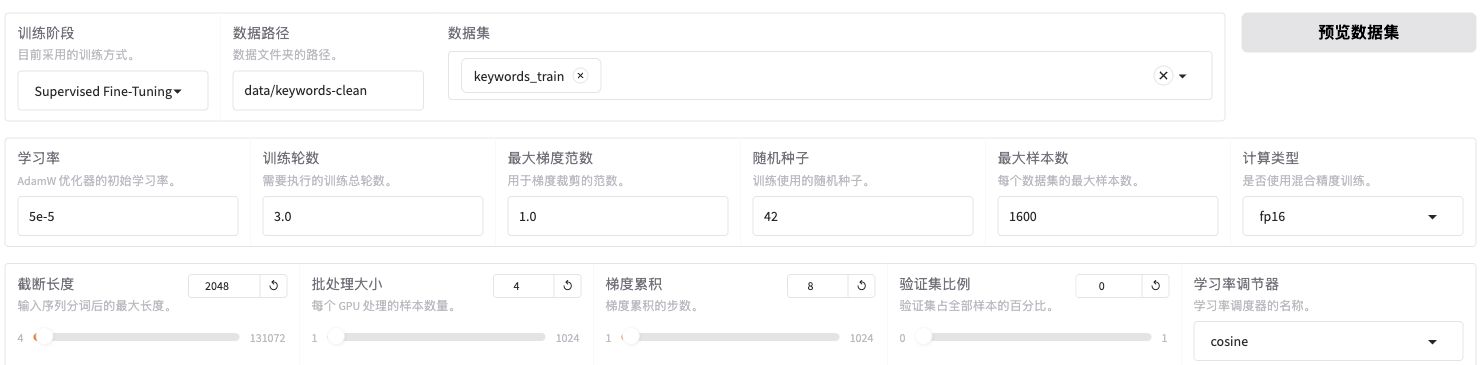
再看长度、批次、梯度累积、验证比例和调度器。
查看完整训练参数截图,确认数据路径为 data/keywords-clean,训练集为 keywords_train。
照图填写时,用这张短表核对数值:
| 页面区域 | 本次填写 |
|---|---|
| 学习率、轮数、随机种子、最大样本数、计算类型 | 5e-5、3、42、1600、fp16 |
| 截断长度、批次、累积、验证比例、调度器 | 2048、4、8、0、cosine |
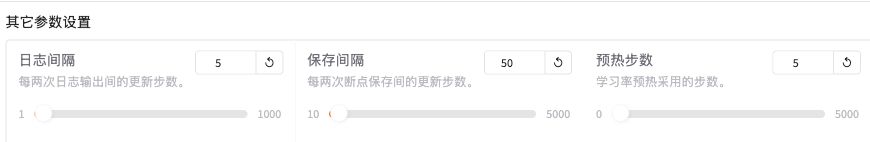
| 其它参数中的日志间隔、保存间隔、预热步数 | 5、50、5 |
需要查看英文键名或复习用途时,再展开对应表。
<details> <summary>查阅:页面主参数与 YAML 字段对应关系</summary>| WebUI 项目与配置字段 | 本轮值 | 含义 |
|---|---|---|
截断长度cutoff_len | 2048 | 输入和答案组成的训练序列最多保留 2,048 个 token |
| 单卡 batch <code style="white-space: normal; overflow-wrap: anywhere;">per_device_train_batch_size</code> | 4 | 每张卡每个小批次处理 4 条 |
| 梯度累积 <code style="white-space: normal; overflow-wrap: anywhere;">gradient_accumulation_steps</code> | 8 | 每累积 8 批更新一次,有效批次为 32 |
学习率learning_rate | 5e-5 | 控制参数更新步长,本例作为预热结束时的学习率 |
训练轮数num_train_epochs | 3 | 训练集学习 3 遍 |
随机种子seed | 42 | 控制本轮训练中的随机初始化、打乱等过程 |
计算类型fp16、bf16 | fp16 | 对应 fp16: true、bf16: false,使用 FP16 混合精度 |
学习率调度器lr_scheduler_type | cosine | 预热后按余弦曲线降低学习率 |
预热步数warmup_steps | 5 | 前 5 个更新步逐步提高学习率 |
日志间隔logging_steps | 5 | 每 5 个更新步记录一次日志 |
保存间隔save_steps | 50 | 每 50 个更新步保存一次,与验证间隔一致 |
日志间隔、保存间隔和预热步数在 其它参数设置 中,不在上方的主参数行。按下图填写 5 / 50 / 5:
当 1,600 条训练样本都被保留,且不启用打包时:1600 ÷ 4 ÷ 8 = 50 步/轮,3 轮预计 150 步。这是根据配置计算的预期,最终还要核对实际预处理条数和启动日志。
随机种子可以理解为控制随机过程的一个编号,本轮记下 42 即可。第 29 章的数据划分已经写进文件,改变这里的种子不会重新划分三份数据;相同种子也不能保证不同硬件和软件版本得到逐位相同的结果。
若训练时显存不足,按第 8.5 节的告警说明区分发生阶段,再参考第 33 章处理。
7.4 LoRA 与其他选项
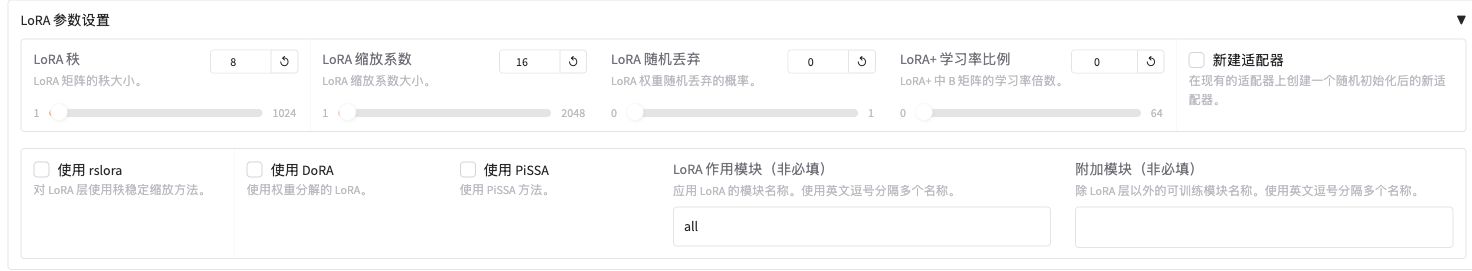
展开 LoRA 参数设置。下图上方的 rank、alpha 和 dropout 分别填 8、16、0;下方左侧是作用模块,右侧是附加模块。本次只在作用模块中填 all,附加模块留空。
| 页面项目与配置字段 | 本轮值 | 作用 |
|---|---|---|
LoRA 秩lora_rank | 8 | 设置新增分支的中间宽度 |
LoRA 缩放系数lora_alpha | 16 | 配合 rank,按 alpha/r 缩放分支结果 |
LoRA 随机丢弃lora_dropout | 0 | 不随机丢弃分支输入 |
LoRA 作用模块lora_target | all | 在工具识别的适用线性层添加分支,以预览为准 |
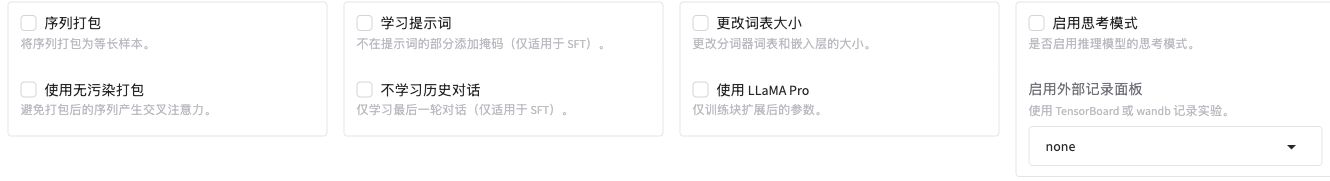
序列打包packing | false(关闭) | 不把多条短样本打包成一条训练序列 |
学习提示词train_on_prompt | false(关闭) | 用户输入用于提供上下文,不作为预测目标计入损失 |
思考模式enable_thinking | false(关闭设置) | 实际处理取决于模板;本轮训练答案不含思考正文 |
实验报告平台report_to | none(不启用) | 不向外部平台上报,训练日志仍保存到本地 |
“附加模块”留空;LoRA 变体、量化、DeepSpeed 和 offload 本轮不启用。RoPE 缩放保持 none,加速方式保持 auto。
all 填在作用模块,不是附加模块。当前页面若把空的作用模块解释为默认 all,仍要核对预览中的 lora_target。量化等级为 none 时,旁边出现 bnb 不表示已经使用 QLoRA。
回到 其它参数设置,确认“序列打包”“学习提示词”和“启用思考模式”都没有勾选。对话模板选了 qwen3_nothink 后,也要单独检查思考模式开关。