5、模型与对话模板配置
5.1 模型与微调方式
在 WebUI 的训练页面,按本课程的第一轮练习选择:
| 页面项目 | 本课程选择 |
|---|---|
| 模型名称 | 搜索 Qwen3-0.6B;本章界面示例中的选项叫 Qwen3-0.6B-Thinking |
| 模型路径 | 先确认是 Qwen/Qwen3-0.6B;下载后也可以填本地模型目录 |
| 模型来源 | ModelScope |
| 训练阶段 | SFT(监督微调) |
| 微调方法 | LoRA |
| 量化等级 | 不开启 |
“模型名称”是 WebUI 的显示名,下载用的仓库 ID 是 Qwen/Qwen3-0.6B。模型路径决定加载什么权重,对话模板决定怎样组织消息;模板在下一小节设置。
下图只截取页面上方的模型设置。按三行核对:第一行看模型名称、仓库 ID 和 ModelScope;第二行选 LoRA,检查点路径留空;第三行不开量化,并选择下一小节要用的 qwen3_nothink 模板。
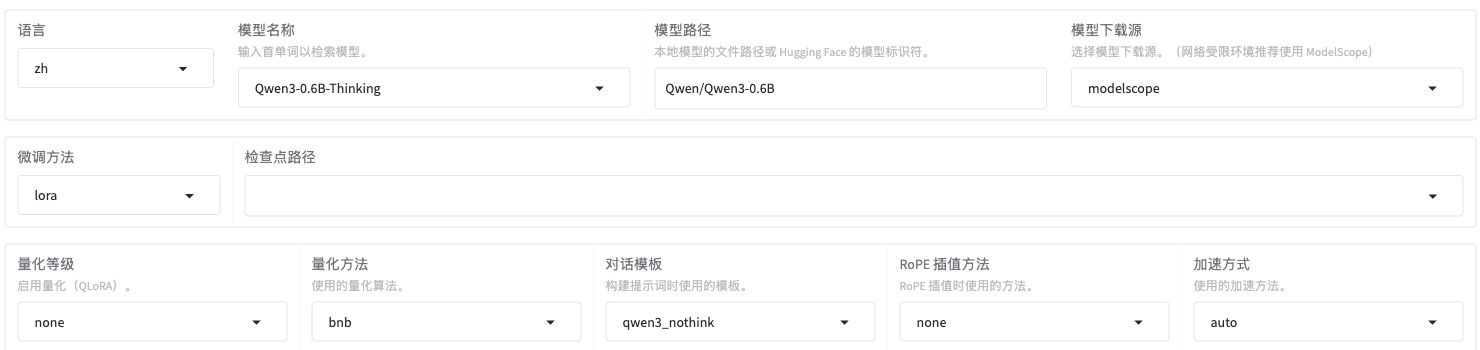
V100 使用的 fp16 位于 Train 页的“计算类型”,第 7.3 节会和批次等参数一起填写,不在上面这三行中。
选择 ModelScope 作为下载来源后,可以按下面的方法提前下载模型,也可以在首次正式加载时由工具下载。
本步骤也可以在无卡模式下完成。先按第 3 节装好环境,在 AutoDL 的 JupyterLab 终端中执行:
cd /root/autodl-tmp/LLaMA-Factory
source .venv/bin/activate
df -h /root /root/autodl-tmp
下面的下载命令使用 ModelScope 默认缓存,通常位于系统盘 /root/.cache/modelscope/。先确认系统盘还有下载空间,再执行整段命令:
python - <<'PY'
from modelscope import snapshot_download

model_dir = snapshot_download("Qwen/Qwen3-0.6B")
print("模型下载目录:", model_dir)
PY
snapshot_download 下载模型仓库文件并返回本地目录,已有的同版本缓存会复用。ModelScope 下载接口
下载完成后,终端会打印「模型下载目录」。在 JupyterLab 文件面板中打开这个目录,确认有 config.json、权重文件和 tokenizer 文件。记下实际返回的路径:第 29 章打印模板、第 30 章检查预处理结果时,都需要它。
缓存仍在默认位置时,WebUI 和课程 YAML 可以继续填写仓库 ID Qwen/Qwen3-0.6B。如果需要把已下载的模型移到数据盘,接着看第 5.3 节;更换为 8B 等大模型前,应另行规划数据盘下载位置,不直接照用这个小模型的默认缓存方案。
5.2 对话模板与思考模式
第 29 章已经用图书馆示例解释了对话模板,并对照了模型路径与模板选项。这里把设置用于关键词训练:
| 页面项目 | 本次设置 |
|---|---|
| 对话模板 | qwen3_nothink |
| 思考模式 | 关闭,对应 enable_thinking=False |
关键词样本的助手答案只有关键词,不包含推理过程,因此本次训练不提供思考正文作为示范。模型显示名中的 Thinking 并不会替我们完成这些设置,仍要单独核对模板和思考开关。没有训练思考正文,不保证模型回答时一定不分析。 本版本 qwen3_nothink 不会因这个开关补入空思考区块;生成阶段的实测区别见第 32 章第 2.4 节。
消息边界与 <think> 标签的处理见第 29 章的模板说明,参与损失计算的位置见第 30 章的训练标签。
换模型或重新打开页面后,都要确认模板没有变回默认值。下一章先沿用这组设置复现已有结果,再单独阅读模板推理对照。如果当前版本找不到 qwen3_nothink,先回第 3 节核对工具版本,不用另一个相似名称代替。
5.3 本地模型路径(选读)
第一次使用仓库 ID 时,可以先保持上面的设置,不必提前移动尚未下载好的模型。只有模型已经下载完成、当前没有任务正在加载它,而且你需要把系统盘缓存整理到数据盘时,才做本节操作。
先在 JupyterLab 文件面板或终端检查两个位置:
ls -ld /root/.cache/modelscope/models
ls -ld /root/autodl-tmp/models
第一条应找到已下载的缓存目录;第二条若提示不存在,才符合下面这条移动命令的前提。两个目录都存在时,不要继续照抄移动命令,先查看已有内容。
确认源目录存在、目标目录不存在后执行:
mv /root/.cache/modelscope/models /root/autodl-tmp/这样会得到:
/root/autodl-tmp/models/这会移动整个 models/ 缓存目录。之后训练配置要改用移动后的本地路径。
在 models/ 下继续打开 Qwen3-0.6B 的目录,找到同时包含权重、config.json 和 tokenizer 文件的那一层。例如目录结构可能是:
/root/autodl-tmp/models/Qwen--Qwen3-0.6B/snapshots/master/
├── config.json
├── model.safetensors
├── tokenizer.json
└── tokenizer_config.json
模型路径就填这个同时包含配置、权重和 tokenizer 的目录。 它是权重文件的父目录,不是这个目录的上一层。缓存版本不同,外层目录名可能不同,以文件面板里实际存在的内容为准。
注意,在左侧文件面板里双击文件夹,不会改变已经打开的终端目录。若你的模型确实位于上面的示例位置,要在 AutoDL 终端单独执行 cd:
cd /root/autodl-tmp/models/Qwen--Qwen3-0.6B/snapshots/master
pwd
ls config.json tokenizer_config.json
路径不同时,把 cd 后的地址换成文件面板中找到的实际目录。确认 cd 成功,且 ls 找到了配置文件后,再把 pwd 的完整输出粘贴到 WebUI 的模型路径中;若 cd 报错,终端仍停留在原位置,此时不要复制 pwd。不要只复制到 models/ 的总目录,也不要复制到单个 model.safetensors 文件。
原来填 Qwen/Qwen3-0.6B 时,工具按仓库 ID 找模型;现在填完整本地目录时,工具从这个目录读文件。不要把本地路径填到“检查点路径”中,那里留给稍后训练出的 Adapter。
移动后如果仍填写仓库 ID,工具可能在默认缓存处重新下载一份。采用本地路径时,要同时修改训练 YAML 的 model_name_or_path,后续预测、导出也使用同一份模型;不能只改页面而仍运行旧 YAML。
不需要整理缓存位置时,继续使用仓库 ID 即可,跳过本节的移动操作。
使用仓库 ID 时,模型会从已下载的缓存加载;课程示例对应 /root/.cache/modelscope/models/Qwen--Qwen3-0.6B/snapshots/master。若改用数据盘的本地模型目录,后续训练、预测和导出也应指向同一份基础模型。