9、训练日志与检查点
本节先掌握: 看训练进行到哪里、验证结果是否改善、产物保存在哪里。训练 Loss 下降后,还要检查实际生成的关键词。
配置决定预期,日志告诉我们实际发生了什么。下面使用 keywords-clean 数据的一次 150 步训练作为示例:本章学习读日志,第 31 章学习怎样运行,第 32 章再检查对应 Adapter 的回答。
先按时间顺序看三个位置:第 5 步出现一条训练日志,第 50 步完成第一轮并验证、保存,第 150 步完成三轮,再按验证结果选择检查点。 下面的日志、曲线和文件列表,就按这条顺序来读。
9.1 阅读一条训练日志
训练启动后,界面日志区或终端会先列出训练安排。下面摘取示例日志中的关键字段,省略时间和日志前缀:
Num examples = 1,600
Num Epochs = 3
Instantaneous batch size per device = 4
Total train batch size (w. parallel, distributed & accumulation) = 32
Gradient Accumulation steps = 8
Total optimization steps = 150
先找到 Num examples = 1,600、Num Epochs = 3 和 Total optimization steps = 150,就能与第 2 节的计算对应起来。有效批次对应 Total train batch size = 32;进度条中的 21/150 则表示已经完成 21 个更新步。
在示例的 trainer_state.json 中,第 5 步包含以下信息。这里只摘取四个字段,Loss 保留四位小数:
{
  "step": 5,
  "epoch": 0.1,
  "loss": 4.1185,
  "learning_rate": 0.00004
}| 字段 | 这条记录表示什么 |
|---|---|
step: 5 | 已完成 5 个参数更新步 |
epoch: 0.1 | 第一轮约完成 10%;本轮每轮 50 步,5 ÷ 50 = 0.1 |
loss: 4.1185 | 最近记录区间内汇总的训练损失 |
learning_rate: 0.00004 | 第 5 次更新使用的学习率,即 4e-5 |
本次 logging_steps: 5,表示每 5 个更新步记录一次。结合梯度累积 8,可以把它读成:正常情况下处理 40 个小 batch 后,出现下一条训练损失记录。
若只把日志间隔从 5 改成 10,正常记录点会从 5、10、15……变成 10、20、30……,每条训练 Loss 的汇总区间也随之改变。更新参数的次数没有因此减半,只是观察得更稀疏了。日志点少,可能漏掉短暂波动;不要把记录点更少、曲线看起来更平滑误读成模型学得更稳。
</details>读到这里,先确认进度在增长、Loss 为有效数值、学习率按预热与衰减安排变化。某一步的精确记录时序需要时再查。
<details> <summary>查日志时再看:预热第 5 步的学习率为什么是 4e-5</summary>配置是 5e-5,第 5 步为什么记录 4e-5? 本轮使用 5 步预热,日志记录本次更新所用的学习率。开始第 5 次更新前,调度器已推进 4 次,所以学习率为 5e-5 × 4/5 = 4e-5;这次更新完成后,调度器才推进到 5,为下一次更新准备 5e-5。这是本轮 Transformers 5.8.0 的记录与调度顺序。
日志还可能带有 grad_norm,它是梯度整体大小的一个汇总量,可用于排查梯度异常。
遇到异常时,先分清是哪一种。 可以按下面的现象选择检查方向:
| 看到的现象 | 首先检查什么 |
|---|---|
| Loss 在有限数值之间上下波动 | 结合多个记录点与验证表现判断;不同批次难度不同,一次上升不能证明训练失败 |
Loss 或梯度反复出现 NaN、Inf | 保留首次异常附近的日志和配置,检查数据、有效答案标签、学习率与计算精度;不要靠增加 epoch 解决 |
grad_norm 偶尔很大 | 对照异常批次和前后记录;这个数受模型、数据和统计方式影响,没有跨任务通用的正常阈值 |
报错包含 CUDA out of memory | 按第 33 章的报错阶段检查显存占用;它与数值变成 NaN 是不同问题 |
NaN 表示运算没有得到有效数值,Inf 表示无穷值,可能与数值溢出等问题有关。先回看第 4.2 节的实际输入、截断后答案及 labels,确认仍有参与计算的答案位置;再核对精度与原配置。保留出问题的版本,每次只改变一个候选因素,才能判断哪项处理有效。若异常持续,应停止本次运行后排查,不把保存出的权重直接作为有效结果。
梯度裁剪是在更新参数前,限制梯度整体大小的一种方法。以本课普通单卡训练使用的范数裁剪为例,当梯度整体大小超过 max_grad_norm 时,程序按比例缩小梯度;它限制的是梯度,不是把 Loss 压到这个数值。
本课 Transformers 5.8.0 的 grad_norm 记录来自裁剪前的范数。因此,假设阈值为 1.0、日志显示 4.0,并不说明裁剪没有生效。这里的数字是教学示例;裁剪与记录顺序可查对应版本源码。
FP16 的数值表示范围有限。混合精度训练通常使用梯度缩放,先放大损失以减轻很小的梯度下溢,再在更新前还原梯度的尺度;它与裁剪处理的环节不同,也不能修复错误数据或保证任何模型都适合 FP16。精度排查仍需遵守第 31 章的显卡兼容条件,不能在 V100 上直接改用 BF16。详见 PyTorch 混合精度说明。
还要注意,训练工具可能过滤日志汇总中的非有限 Loss。本课版本的 logging_nan_inf_filter 只影响日志统计,不负责修复梯度;曲线看起来正常,也不能替代对异常日志和实际回答的检查。具体定义见训练参数源码。
9.2 训练损失与验证损失
每处理一批训练数据,程序会计算损失并参与参数更新;验证时则使用另一份数据计算损失,不执行参数更新。
本次 eval_steps: 50,表示每完成 50 个更新步,就用全部 200 条验证样本做一次检查。因此正好在每轮结束时各有一次验证:
| 更新步 | 训练进度 | 验证 Loss |
|---|---|---|
| 50 | 第 1 轮结束 | 1.7238 |
| 100 | 第 2 轮结束 | 1.5951 |
| 150 | 第 3 轮结束 | 1.5880 |
这三次验证使用同一份数据。从第 50 步到第 100 步,验证损失降低约 0.1287;再到第 150 步,降低约 0.0071。后 50 步的改善幅度变小,但三个点还不能证明继续训练一定更好或已经过拟合。
这张表支持的判断是:本轮训练中,后面的检查点在同一验证集上的损失更低。 若想判断多练一轮是否值得,下一步应让这些检查点在相同生成设置下回答同一批验证输入,检查漏词、名称与格式。多花了计算时间,任务错误是否也减少,需要这一步来回答。
例如,假设候选甲的验证 Loss 更低,候选乙在关键词检查中更少漏掉完整名称,该怎样选?先确认两者使用相同验证输入、模板和生成设置,再按预先确定的任务验收要求比较。“按 Loss 选出的最佳检查点”只表示它在这个选择指标上最好。 若改为按任务指标选型,应记录新的选择依据,并留待独立测试验收。
<details> <summary>查日志时再看:最后一条 Loss 与全程 train_loss 为什么不同</summary>训练结束还会出现 train_loss。它和中途日志里的 loss 不是同一个统计区间:
| 记录 | 本次数值 | 统计含义 |
|---|---|---|
第 150 步的 loss | 1.4353 | 最近一个日志区间的训练损失 |
结束汇总的 train_loss | 1.8547 | 全程训练损失的汇总值 |
第 150 步的 eval_loss | 1.5880 | 这一轮验证数据的损失 |
因此,“最后一条 Loss 是 1.4353,为什么结束统计又是 1.8547”并不矛盾;前期较高的损失也计入全程统计。它们不是百分比,也不是关键词准确率。
</details>表中数值保留四位小数。需要复算时,可在配套 results/keywords-clean/training/ 中查看 trainer_state.json 和 train_results.json;阅读时先分清各字段的统计范围。
9.3 Loss 曲线与常见现象
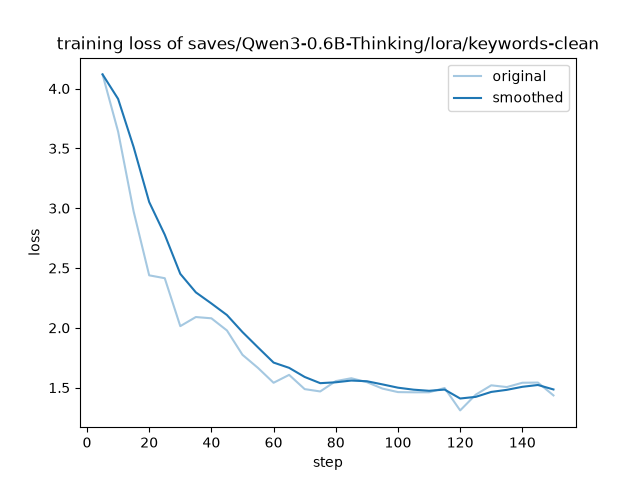
下面分别是示例训练的训练曲线和验证曲线:
训练曲线:每 5 个更新步记录一次。
验证曲线:只在第 50、100、150 步实际检查,共三个记录点。
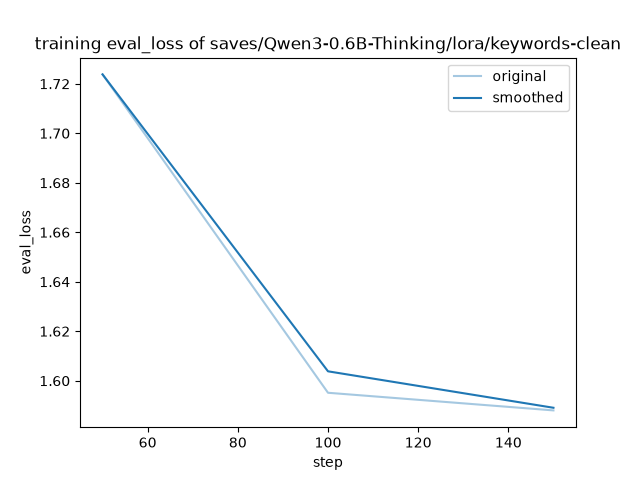
验证点之间的连线便于观察趋势,期间没有额外的验证记录。
曲线横轴表示训练进度,纵轴是 Loss。每张图里的浅色 original 是原始记录,深色 smoothed 是平滑后的线,两条线都来自同一类损失,并非一条训练、一条验证。平滑只是便于观察趋势,没有额外做一次训练或验证。两张图的纵轴范围不同,不能直接用线条的陡峭程度比较下降幅度。
先观察整体趋势,再回到日志定位发生变化的位置:
图:教学示意,不是本次训练曲线。蓝色实线表示训练 Loss,橙色虚线表示验证 Loss;没有画验证线的两行,只讨论训练日志中的现象。
不要给所有任务规定“Loss 必须降到 0.1”之类合格线。这里比较的是模型对参考答案的预测情况;实际关键词还需要单独检查。
Loss 下降以后,还要检查实际回答。 示例 Adapter 对一篇矿山降温文章能按分号格式输出,但相对参考答案仍漏了“制冷降温”“焓差”等词。第 32 章会逐项拆解这条回答,再通过批量评估判断问题是否普遍。
9.3.1 过拟合的判断与处理
先练习读一组变化。下表是为讲解而构造的数字,不是真实运行结果,也不是判断合格的分数线。 假设每轮结束都按相同方式统计损失,并使用同一份验证集:
| 训练进度 | 训练 Loss | 验证 Loss | 可以观察到什么 |
|---|---|---|---|
| 第 1 轮结束 | 1.8 | 2.0 | 留下第一次检查结果 |
| 第 2 轮结束 | 1.4 | 1.6 | 两边都下降,验证数据上的预测也在改善 |
| 第 3 轮结束 | 1.1 | 1.7 | 训练继续改善,验证开始变差,需要继续核对 |
| 第 4 轮结束 | 0.9 | 1.9 | 验证连续变差,不应只因训练 Loss 更低就选择第 4 轮 |
第 2 轮以后,模型更贴近训练题的答案,验证题的损失却反而上升。这是需要检查过拟合的信号。重点是同一训练过程中两边的变化趋势,不是要求两个 Loss 必须相等,也不是用某一次差值下结论。
遇到这样的走势,按下面的顺序检查:
- 先确认比较条件没变。 是否一直使用同一份验证数据、同一套模板与预处理?文章或参考答案是否被截断?先排除数据与处理错误。
- 再看实际回答。 用较早和较晚的检查点,在相同生成设置下回答同一批验证输入。对照参考答案,检查新出现的漏词、多词和格式错误,不只盯着两条曲线。
- 根据验证结果调整。 如果较晚的检查点在验证损失和实际回答上都更差,可以保留较早的检查点,减少训练轮数;再回查训练数据是否重复过多、题材过于单一或答案有误,而不是继续加轮数。
这些选择都使用验证集,不拿测试集反复挑检查点。测试集仍按第 29 章的约定,留给方案确定后的最终比较。
回到本章的真实日志示例:三次验证 Loss 都在下降,不能把上表后两轮的现象套在它身上。下降幅度变小,也不等于已经过拟合。下一节再看示例配置怎样保存和选择检查点。
9.4 训练检查点与 Adapter
每隔一段时间保存训练状态,得到的存档就是训练检查点(checkpoint)。本次 save_steps: 50,实际保存了 checkpoint-50、checkpoint-100 和 checkpoint-150,分别对应完成 50、100、150 次更新时的状态。
把第 9.2 节的验证表与存档对上,就知道为什么同时设置“验证”和“保存”:第 50、100、150 步各有一份验证结果,也各有一份可加载的模型存档。
如果把验证、保存间隔都从 50 改成 25,这次 150 步训练就会在 25、50、75、100、125、150 步检查并存档。候选检查点更密集,验证计算、文件写入和保留存档的磁盘开销也可能增加。两种频率都不直接改变每次参数更新的学习率或 batch;调整时还要满足工具对最佳检查点选择的间隔要求,第 31 章保持二者一致。
配置还设置了 load_best_model_at_end: true:训练结束后,按 eval_loss 选择验证损失最低的检查点。本次最低值恰好出现在第 150 步,因此选中 checkpoint-150。如果最低值出现在较早的检查点,就应按所设规则选它,而不是固定选择最后一份。
跟做时,检查点保存在第 31 章配置的训练输出目录中。先认识两类内容即可,具体文件检查与下载留在第 31 章:
adapter_model.safetensors和adapter_config.json:保存 LoRA 增量权重与配置,加载时需要匹配的基础模型。checkpoint-*:除相应 Adapter 外,还保存优化器、调度器、训练状态等,用于恢复训练或检查过程;只复制一份增量权重不等于完整续训存档。
示例 Adapter 权重约 20 MB,只保存新增的 LoRA 权重,不代表完整 Qwen 模型只有这么大。下载和保存时,仍需区分“用于加载的 Adapter”和“用于继续训练的完整检查点”。
推理时可以让基础模型与 Adapter 一起加载,也可以在支持的配置下把增量合并到对应基础权重,再导出完整模型:

图中展示的是两种产物的关系。第 31 章先完成训练和文件保存,第 32 章再实际加载、比较与导出模型。
章节思考题:
关键词 SFT 中,模型在预测什么?Loss、梯度和优化器怎样把参考答案用于参数更新?
参考思路: 模型根据文章、任务说明和前面的参考答案片段,预测后续 token。交叉熵用模型给正确 token 分配的概率衡量损失;反向传播据此求可训练参数的梯度,优化器再按规则更新参数。Loss、梯度由程序计算,学习率等设置由我们配置;训练并不是先生成整段答案,再数错了几个关键词。
本课关闭 train_on_prompt,为什么用户文章仍必须保留?如果参考答案中混入了无依据关键词,Loss 降低又说明什么?
参考思路: 关闭该设置表示用户内容对应的预测位置不直接计入损失,文章仍作为上下文参与计算、占用序列长度。错误参考也会成为学习目标,训练可能提高那些错误词的预测概率。因此 Loss 降低只说明更贴近当前训练目标,还要核对参考答案质量和实际生成效果。
单卡、不打包、1,600 条样本均保留,batch 为 4、梯度累积为 8、训练 3 轮:有效批次和总更新步数各是多少?只把 batch 改为 2 后,怎样维持原更新安排?
参考思路: 原有效批次为 4×8=32,每轮 1,600÷32=50 步,3 轮共 150 步。只减 batch 时,有效批次变成 16,总步数变成 300;每 50 步验证也变为每半轮一次。将累积同步改成 16,可恢复有效批次 32 和总计 150 步,但耗时与数值结果仍需实际比较。
学习率、预热和衰减分别控制什么?配置填了 learning_rate=5e-5,为什么日志中的学习率仍会变化?
参考思路: 学习率控制参数更新步长;预热让初期学习率从较小值逐步升高,衰减让后期学习率逐步降低。本课同时设置 cosine 调度和 5 个预热步,5e-5 是预热结束时达到的值,之后按调度变化。调大学习率不等于学得更好,是否合适要结合训练稳定性与验证回答判断。
训练显存主要用在哪里?Adapter 文件很小,为什么仍可能显存不足?梯度检查点又节省哪部分?
参考思路: 主要包括模型权重、梯度、优化器状态和计算中间结果,此外还有运行开销。Adapter 文件只反映部分训练产物,不包含整场计算所需的空间。梯度检查点少保存一些中间结果,需要时重算,以额外计算换显存;它与按步数写入磁盘的训练检查点不是同一件事。
FP32、FP16、BF16 保存一个数分别占多少字节?为什么启用 FP16 不等于整场训练显存减半,也不同于 4-bit 量化?
参考思路: 分别占 4、2、2 字节;FP16 与 BF16 的数值范围和精度分配不同,选择时还要检查硬件支持。混合精度让不同计算或状态使用不同精度,部分状态仍可能保留 FP32,整场训练也有其他占用。4-bit 量化则用更少比特近似保存基础权重,不表示全部训练计算或 LoRA 参数都变成 4 位。
全参数微调、LoRA 和 QLoRA 分别更新哪些参数?LoRA 冻结原权重后,为什么仍能改变输出,又为什么需要基础模型?
参考思路: 全参数微调更新原模型参数;LoRA 冻结基础权重,主要训练新增的低秩分支,分支结果与原层结果相加后影响输出。QLoRA 在此基础上低位量化基础权重,仍训练 LoRA 参数。LoRA 减少大量基础参数的梯度和优化器状态,但基础模型仍参与计算;量化进一步节省权重存储,也引入近似误差。
配置中的 rank=8、alpha=16、target=all 和 dropout=0 分别表示什么?为什么增大 rank 不一定让效果更好?
参考思路: rank 控制分支的中间宽度,标准 LoRA 按 alpha/r 缩放增量,此处为 2;target 决定在哪里加分支,all 指本工具识别的适用线性层;dropout=0 表示不随机遮住分支输入。它们改变的部分不同。增大 rank 会增加可训练参数,却不保证任务效果提高;调整时要记录其他设置并比较验证结果。
cutoff_len 限制的是字符数还是 token 数?当前最长训练序列为 957 token,上限从 2048 改成 4096 或 512,分别需要怎样判断?
参考思路: 它限制预处理后的 token 序列长度,序列包括任务、文章、答案与模板标记。2048 已能容纳当前样本,改成 4096 不会凭空增加内容,显存还取决于实际长度与填充;降到 512 可能截断长样本,要检查文章、答案和保留条数。更换数据、模板或分词器后,应重新统计。
训练 Loss 与验证 Loss 分别反映什么?如果训练 Loss 继续下降,验证 Loss 连续上升,怎样选择后续方案?
参考思路: 前者来自参与学习的数据,后者来自不用于参数更新的验证数据。持续背离可能提示过拟合,也要先核对数据和预处理。比较较早与较晚检查点在同一批验证输入上的回答,再决定是否减少轮数或调整训练;更低 Loss 不能直接证明关键词更准确,测试集不用于反复调参。
常见默认 LoRA 初始化中,A 随机、B 为零,为什么分支开始时不改变原输出?A、B 都为零是否等价?
参考思路: B 为零时乘积增量为零,但训练可以先更新 B,随后逐步学习分支。两矩阵都为零,会使这个乘积结构的常规梯度更新无法把分支学起来。这里讨论第 6.2 节的常见默认方式,其他初始化要按相应设计理解。
把 rank 从 8 改成 16,alpha 保持 16,标准 LoRA 的缩放系数怎样变化?怎样保持原系数?
参考思路: alpha/r 从 2 变为 1;若希望仍为 2,可把 alpha 改为 32。rank 增大还会增加分支参数量,保持缩放系数不代表输出或任务效果不变,因此仍需比较验证结果与开销。
总计 150 步,预热从 5 步改成 15 步,训练安排会怎样变化?怎样判断这项调整是否有帮助?
参考思路: 预热包含在总预算内,总数仍为 150 步,后续衰减阶段从 145 步变成 135 步。学习率上升过程拉长是确定变化;是否更稳定、任务效果是否更好,要在相同起点和其他条件下比较日志与验证回答。
LoRA dropout 从 0 改成 0.1,会删除 A、B 的部分权重吗?推理时是否继续随机丢弃?
参考思路: 它在训练时随机遮住部分分支输入,A、B 权重尺寸和参数量不变,正常推理时关闭。这个设置有时有助于缓解过拟合,也可能影响有限训练中的学习;它不能修正错误标注,也不是节省显存的开关。
本章小结:
- 模型先根据上下文预测 token,Loss 衡量预测,反向传播计算梯度,优化器执行参数更新。本课主要直接监督助手答案的位置,用户文章仍是参与计算的上下文。
- batch、梯度累积和 epoch 决定样本怎样分批、多久更新一次和总共遍历几轮;学习率控制更新步长,预热与衰减安排它随进度的变化。
- 训练显存包括权重、梯度、优化器状态和中间结果,不能只按权重大小估算。混合精度为不同计算或状态选择适用精度;长度要按完整序列检查,梯度检查点则用重算减少部分中间结果的存储。
- 全参数微调更新原模型参数,LoRA 主要训练新增分支,QLoRA 进一步量化基础权重。rank 控制分支宽度,alpha 控制缩放,target 决定作用位置,dropout 在训练时随机遮住部分分支输入。
- 训练与验证 Loss 帮助观察学习过程,检查点保存阶段结果,实际回答用于检查任务表现。配置是否合适,需要结合数据、资源与验证结果判断,不能只凭一条曲线或 Adapter 文件大小下结论。
建议下一步: 回到第 8.1 节,解释每项配置的用途,算出有效批次与更新步数,再说明训练会留下哪些文件、怎样检查效果。然后进入第 31 章,把这些理解用于环境准备、配置填写和真实训练日志的核对。