2、训练轮次与批次
本节先掌握: 分清“一次处理几条”和“处理几批才更新一次”,算出课程为什么是每轮 50 步、3 轮 150 步。
上一节介绍了一次参数更新。现在有 1,600 条训练样本,我们需要决定:每次处理多少条、处理几批以后更新参数,以及整份数据训练几轮。
先看 LLaMA-Factory 的 Train(训练)页面。选好模型和数据后,下方就是训练参数。下面从真实界面中分别截出本节要认识的三项:批处理大小、梯度累积和训练轮数。截图只用于认识字段,完整配置在第 8.1 节汇总,第 31 章再实际填写。
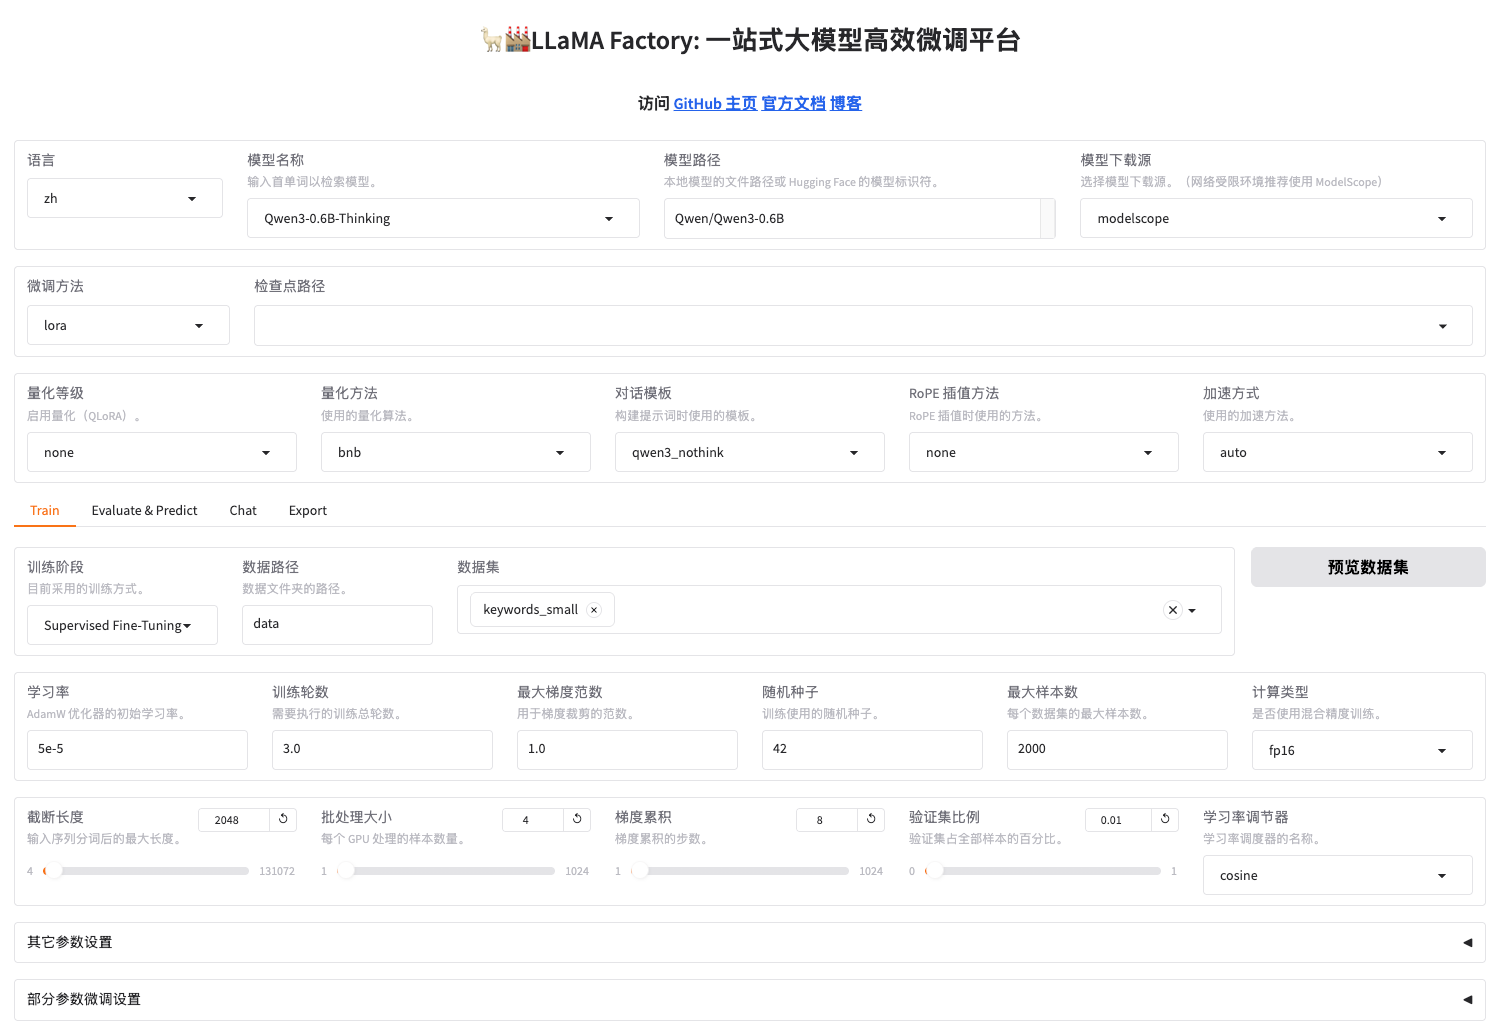
这里只查看批次和轮数字段。训练时使用 keywords_train 和独立的 keywords_validation,验证集比例填 0;截图大图中的 keywords_small 和比例 0.01 不用于这套练习,完整填写方法见第 31 章。
本章后面的计算统一采用 Qwen/Qwen3-0.6B、单卡、1,600 条训练样本、每批 4 条、梯度累积 8、训练 3 轮。先认识下面三项,其余设置随用随讲:
| 界面名称 | 配置文件中的字段 | 本章取值与作用 |
|---|---|---|
| 批处理大小 | <code style="white-space: normal; overflow-wrap: anywhere;">per_device_train_batch_size</code> | 4:每张卡一次处理 4 条样本 |
| 梯度累积 | <code style="white-space: normal; overflow-wrap: anywhere;">gradient_accumulation_steps</code> | 8:累计处理 8 批后更新一次参数 |
| 训练轮数 | <code style="white-space: normal; overflow-wrap: anywhere;">num_train_epochs</code> | 3:整份训练数据训练 3 轮 |
这些设置也保存在 案例与源码-4-微调/configs/keywords_clean_train.yaml 中。YAML 是一种配置文件格式,每行用“参数名: 值”记录设置;例如 num_train_epochs: 3 就对应界面中的“训练轮数 3”。它保存训练安排,不保存训练样本。
2.1 批处理大小、训练轮数与更新步
先把界面设置与日志中的英文名称对应起来:
- Batch(批次):一次放进模型一起处理的样本组。这里一个 batch 是 4 条。
- Epoch(训练轮):训练集中的每条样本大致都被看过一遍,记为一轮。
- Step(更新步):训练程序完成一次参数更新,记为一步。没有使用梯度累积时,处理一个 batch 通常会完成一步更新。
在本课程按轮数训练的配置中,step 是程序算出的更新进度,无须再另填一个总步数。
1,600 恰好能被 4 整除:
1 个 epoch:1,600 ÷ 4 = 400 个小 batch这 400 是处理的小批次数。课程还设置了梯度累积 8,因此不代表更新了 400 次。接下来算清楚:每处理 8 批才更新一次,会得到多少个更新步?
2.2 梯度累积与有效批次
梯度累积(gradient accumulation) 的意思是:处理完一个小 batch 后,先不更新参数,而是把本次得到的梯度暂存下来;连续处理若干个小 batch 后,再统一更新一次参数。
先按课程配置走一遍:用一张 GPU(通常简称“单卡”),第 1 批处理 4 条,暂不更新;第 2 批再处理 4 条,继续累积梯度……处理完第 8 批,才执行一次更新。然后开始下一组:
单卡 batch size = 4
梯度累积次数 = 8

4 条 × 8 次 = 32 条样本后更新一次参数
这 32 条叫作有效批次大小。在单卡场景下,可以先这样理解:
有效批次大小 = 单卡 batch size × 梯度累积次数假设换了一批更长的文章,模型已经加载成功,但每次处理 4 条时显存不够了。 我们想改为每次处理 2 条,同时仍然每 32 条更新一次,应该一起改哪项设置?
先只改 batch:每批 2 条、仍然累积 8 批,就变成每 16 条更新一次。每次同时处理的样本少了,但更新也变得更频繁。
如果希望仍然每 32 条更新一次,就要把累积次数同步改为 16。batch 管一次处理多少条,梯度累积管处理几批才更新。 数据没有减半,变化的是分组方式:
| 单卡设置 | 一次处理 | 更新前处理几批 | 有效批次 |
|---|---|---|---|
| 原配置:batch 4、累积 8 | 4 条 | 8 批 | 32 条 |
| 只改 batch:2、累积 8 | 2 条 | 8 批 | 16 条 |
| 配套修改:batch 2、累积 16 | 2 条 | 16 批 | 32 条 |
图中对照的是表中的第一种和第三种安排。每个小框是一批,框内的数字是样本条数;沿箭头依次处理,并没有把 32 条一起放进 GPU。累计满 32 条以后才更新,下一组再使用新参数。
在样本长度等条件相同时,每次处理 2 条通常比处理 4 条少保存一些计算中间结果。降低这部分显存占用靠的是减小单卡 batch;增加累积次数,是为了维持每次更新所用的样本数。 如果 batch 仍为 4,只增加累积次数,当前这批 4 条所需的空间不会因此缩小。
<details> <summary>调整时再看:有效批次相同,运行就一定相同吗</summary>反过来,显存充足时,batch 8、累积 4 也能得到有效批次 32,但一次要同时处理更多样本。有效批次相同,不代表速度和训练结果完全相同,也不保证调整以后一定不会报错;第 5 节会解释其他显存占用。
</details>再把一整轮算完:
训练样本:1,600 条
小批次数:1,600 ÷ 4 = 400 批
每轮更新:400 ÷ 8 = 50 步
训练 3 轮:50 × 3 = 150 步
这个计算以单卡、关闭序列打包、全部 1,600 条训练样本被保留为前提;“打包”是把多条短样本拼在一起处理,课程配置不启用。第 31 章的示例启动日志也对应 50 步/轮、共 150 步。样本数或打包方式改变后,应重新核对日志;验证集不参与这些参数更新。
<details> <summary>进一步对照:更新频率、验证时机和真实资源变化</summary>把三种安排都算一遍,就能看到修改的连带影响:
| 单卡设置 | 每轮更新步数 | 3 轮总步数 | 每 50 步验证一次,相当于 |
|---|---|---|---|
| batch 4、累积 8 | 1600 ÷ 32 = 50 | 150 | 每轮检查一次 |
| batch 2、累积 8 | 1600 ÷ 16 = 100 | 300 | 每半轮检查一次 |
| batch 2、累积 16 | 1600 ÷ 32 = 50 | 150 | 每轮检查一次 |
三种配置都把训练集练了 3 遍,但第二种更新得更频繁,按步数设置的验证间隔也落在了不同进度上。调整 batch 后,要一起核对有效批次、总步数和验证时机。 第 9 节会解释验证与保存的具体设置。
这样修改会有多大资源收益?第 33 章已有一组真实对照:同一张 V100、同一个模型与课程数据,两组各完成 50 步。batch 4/累积 8 的最高采样显存约为 27.92 GiB,整次命令耗时约 301 秒;batch 2/累积 16 则约为 21.71 GiB、560 秒。本次每批处理更少,留出了更多显存余量,也花了更多时间。
这组 50 步实验统计了从加载到保存的最高采样显存与整次耗时,用来比较资源开销;任务效果还需另行评估。完整记录与复现方法见第 33 章的 batch 对照。
</details>读到这里可以自查: 每次处理 2 条,能不能每 32 条才更新一次?能,需要累积 16 批;“一批”与“一次更新”不必是同一件事。
2.3 epoch 不是越多越好
如果练习题越答越熟,新文章反而答得更差,还要继续增加轮数吗? epoch 增加,会让模型反复看到同一批训练样本。适当重复有助于学习任务规律,但是否继续,要看未参与训练的数据。
第 29 章解释了泛化与过拟合。用到 epoch 上,就是每多练一轮,还要检查没有参与训练的同类文章是否也有改善。
例如,其他批次设置保持课程取值,训练 1 轮对应 50 次更新,3 轮对应 150 次。多出的两轮提供了更多学习机会,也增加了计算;是否值得,要看新文章上的回答和验证损失。
本章第 9 节已有同一次训练在第 50、100、150 步保存的结果,可以先比较这些阶段,再决定是否需要新实验。若验证表现持续变差,应按第 9.3.1 节回查原因,不能只因训练 Loss 还在下降就继续加轮数。