30 - 模型训练原理与高效微调
本章课程目标:
- 能沿着一条样本解释 token 预测、Loss、梯度与优化器更新,分清输入上下文和直接监督的位置。
- 能计算 batch、梯度累积和 epoch 对有效批次与更新步数的影响,并解释学习率、预热和衰减的作用。
- 能说明训练显存的主要组成,分清数值精度与量化,理解序列长度、截断和梯度检查点的影响。
- 能比较全参数微调、LoRA 与 QLoRA,读懂 rank、alpha、target 和 dropout 的基本含义。
- 能把配置、训练与验证日志、检查点和实际回答联系起来,判断下一步应检查或调整什么。
学习建议: 先跟着分号例子讲清“预测 → 损失 → 梯度 → 更新”,再依次理解批次、学习率、长度、显存与 LoRA。第 8.1 节汇总一次完整训练安排,英文配置字段需要时再查;不用每学一个概念就重新读整张表。章末主线题按这个顺序自测,手算交叉熵与矩阵推导可以后看;读完后应能说明一份配置怎样安排训练,再进入第 31 章实操。
第 29 章已经准备好 1,600 条训练数据、200 条验证数据和 200 条测试数据。接下来,我们让 Qwen/Qwen3-0.6B 根据“文章 → 关键词”的示例,练习按要求提取关键词。
先分清:训练设置、模型权重和观察结果。
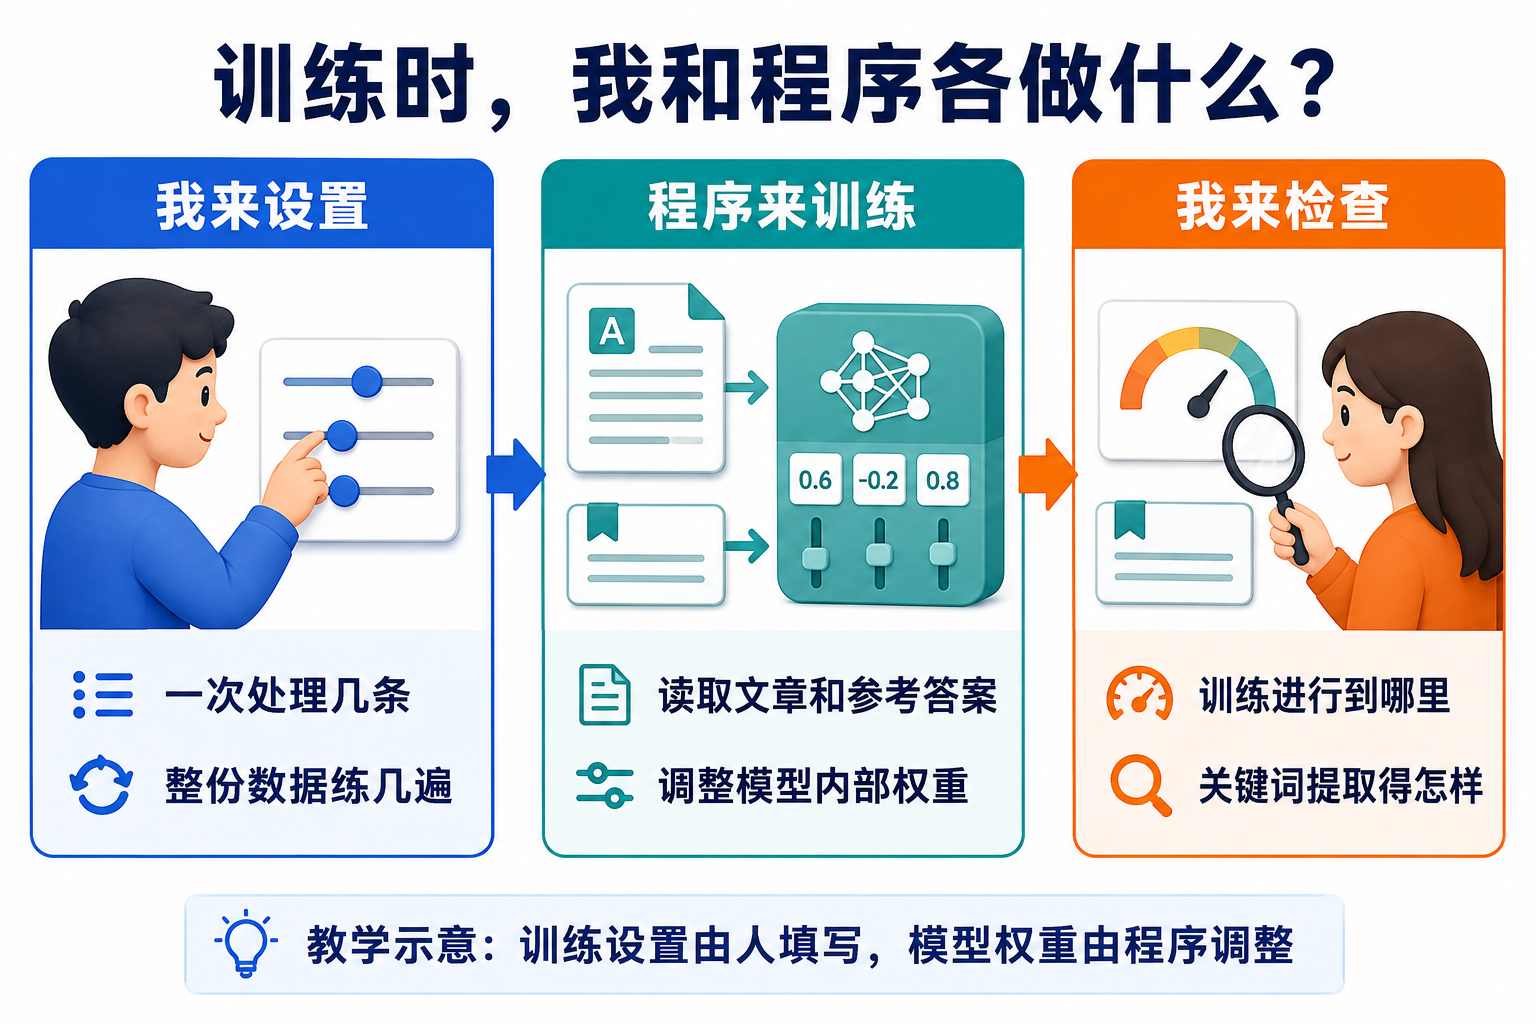
训练程序会根据文章和参考答案,调整模型内部参与计算的数值。这些数值叫作模型参数,也叫权重,由程序计算和更新。
我们填写的是训练设置:一次处理几条、整份数据练几遍、每次更新的幅度怎样控制。日常说“调训练参数”,通常就是修改这些设置。后文谈到“更新模型参数”,则是指程序改变内部权重。
程序还会计算 Loss(损失值)、记录训练进度,供我们观察。它们不需要预先填成某个目标数值;例如,“训练 3 轮”由我们设置,“现在完成了多少步”由程序记录。
先认识五项设置。 现在只看它们分别回答什么问题,具体变化在对应小节展开:
| 我们要决定的问题 | 训练设置 | 本课程安排 |
|---|---|---|
| 一次处理几条数据? | 批处理大小(batch size) | 每批 4 条 |
| 处理几批后更新一次模型参数? | 梯度累积步数 | 累积 8 批再更新 |
| 把整份训练数据练几遍? | 训练轮数(epoch) | 练习 3 轮 |
| 每次更新的步子有多大? | 学习率(learning rate) | 按 5e-5 设置,随训练进度调节 |
| 一条训练样本最多保留多长? | 截断长度(cutoff_len) | 2048 个 token,包含输入和答案等内容 |
本课程使用 LoRA:训练时保持原模型权重不变,主要调整新增的一小部分权重。第 6 节介绍它的计算方式,以及怎样减少训练开销。
阅读安排: 正文结合例子解释训练过程和参数用途,手算与推导放在折叠的选读部分。
- 训练原理: 上面五项设置的作用,训练怎样利用参考答案,LoRA 改了哪部分,以及 Loss 为什么不能代替实际回答质量。
- 配置参数: 优化器、预热与调度、LoRA 的 rank 和 alpha、计算精度、梯度检查点等。完整配置在第 8.1 节汇总,实际运行时还需核对精度与显卡的匹配等条件。
- 进阶选读: 交叉熵手算、标签数组、矩阵推导、量化编码和进一步的实验对照。