AI 输出相关
AI 幻觉
AI 幻觉(Hallucination)是指 AI 输出了不符合事实的内容,可能是编造了不存在的 API、给出了错误的函数用法、推荐了根本不存在的库,甚至胡编乱造一些看起来很合理但完全错误的信息。
比如下面这段对话,我让 AI 介绍一下程序员鱼皮,结果它一本正经地胡说八道,我的本名可不是这个……
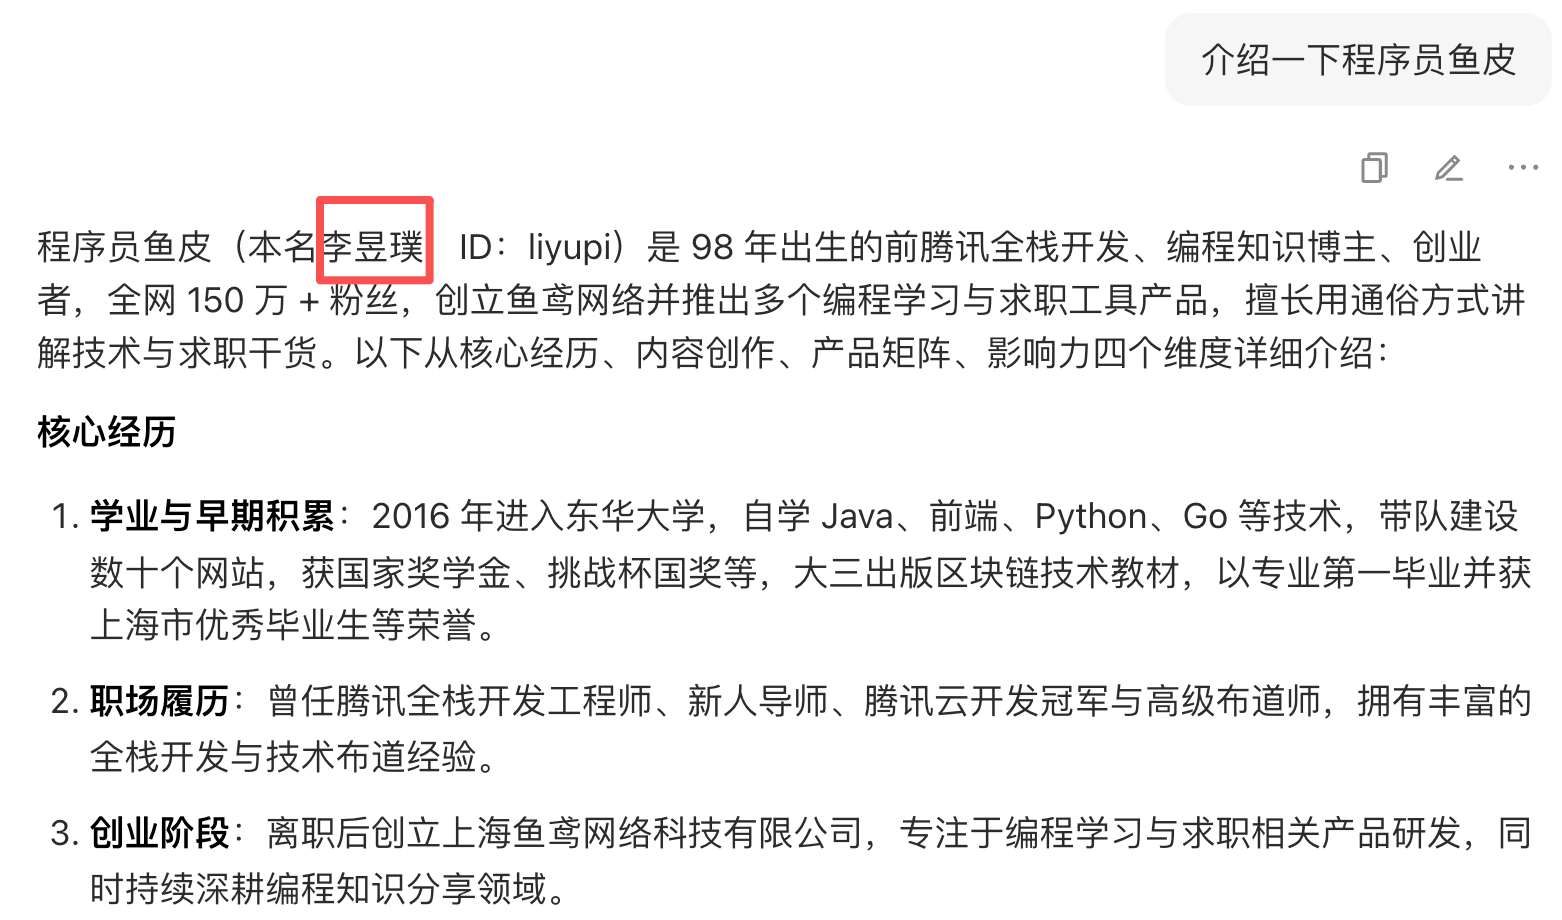
这是大语言模型的固有问题,因为它们是基于概率生成内容的,有时会 “脑补” 不存在的东西。
在 AI 编程时,我们可以通过以下方法尽量减少幻觉带来的影响:
- 要求 AI 提供文档链接验证
- 自己查官方文档确认
- 换个模型试试
- 开新对话重新描述问题
- 利用 Context7 等获取到最新技术文档的 MCP 扩展
对于做 AI 应用开发的程序员来说,如何消除幻觉是一个需要重点攻克的挑战。前面提到的 RAG(检索增强生成)技术就是目前最主流的解决方案之一,通过让 AI 先检索真实数据再回答,大幅降低幻觉的概率。
温度
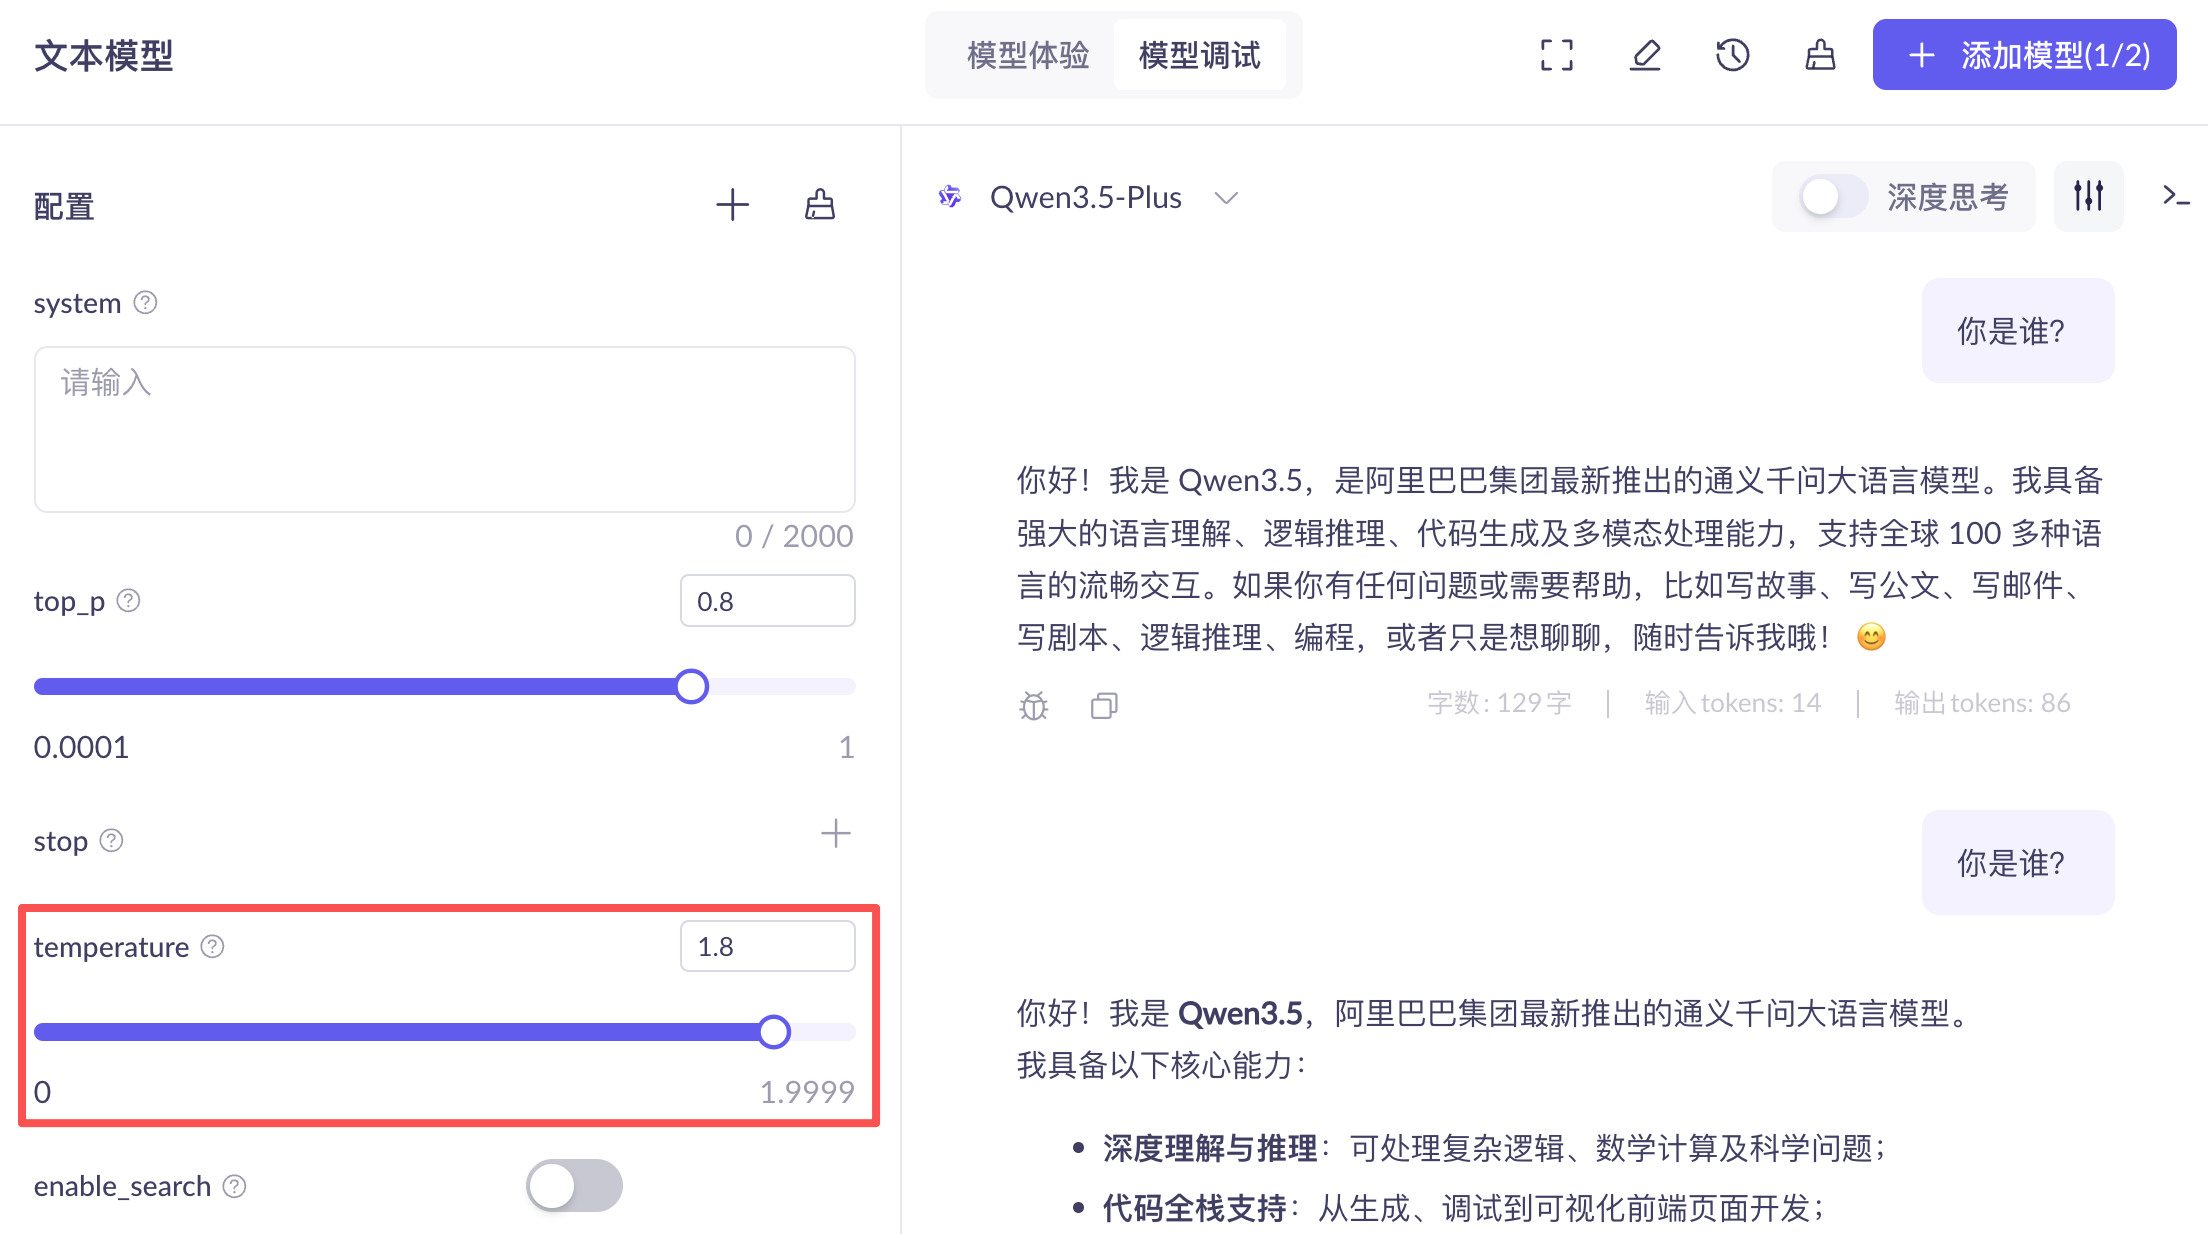
温度(Temperature)是控制 AI 输出随机性的参数,取值一般在 0 ~ 2 之间(不同大模型和 AI 编程工具的设置范围可能会有区别)。
- 温度低(如 0.1):输出更确定、更保守,适合写代码
- 温度高(如 1.0):输出更随机、更有创意,适合头脑风暴
在编程场景中,一般使用较低的温度,让 AI 生成更稳定、更可预测的代码。而在需要 AI 发挥创意的场景(比如起名字、写文案、头脑风暴产品方案),可以适当调高温度,让 AI 给出更多样化的建议。
比如下图,我把温度调高,输出的结构可能完全不同:
流式输出
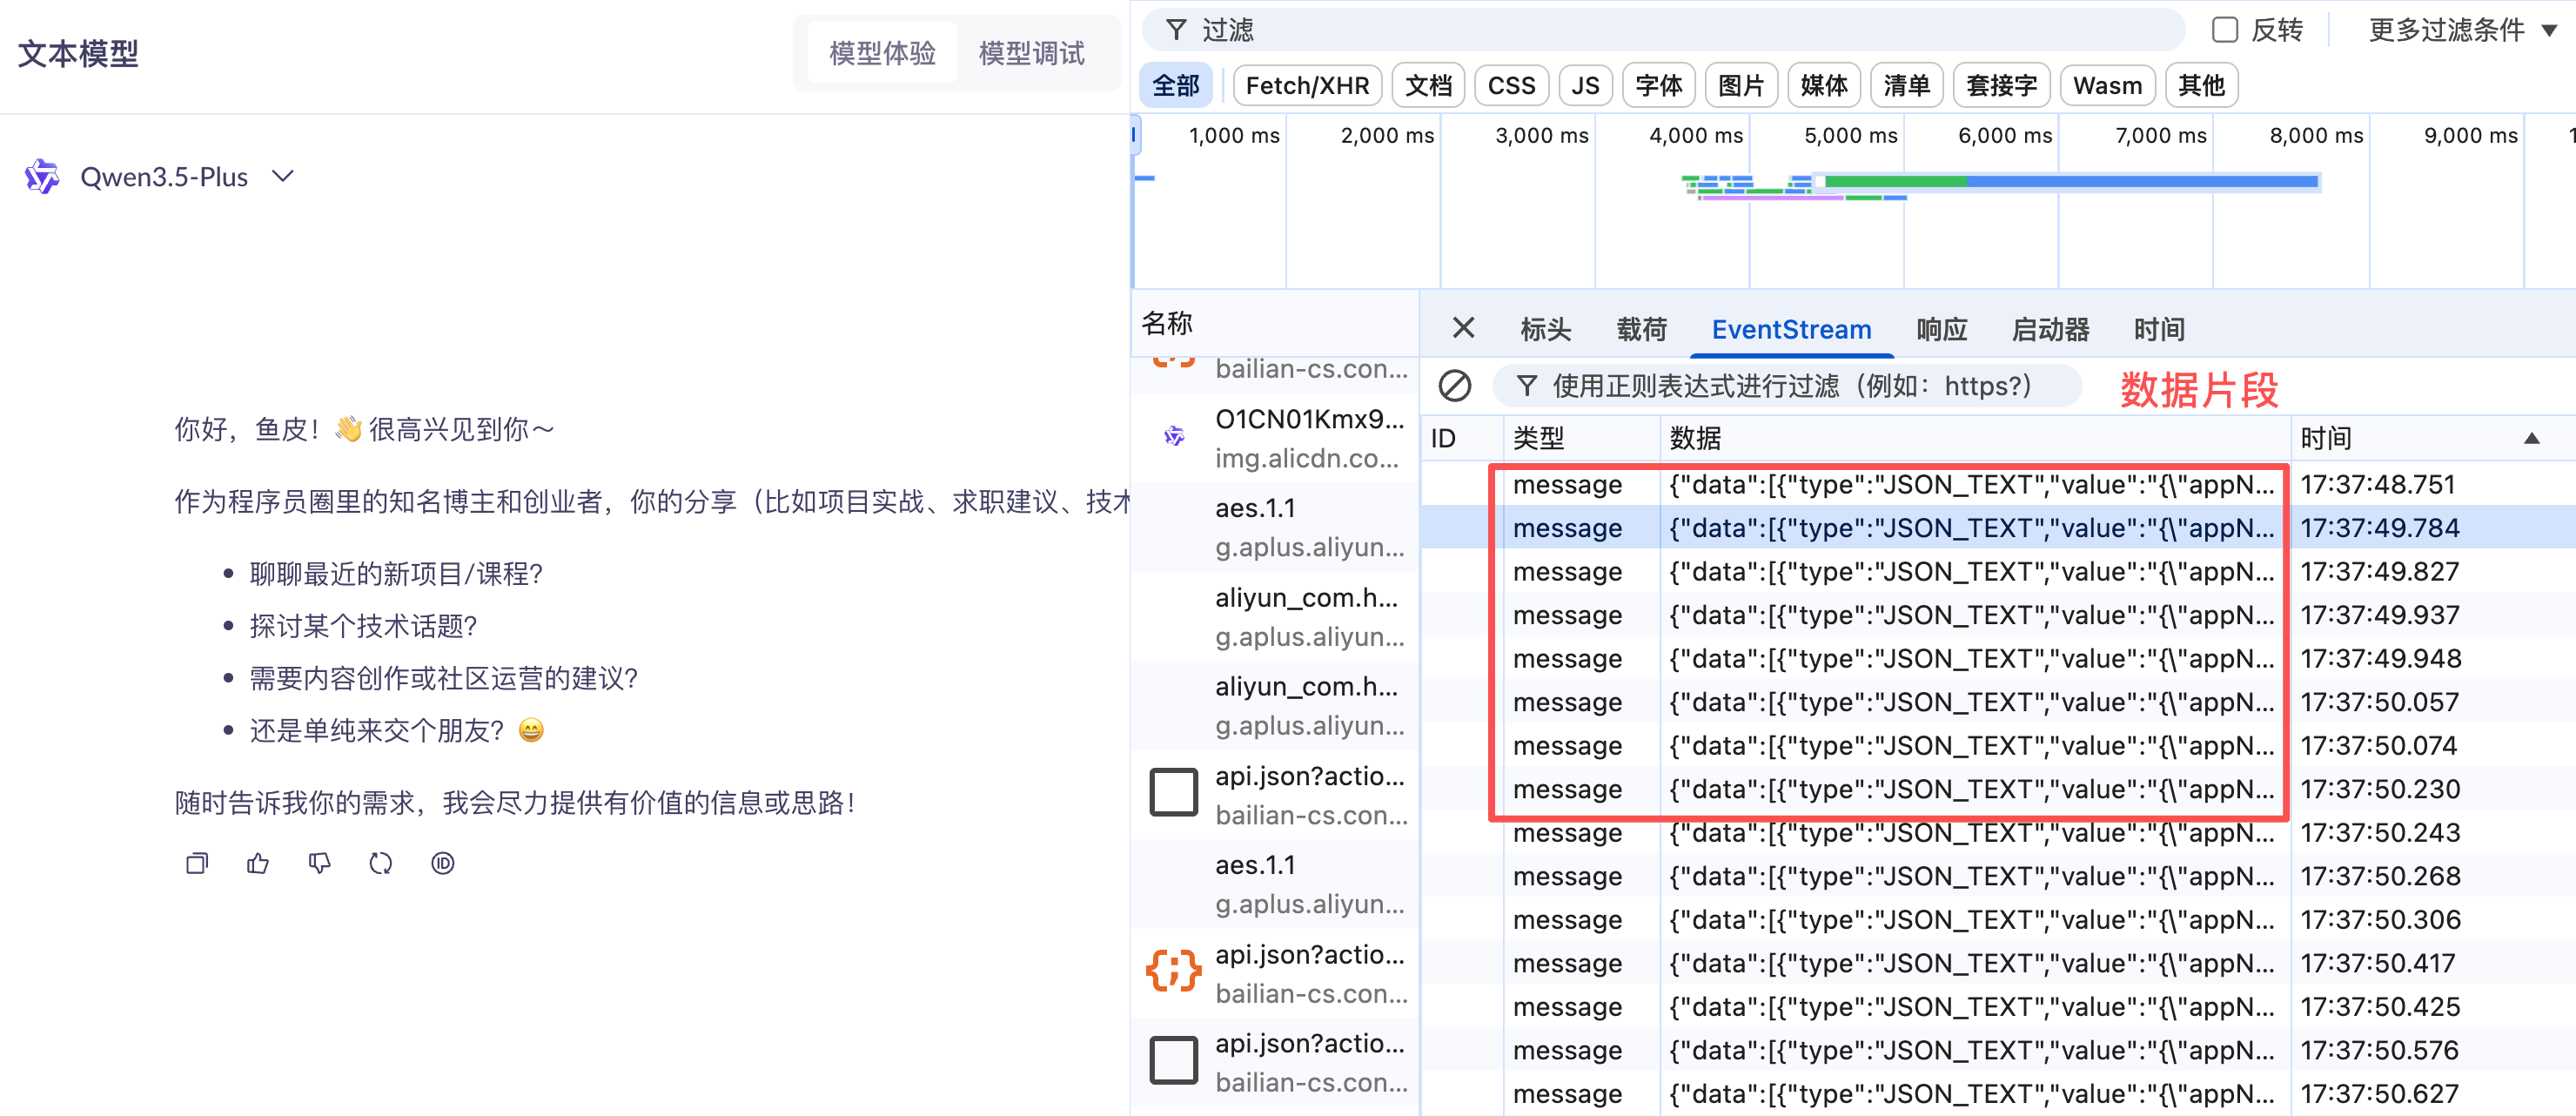
流式输出(Streaming)是指 AI 一边生成内容,一边实时显示给用户,而不是等全部生成完再显示。
这就像看直播而不是看录播,你能实时看到 AI 的输出过程和生成的内容,如果发现方向不对,可以及时中断,避免浪费 Token。
大多数 AI 编程工具都支持流式输出,让交互体验更流畅。
在技术实现上,流式输出一般基于 SSE(Server-Sent Events,服务器推送事件)技术,服务端通过持续推送数据片段给客户端,做到实时展示。