上下文管理
上下文(Context)
上下文是 AI 在回答问题时能够参考的所有信息,包括:
- 当前对话的历史
- 你打开的代码文件
- 项目的结构和配置
- 你提供的参考资料
上下文越丰富、越和当前任务相关,AI 生成的代码就越符合你的需求。这就像给一个新同事交接工作,你给的背景信息越多,他上手就越快。
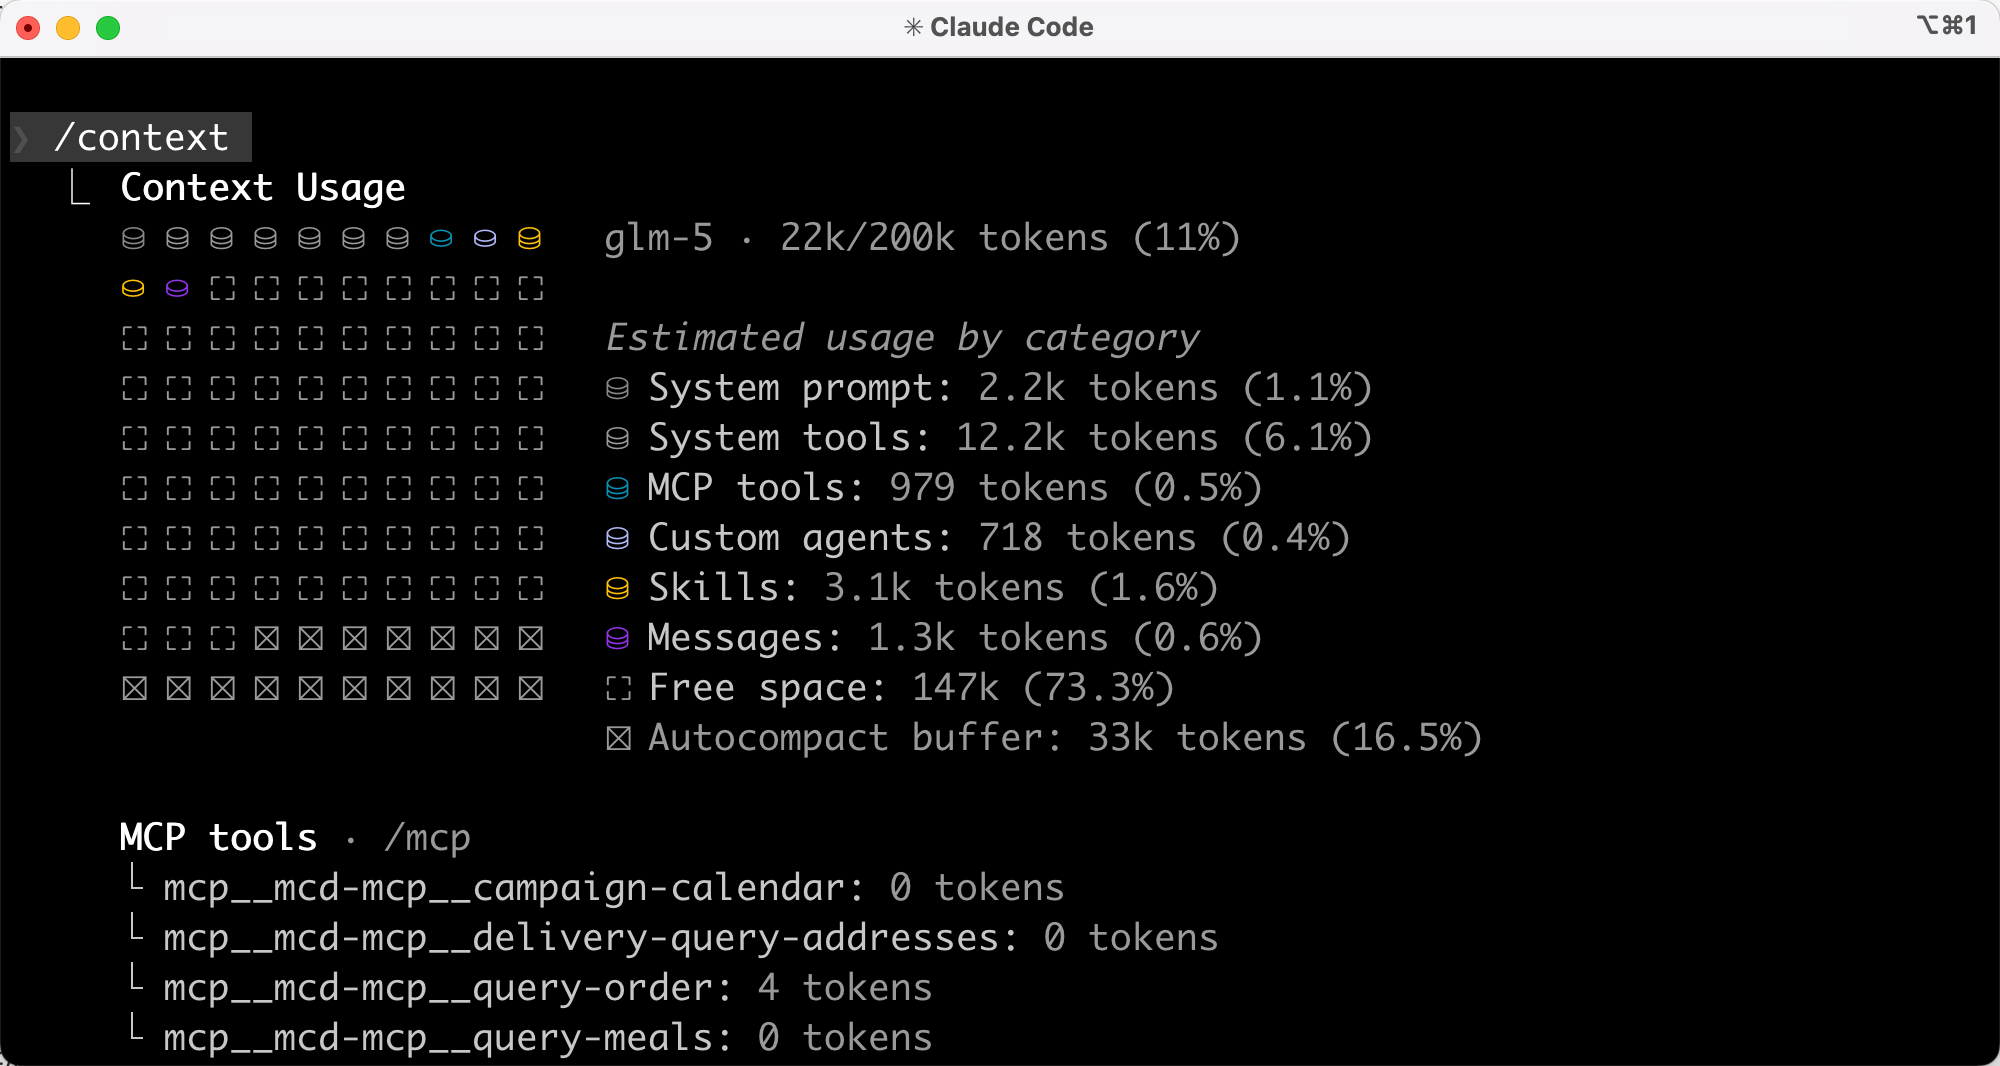
在 Cursor 中,你可以通过对话框附近的 Token 用量指示器来大致了解当前上下文的大小;在 Claude Code 中,可以使用 /context 命令查看上下文占用情况。
上下文工程
上下文工程(Context Engineering)是有策略地管理和优化提供给 AI 的上下文信息的技术。
核心目标是 让 AI 拥有恰到好处的信息。既不能太少(导致 AI 不了解情况),也不能太多(导致信息过载、成本上升)。
好的上下文工程包括:
- 选择最相关的文件
- 提供必要的背景说明
- 使用规则文件定义项目规范
- 适时清理无关的对话历史
上下文工程是目前 AI 领域非常热门的研究方向。2026 年的趋势正在从简单的上下文管理,演进到更复杂的 记忆架构 —— 让 AI 拥有短期记忆(当前对话上下文)、长期记忆(跨会话的知识积累)和外部记忆(向量数据库、知识图谱等)。
比如 Claude Opus 4.5 就引入了 Memory Tool,能让 AI 在超出上下文窗口的情况下,通过文件系统式的持久化存储来记住重要信息。根据 Anthropic 官方数据,这项技术在长时间工作流中减少了 84% 的 Token 消耗!
可以说,谁能更好地解决上下文和记忆的问题,谁就能在 AI 编程领域占据优势。
Claude Code 的三层记忆架构是上下文工程的典型实践:
- 第一层是 MEMORY.md(热数据),就像一本书的目录,每次对话都会加载,但严格限制在 200 行、25KB 以内
- 第二层是话题文件(温数据),存着你的编码偏好、项目约定等,新对话开始时 AI 只挑选最相关的 5 个文件加载
- 第三层是历史对话(冷数据),存成文件,需要时用 Grep 搜索。不同温度的数据用不同方式管理 —— 热的常驻、温的按需、冷的搜索。

一个有意思的设计是,Claude Code 的记忆不记代码,只记人的偏好和判断。因为代码会变化但记忆不会自动更新,如果记忆里说 “函数 X 在第 30 行”,你重构后这条记忆就变成了误导。代码的事实永远去源码里实时读取,这种设计从根源上消灭了缓存和数据不一致的可能性。
上下文压缩
上下文压缩(Context Compaction)是 AI 自动压缩和总结之前对话内容的技术,解决的是长时间运行任务中上下文溢出的问题。
以前跑长任务的时候,AI 经常会撞到上下文长度的天花板,前面聊过的内容被挤掉后 AI 就失忆了,导致生成的代码和之前的约定对不上。有了上下文压缩,AI 会在上下文快要满的时候,自动把前面的对话总结成更精简的形式,保留关键信息的同时释放空间,这样就能持续工作更久而不会失忆。
你可以把它想象成项目经理写会议纪要。已经开了 3 小时的会,不可能把每句话都记下来,但关键决策、待办事项、重要结论都会被记录。AI 的上下文压缩也是类似的思路,把冗长的对话历史浓缩成关键信息。
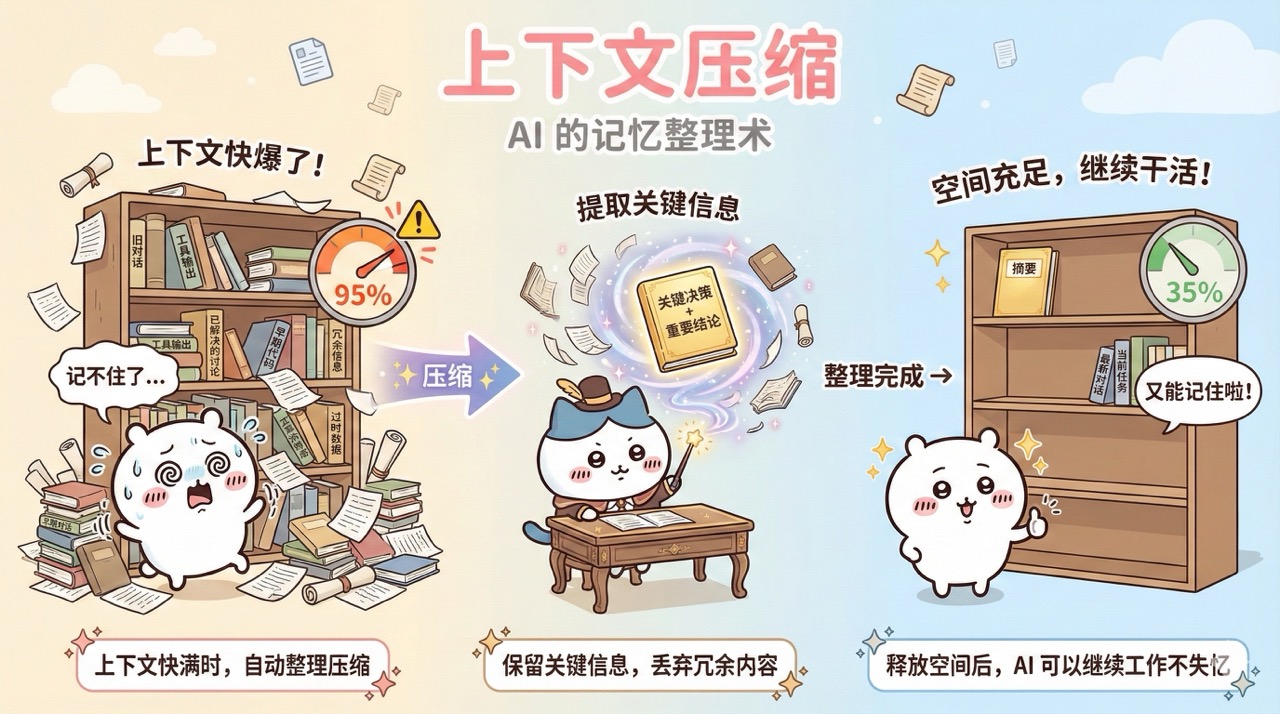
Claude Opus 4.8 已经内置了上下文压缩能力,搭配它的 100 万 token 上下文窗口,可以让长时间运行的编程任务更加稳定。
Claude Code 在源码中实现了一套精妙的五级压缩策略,像漏斗一样层层过滤:
- Snip 剪裁:最轻的一刀,把旧的工具调用结果只保留结构,不保留内容
- Microcompact 微压缩:把体积大的工具执行结果卸载到缓存里。注意是卸载到缓存而不是直接丢掉,因为子智能体后续可能还需要这些结果
- Context Collapse 折叠:对中间的对话做折叠摘要,只保留关键信息
- Autocompact 自动压缩:当上下文占用超过阈值时,触发全量摘要压缩
- Reactive Compact 应急压缩:最后的兜底,当 API 返回 413 “提示词太长” 错误时紧急触发
这五级从轻到重依次触发,能裁的先裁,实在不够了再上更重的方案。

规则文件
规则文件(Rules File)是放在项目中的配置文件,用来告诉 AI 你的项目规范、技术栈、代码风格等信息。有了规则文件,AI 每次生成代码时都可以参考这些规则,生成的代码更符合你的项目风格,省去了反复强调的麻烦。
不同 AI 编程工具使用不同的规则文件格式:
- Cursor:早期使用
.cursorrules单文件格式,现在推荐使用.cursor/rules/*.mdc多文件格式 - Claude Code:使用
CLAUDE.md文件 - GitHub Copilot:使用
.github/copilot-instructions.md文件
以 Cursor 为例,.mdc 规则文件支持 YAML 元数据(frontmatter),可以指定规则的适用范围。根据 Cursor 官方文档,其格式如下:
---
description: React 组件开发规范
globs: src/components/**/*.tsx
alwaysApply: false
---
# React 规范
- 使用函数式组件
- 优先使用 hooks
规则文件的激活方式有多种,比如:
- 始终生效:设置
alwaysApply: true - 模式匹配:当引用匹配
globs的文件时自动激活 - 手动调用:在对话中用
@规则名引用 - AI 自主决定:AI 根据任务相关性自动加载
💡 注意,随着工具版本的更新,这些文件的名称和标准可能会发生改变,一切以工具官方文档为主。
AGENTS.md
AGENTS.md 是一种开放的文件格式,专门用于给 AI 编程智能体提供项目指令。它本质上也是一种规则文件,只不过是跨工具通用的开放标准。
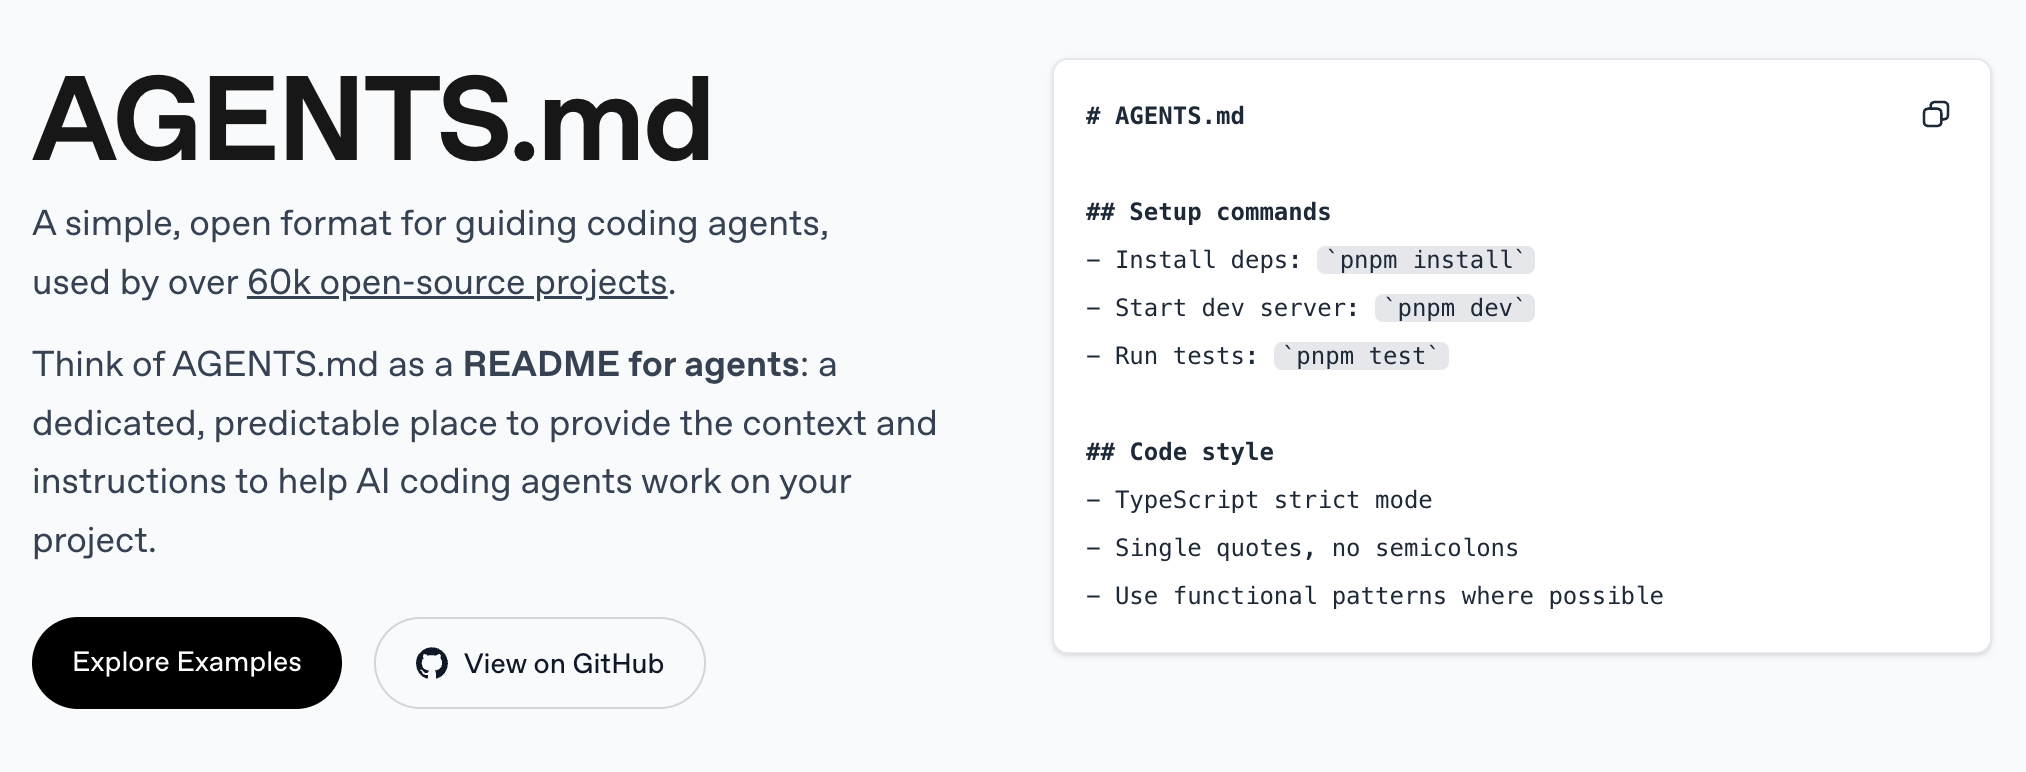
传统的 README.md 是写给人看的,主要介绍项目是什么、怎么用。而 AGENTS.md 是写给 AI 看的,包含 AI 工作时需要的技术细节:
- 项目的构建和启动命令
- 测试运行方式
- 代码风格和规范
- 项目结构说明
一个典型的 AGENTS.md 文件大概长这样:
# 项目设置
- 安装依赖:npm install
- 启动开发:npm run dev
- 运行测试:npm test

# 代码规范
- 使用 TypeScript 严格模式
- 组件文件使用 PascalCase 命名
- 工具函数使用 camelCase 命名
AGENTS.md 的优势在于它是一个开放标准,被数万个开源项目采用。当你使用支持该标准的 AI 编程工具(比如 Claude Code、Codex、Cursor、GitHub Copilot 等)时,AI 会自动识别项目根目录下的 AGENTS.md 文件,并将其中的指令发送给 AI,不需要你手动引用。
SDD 规范驱动开发
SDD(Spec-Driven Development,规范驱动开发)是 AI 时代的一种新型开发方法论,强调在编码之前先创建明确的、AI 能直接理解和执行的规范文档。
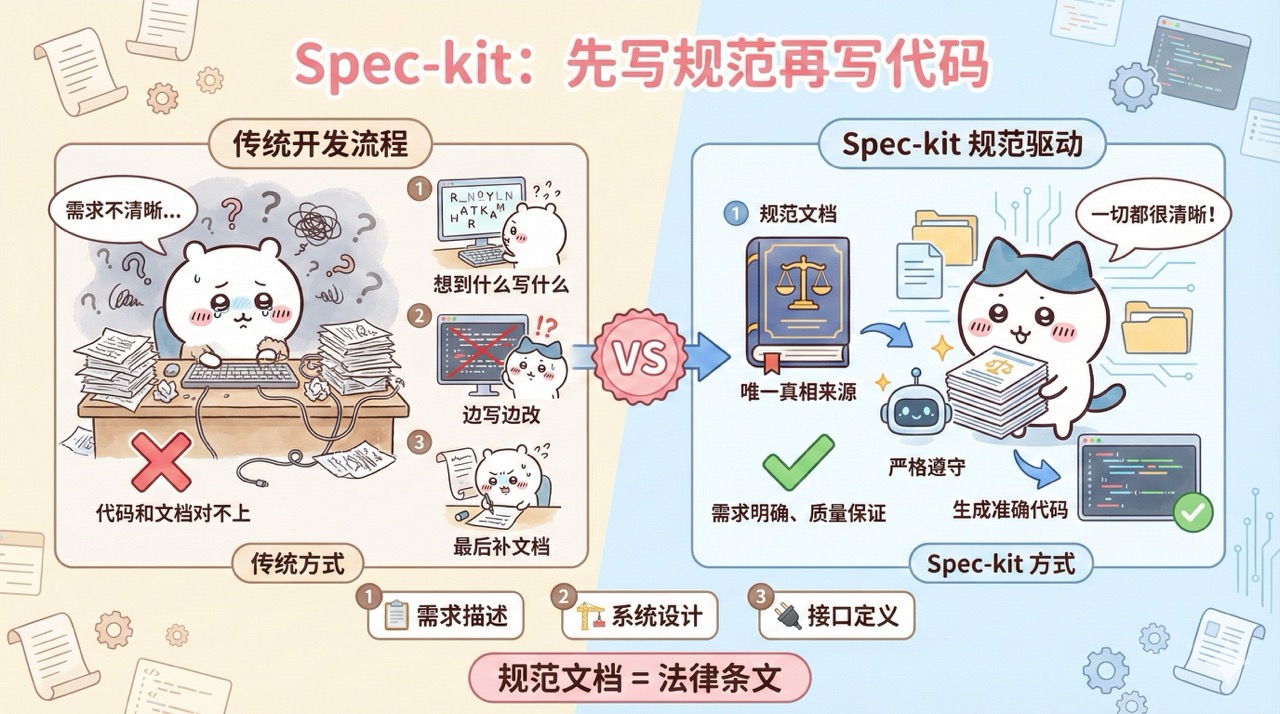
传统开发流程是:想到什么写什么,边写边改,最后再补文档。这样容易导致需求不清晰、代码和文档对不上。
而 SDD 的思路正好相反:先把需求写成规范文档,并且把规范文档当作代码的唯一真相来源。
你可以把规范文档理解为 “项目宪法”,它包含了详细的需求描述、系统设计和接口定义。AI 必须严格遵守这些条文来生成代码,确保产出完全符合预期。
为什么 SDD 越来越受重视?
因为 AI 生成代码的质量直接取决于上下文的清晰度,而不仅仅是依靠提示词技巧。一个清晰的规范文档能比任何 Prompt 黑魔法更有效地减少错误。
SDD 的典型工作流程如下:
- Constitution 制定准则:定义项目的基本原则、代码规范、性能标准
- Specify 编写规范:描述要做什么功能、为什么做、用户需求是什么
- Clarify 澄清疑问:让 AI 提出结构化问题,明确边界情况和错误处理
- Plan 制定方案:确定技术栈、系统架构、数据模型、API 接口
- Tasks 拆解任务:把计划拆解成可执行的任务列表,标注依赖关系和优先级
- Implement 执行实现:AI 按照任务列表生成代码,人类验证
其实这和程序员在企业中开发项目的标准流程非常相似,只不过执行者从人变成了 AI。
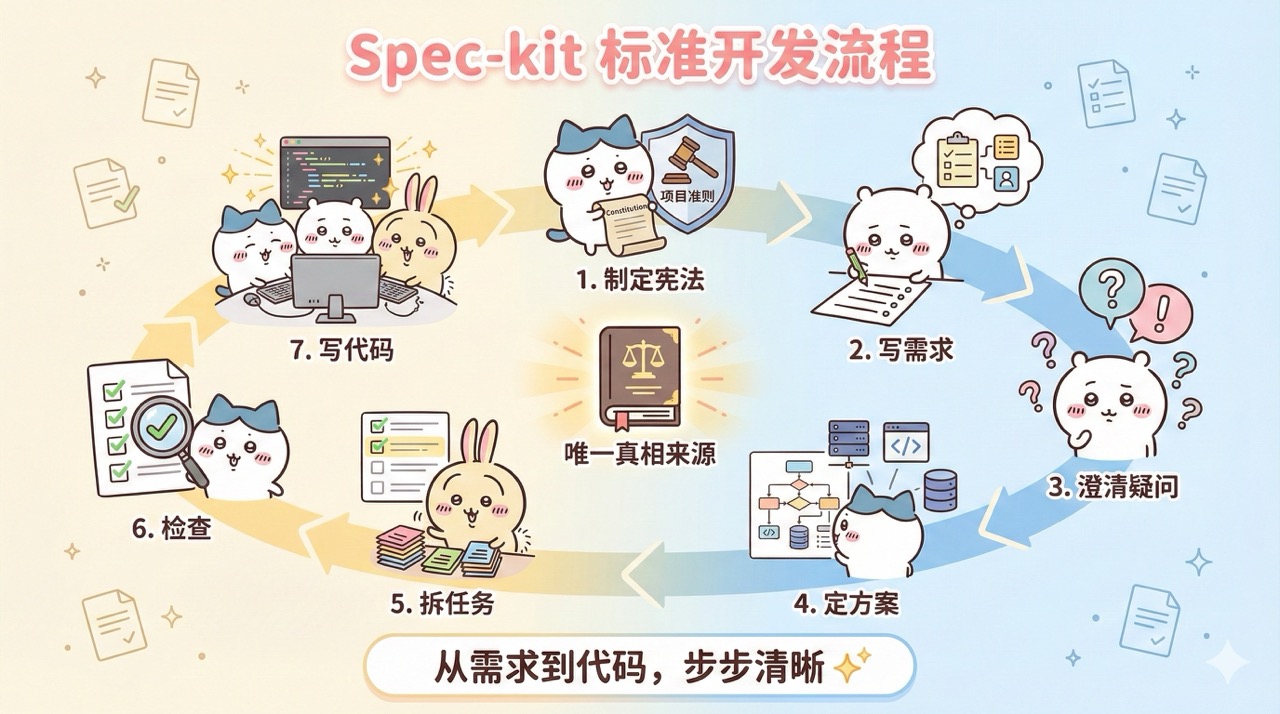
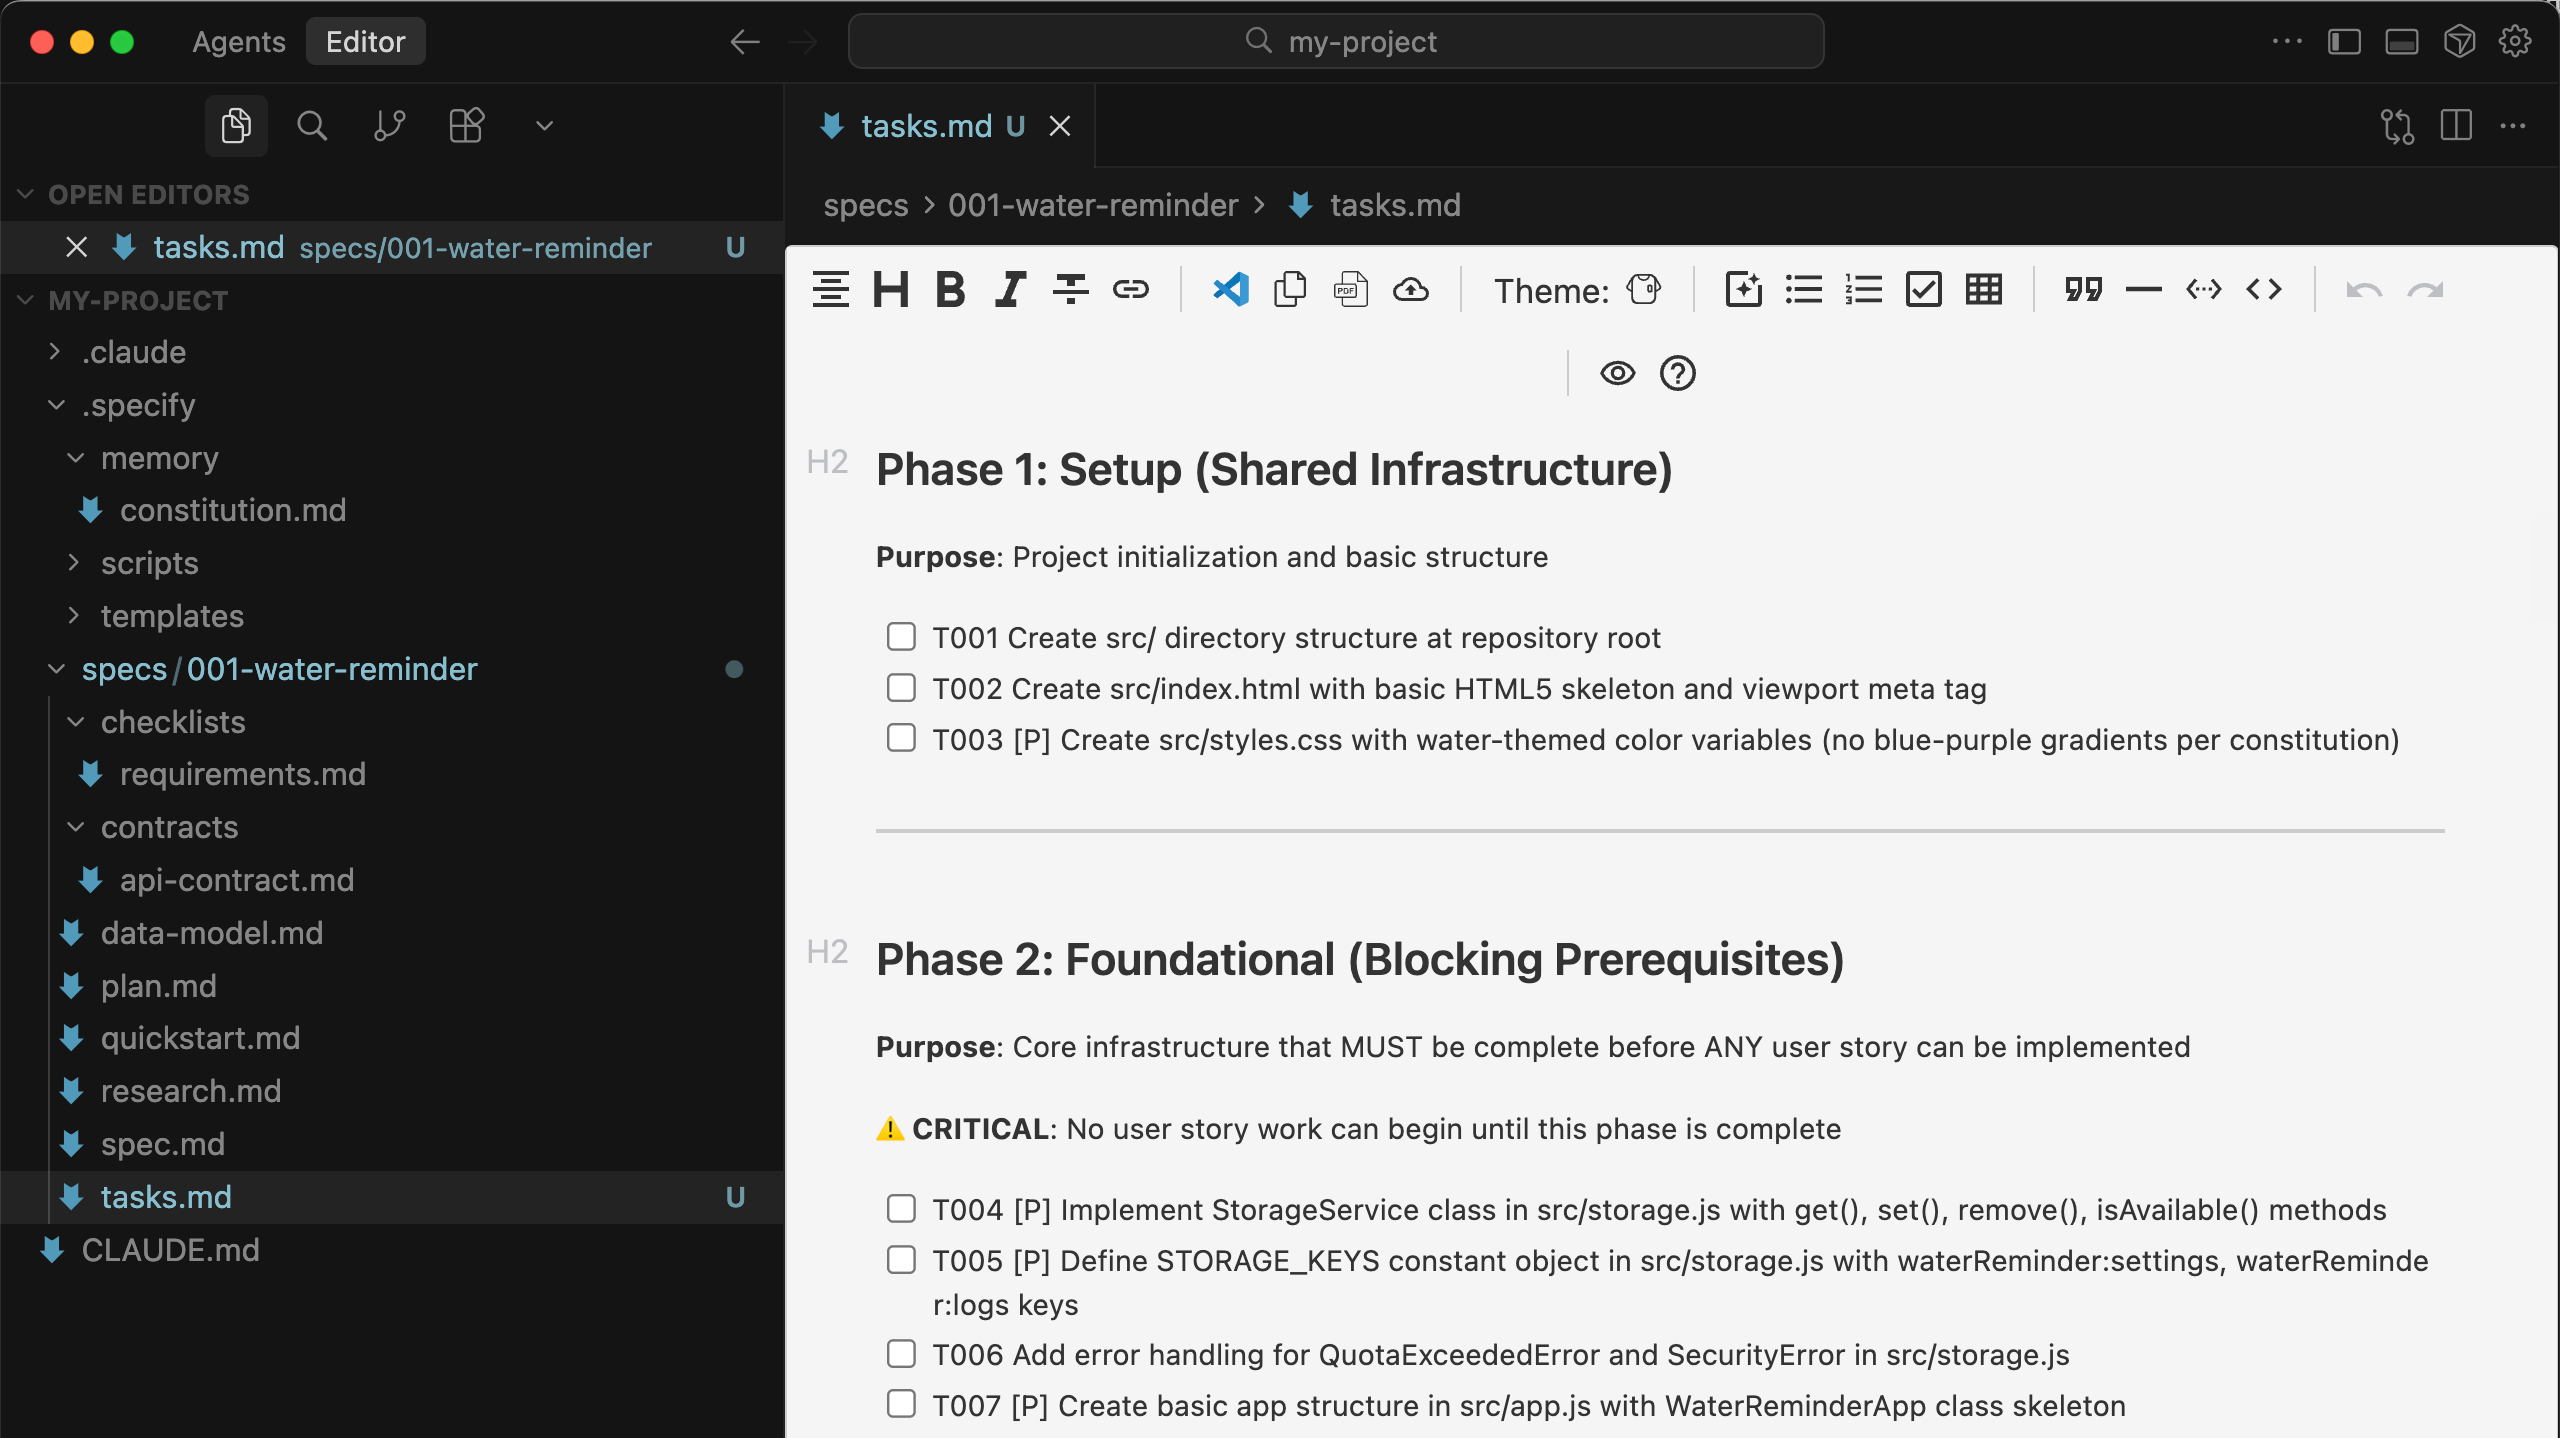
2025 年 9 月,GitHub 发布了开源的 Spec Kit 工具包,帮助开发者在 AI 编程中实践 SDD 方法论。它支持 Claude Code、GitHub Copilot 等主流编程工具,通过一套斜杠命令引导你完成上述流程。即使你不是软件开发专家,也能在 AI 的引导下轻松地走完规范的项目开发流程。
RAG 检索增强生成
RAG(Retrieval-Augmented Generation 检索增强生成)是一种让 AI 能够先检索外部知识库、再基于检索结果生成回答的技术,目标是让 AI 的回答更准确、更有依据。
普通的 AI 只能依赖训练时学到的知识,而这些知识可能已经过时了。RAG 能让 AI 在回答问题时,先从你的文档、代码库、知识库中检索相关信息,然后基于这些信息生成回答。
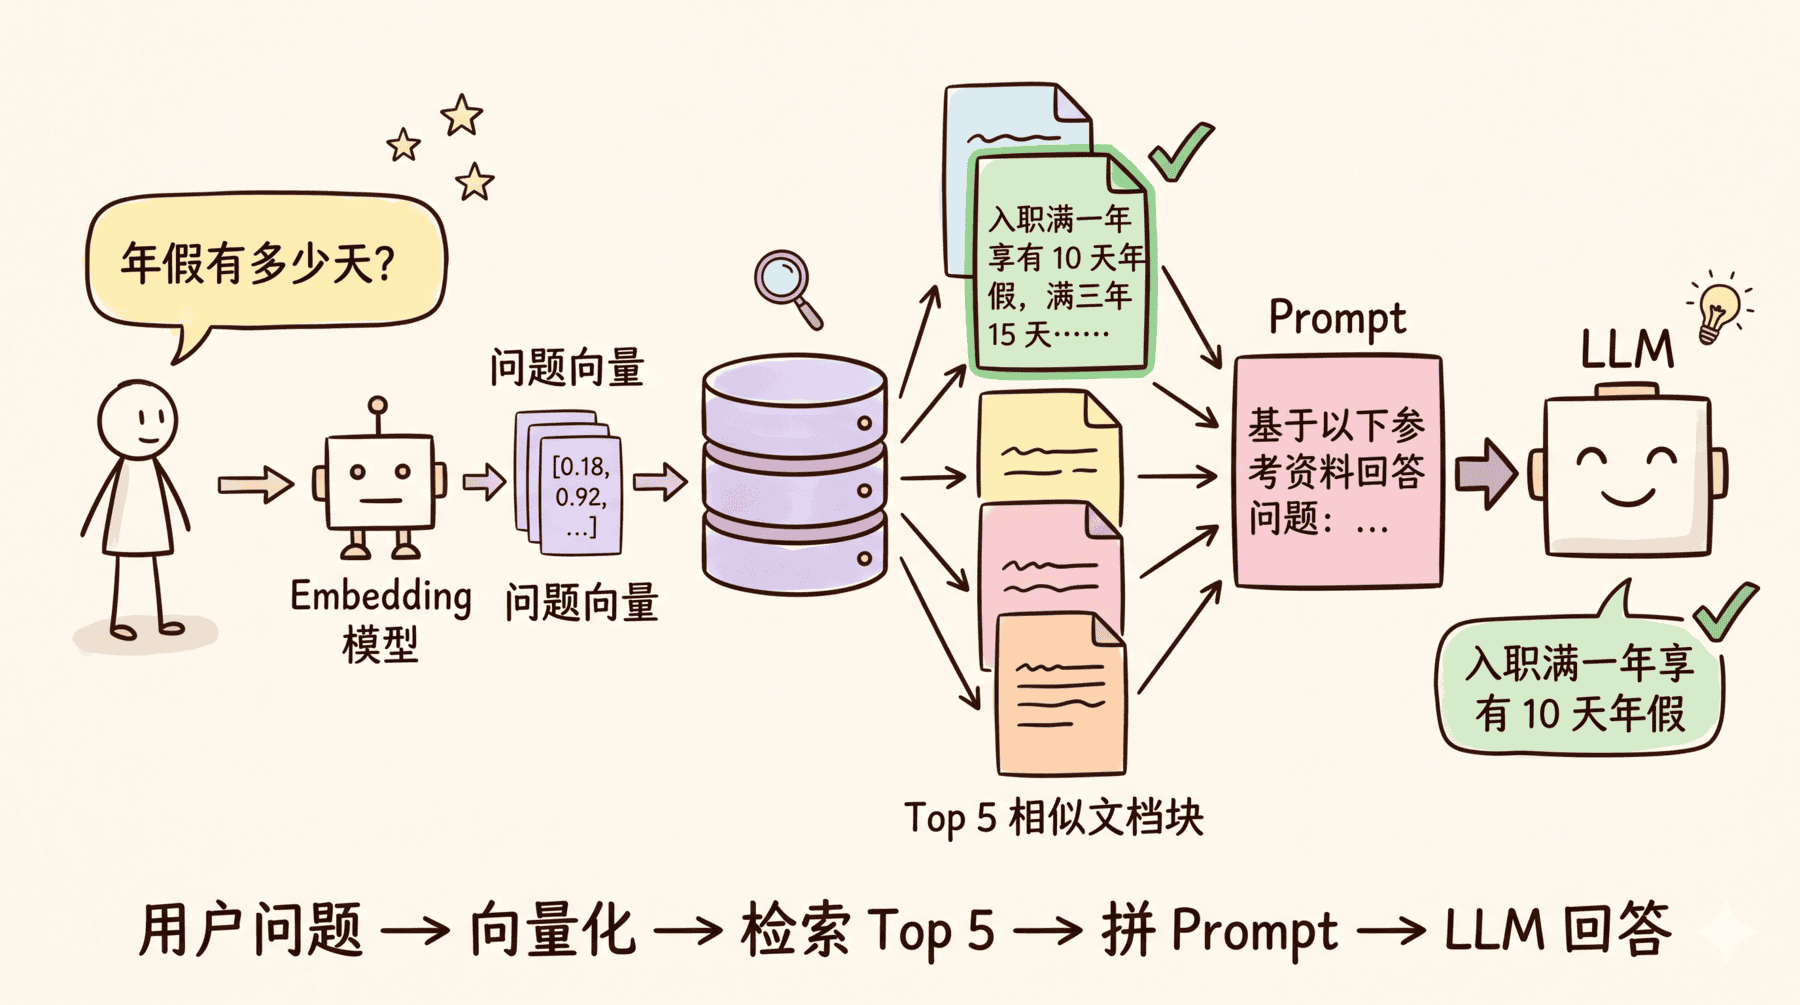
这对于企业中的 Vibe Coding 特别有用,因为 AI 可以参考你项目中的已有代码,生成风格一致的新代码。
RAG 检索增强生成的工作流程如下图所示,做 AI 应用开发的程序员朋友们可以深入了解一下:
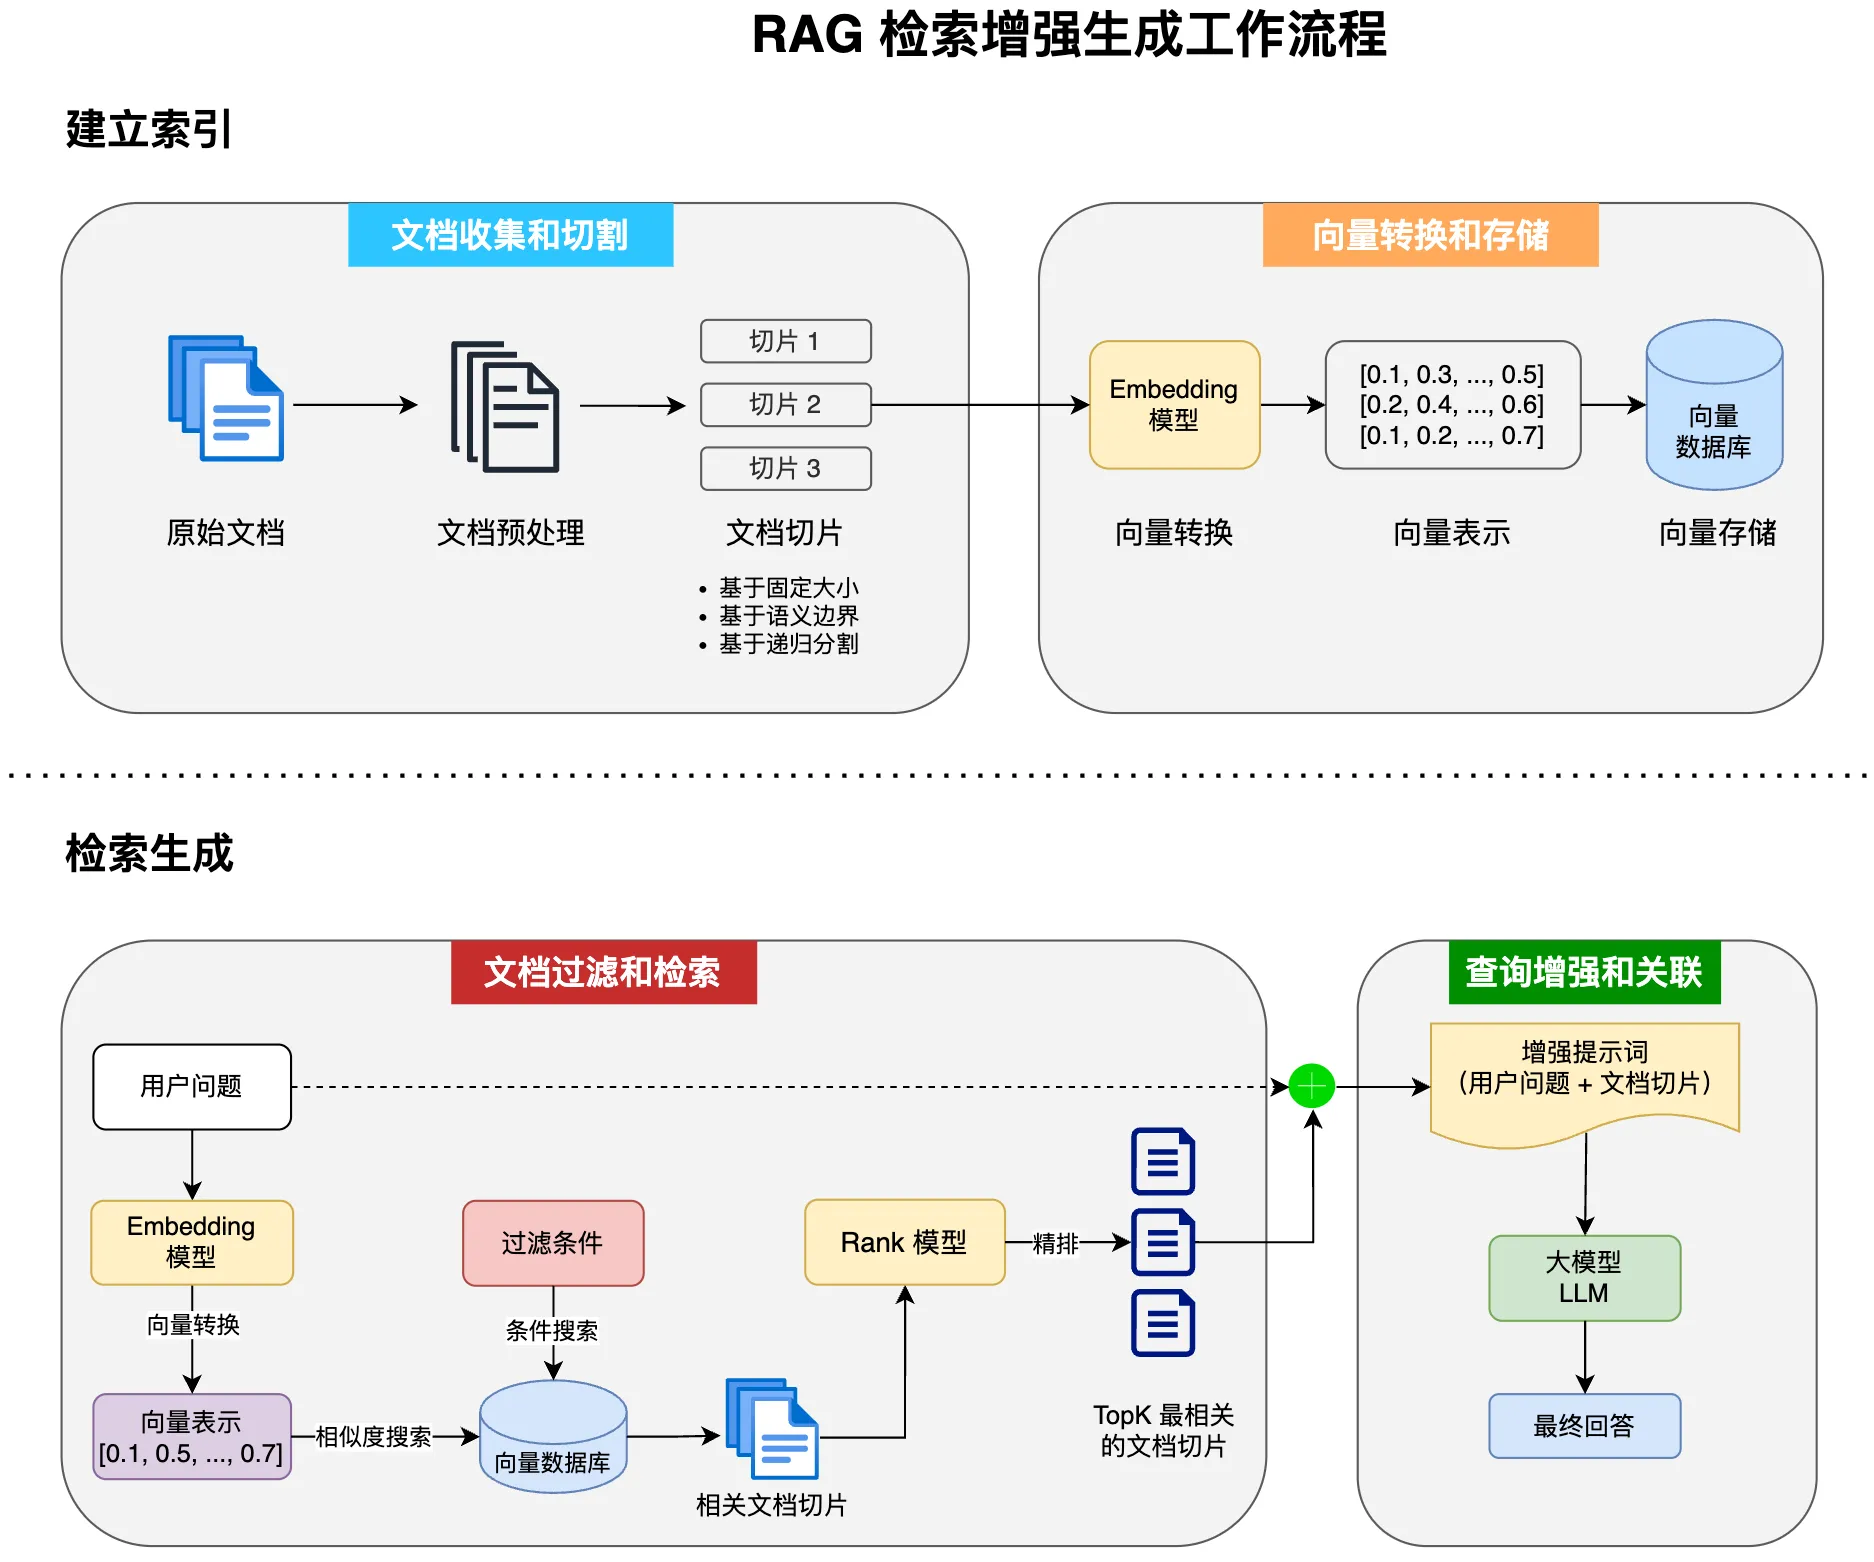
在实际工程中,RAG 已经演化出了很多进阶方案。
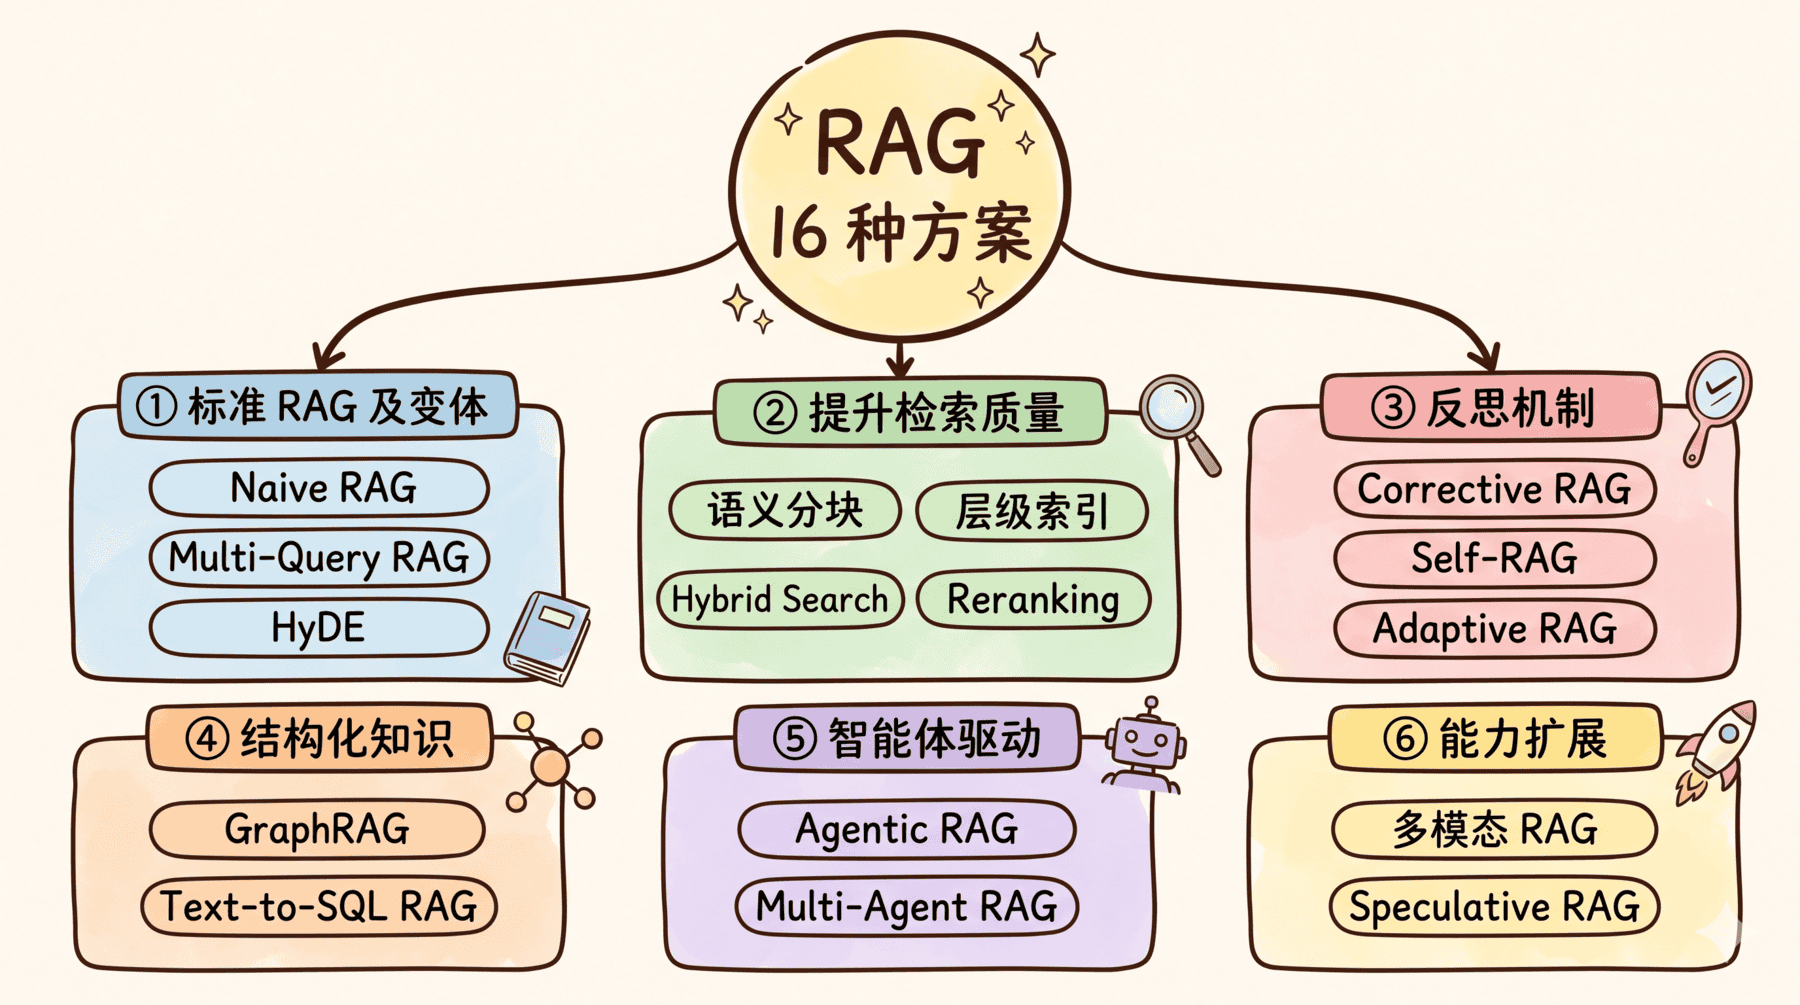
比如:
- Multi-Query RAG,用多种问法分别检索再合并结果。
- HyDE,让 AI 先生成一段假答案再用假答案的向量去检索。
- Hybrid Search,混合向量搜索和关键词搜索再融合排序。
- Reranking,在检索后用精排模型重新打分过滤噪声。
- GraphRAG,把文档变成知识图谱来支持跨文档多跳推理。
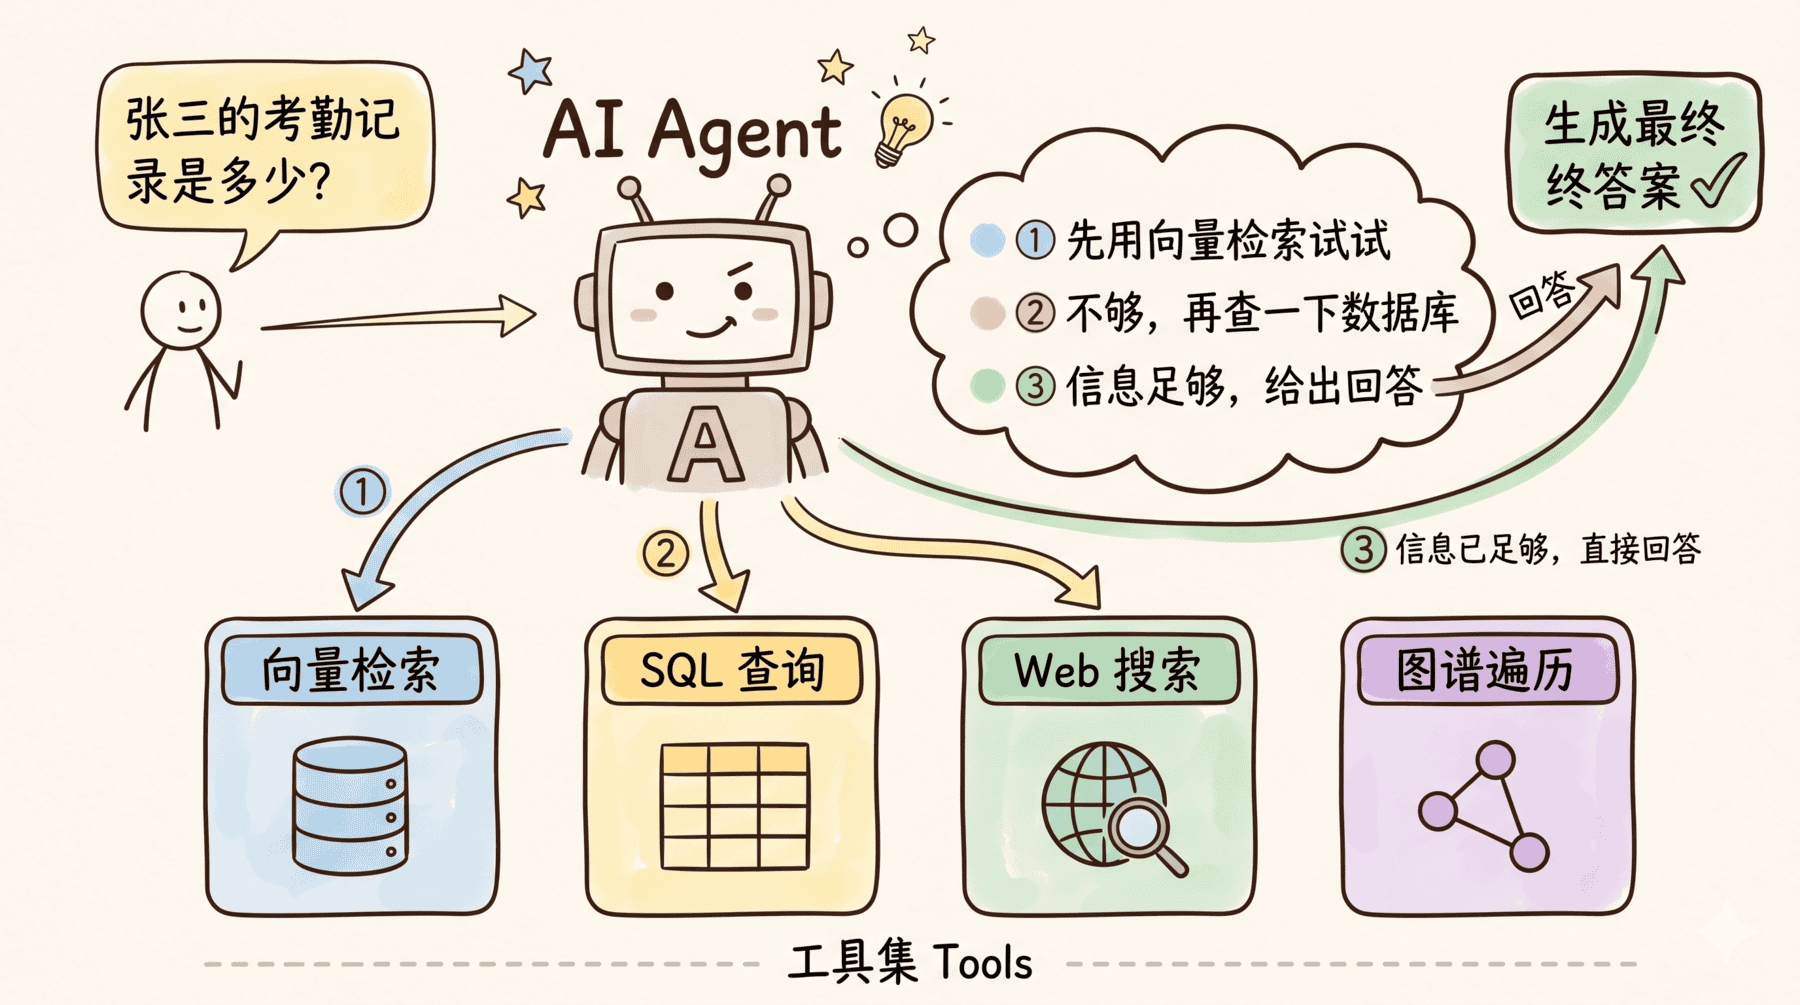
- Agentic RAG,给 Agent 配备一组检索工具,让它来自动调度,根据问题自主决定每一步该怎么做。
还有很多,不同的方案适用于不同场景,可以根据实际需求组合使用。
对 RAG 感兴趣的程序员朋友,可以阅读本教程编程学习板块的《AI 编程技术入门指南》,里面有更详细的 RAG 实现方案和选型建议。
Agentic RAG 智能体检索增强生成
Agentic RAG(智能体检索增强生成)是传统 RAG 的进化版,它把固定的 “检索 → 生成” 流水线升级成了一个由 AI 智能体控制的闭环系统。
传统 RAG 就像一个只会按流程办事的图书管理员:你问一个问题,它去书架上找一次资料,拿回来就给你答案,不管找的对不对。
而 Agentic RAG 更像一个资深的研究员:它会先思考应该从哪里找信息,找到后会判断信息是否相关,如果不够好就换个角度重新搜索,甚至同时查多个数据源,反复验证直到满意为止。

Agentic RAG 的核心能力包括:
- 多轮检索:根据需要进行多次有针对性的检索,而不是只查一次
- 动态查询改写:如果第一次没找到好结果,AI 会自动换个提法重新搜索
- 多数据源协作:同时从向量数据库、API、网页、SQL 数据库等多个来源获取信息
- 自我纠错:评估检索结果的质量,不满意就重来
典型模式包括 CRAG(纠正式 RAG,添加检索评估器)、Self-RAG(自反思 RAG,在生成过程中嵌入反思步骤)和 Adaptive RAG(自适应 RAG,根据问题类型选择不同检索策略)。
代价是更高的延迟和数倍的 Token 成本,所以更适合复杂的、高准确率要求的场景,比如法律、医疗、合规类的问题。简单的单源查询用传统 RAG 就够了。
向量数据库
向量数据库是专门用来存储和查询 “向量”(一种数字表示形式)的数据库。在 AI 领域,它常用来存储文本的语义表示。
什么是向量呢?
简单来说,向量就是一串数字组成的数组,比如 [0.1, 0.5, 0.3, 0.8]。每个数字代表一个特征维度。AI 可以把一段文字、一张图片、一段代码转换成这样的向量,语义相似的内容转出来的向量也会很接近。
当你把代码或文档存入向量数据库后,AI 就能快速找到语义相似的内容,即使搜索词和原文不完全一样。
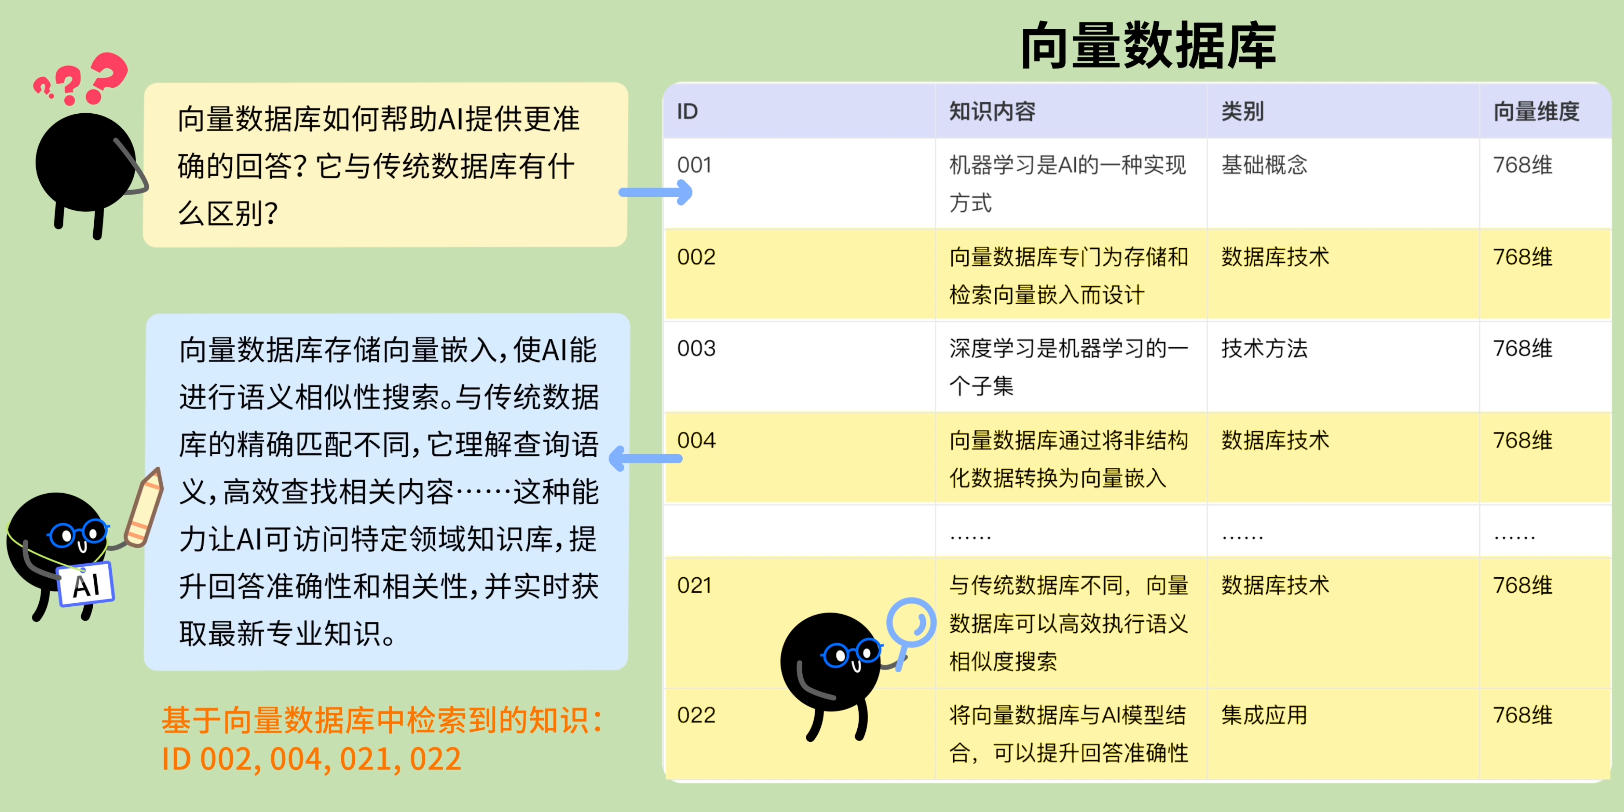
比如,你搜 “用户登录”,它能找到叫 "handleAuth" 的函数,因为它们在语义上是相关的。
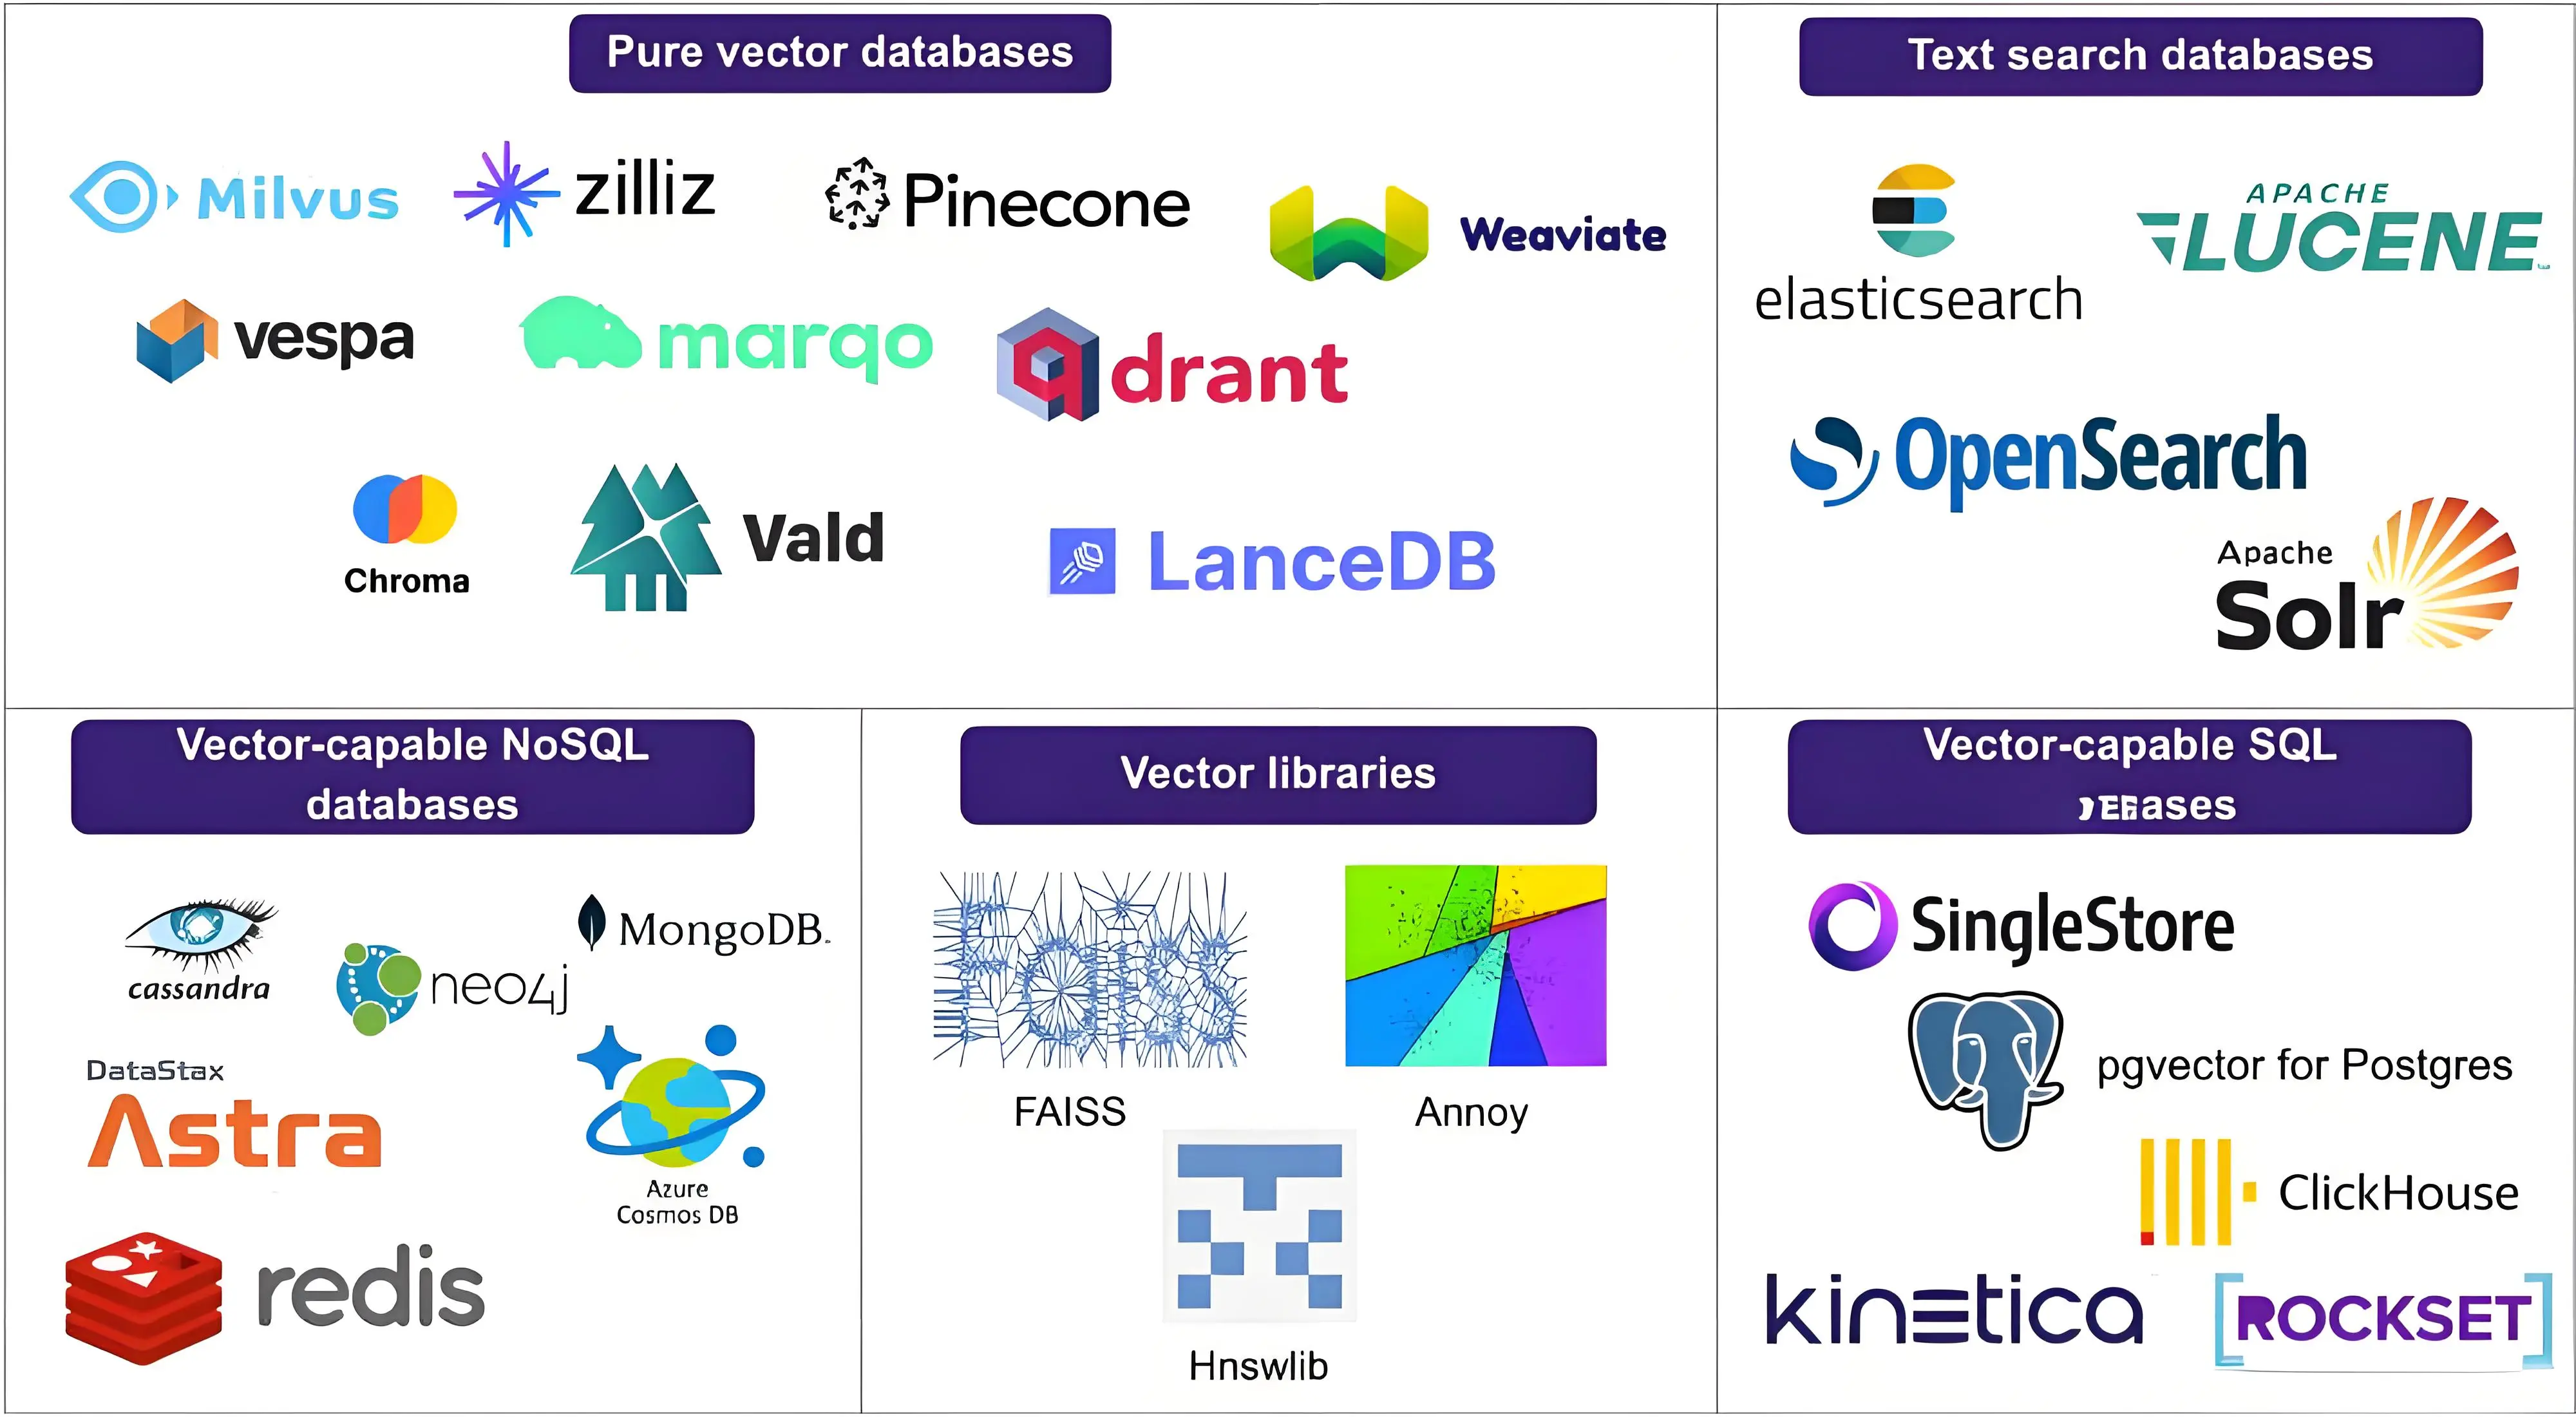
随着 AI 的爆发,市面上涌现了非常多支持向量存储的数据库:
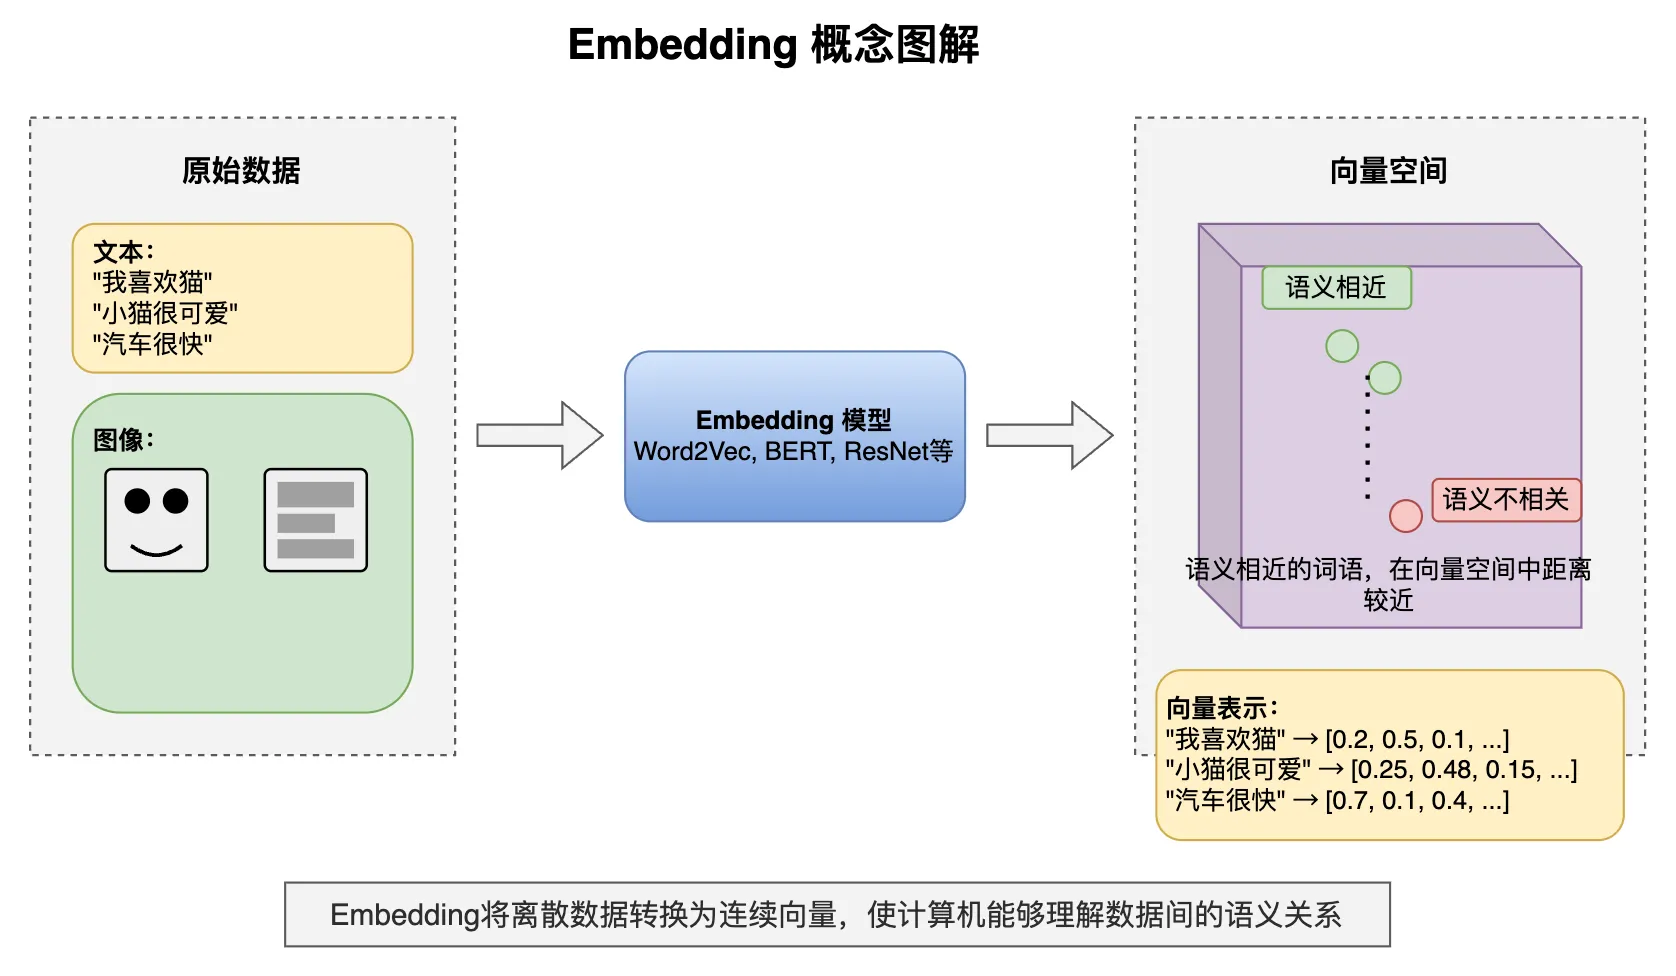
嵌入 Embedding
嵌入是把文本、代码等内容转换成数字向量的过程。这些向量能够捕捉内容的语义信息。
在向量空间中,语义相似的内容会靠得更近。这就是为什么向量数据库能进行语义搜索的原理。
你不需要深入理解嵌入的技术细节,只需要知道它是 RAG 和代码语义搜索的基础技术就好。