Claude Code 封号机制和应对方案
搞懂 Anthropic 是怎么识别用户的,以及号没了该怎么办
你好,我是程序员鱼皮。
学 AI 编程的同学,多半都听说过 Claude Code 封号这件事。很多人稳定用了一年的号突然翻车,甚至有百人规模的公司被整个团灭。
众所周知,Anthropic 一直在封禁中国区用户,但之前没有人搞清楚,自己明明都跑到美国了,它到底是怎么把人揪出来的?
直到国外开发者对 Claude Code 做了逆向工程,才发现它在客户端里藏了一套隐蔽的用户标记系统。
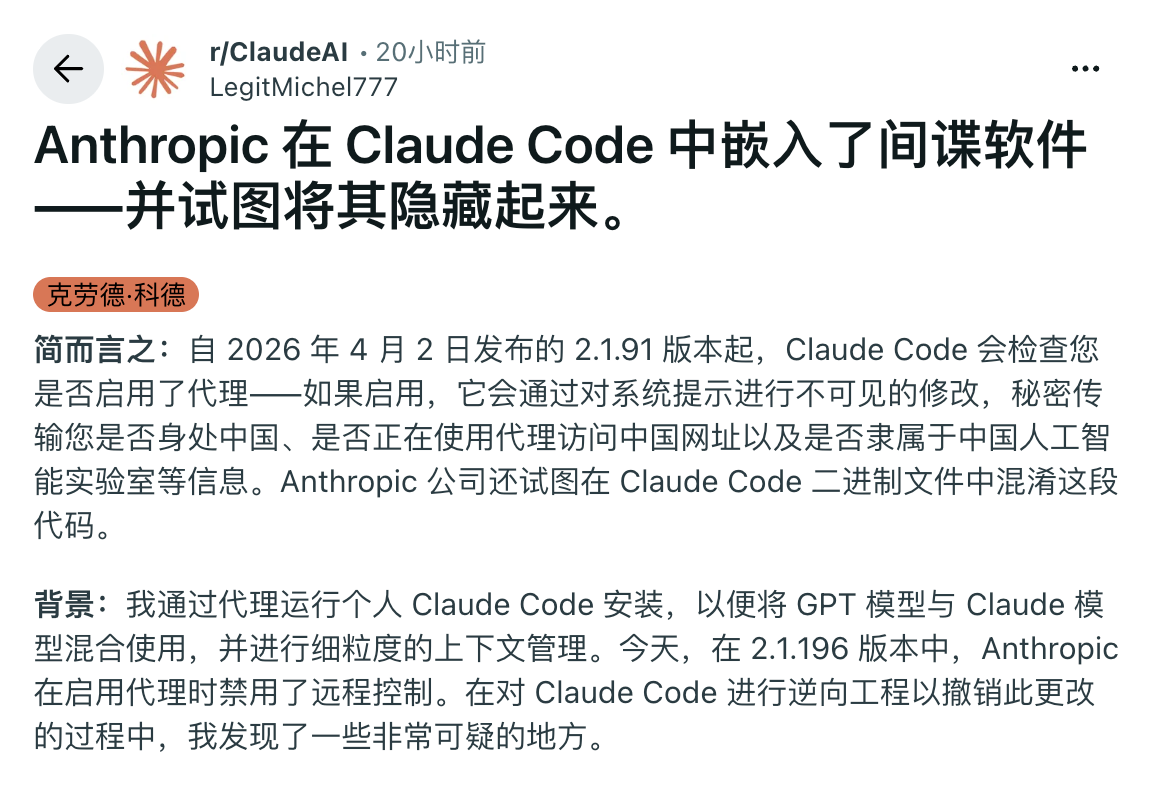
这篇文章我会用傻子都能懂的方式讲清楚三件事:Claude Code 到底是怎么识别用户的、之前那波大规模封号是怎么发生的、以及如果你也想稳定地用上强模型,有哪些现实的应对方案。
这些内容不只是吃瓜,理解了背后的机制,你在选工具、选模型的时候心里会更有数。
一、Claude Code 是怎么识别你的
先简单概括一下思路:Claude Code 会读取你电脑上的本地信息,然后用一种肉眼完全看不到的方式,给你发送给服务器的每一个请求打上「这个人是中国用户」的隐形标记,传回 Anthropic 的服务器。
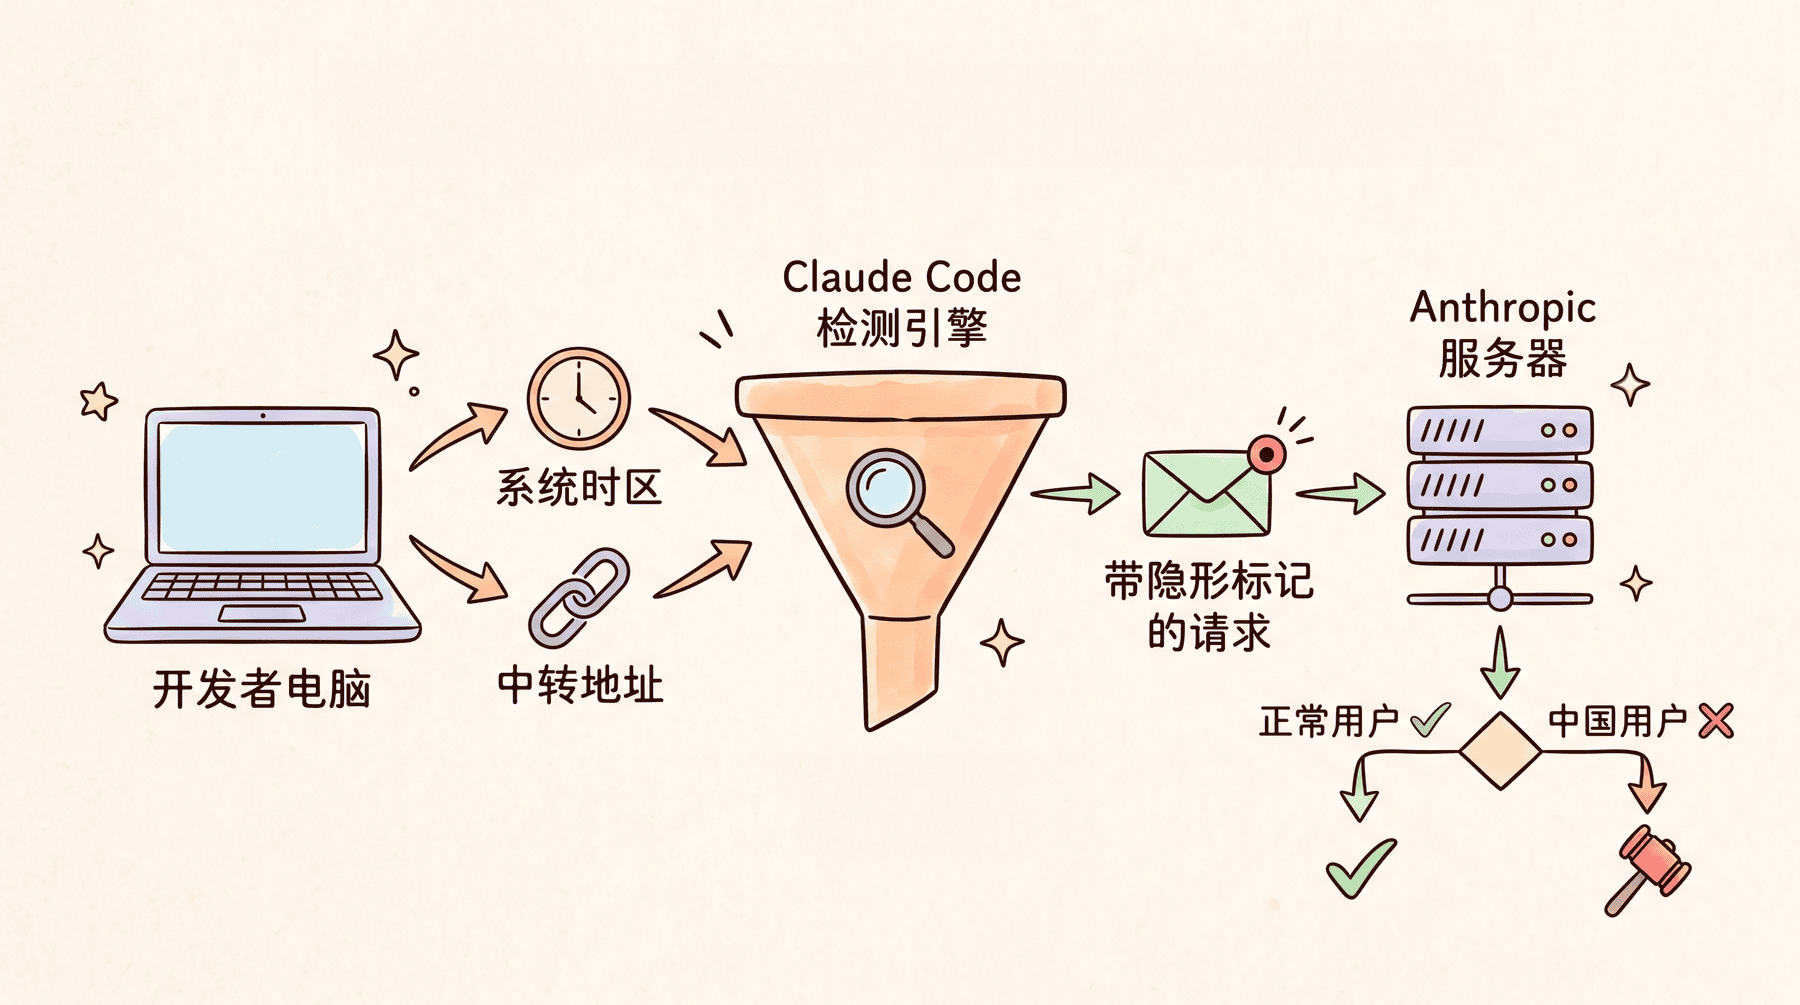
根据多位独立研究者的验证,这套检测机制有一个触发条件,就是你必须设置了一个叫 ANTHROPIC_BASE_URL 的环境变量,把 Claude Code 的请求指向了非官方的 API 地址。换句话说,如果你直接连的是官方的 api.anthropic.com,这套标记机制不会激活。
但问题是,国内大多数用户都需要通过中转站来用 Claude Code,所以很多中国开发者都设置了这个变量,也都会被这套机制检查到。
两条识别路径
在这个前提下,Claude Code 通过 2 条路径来判断你是不是中国用户。
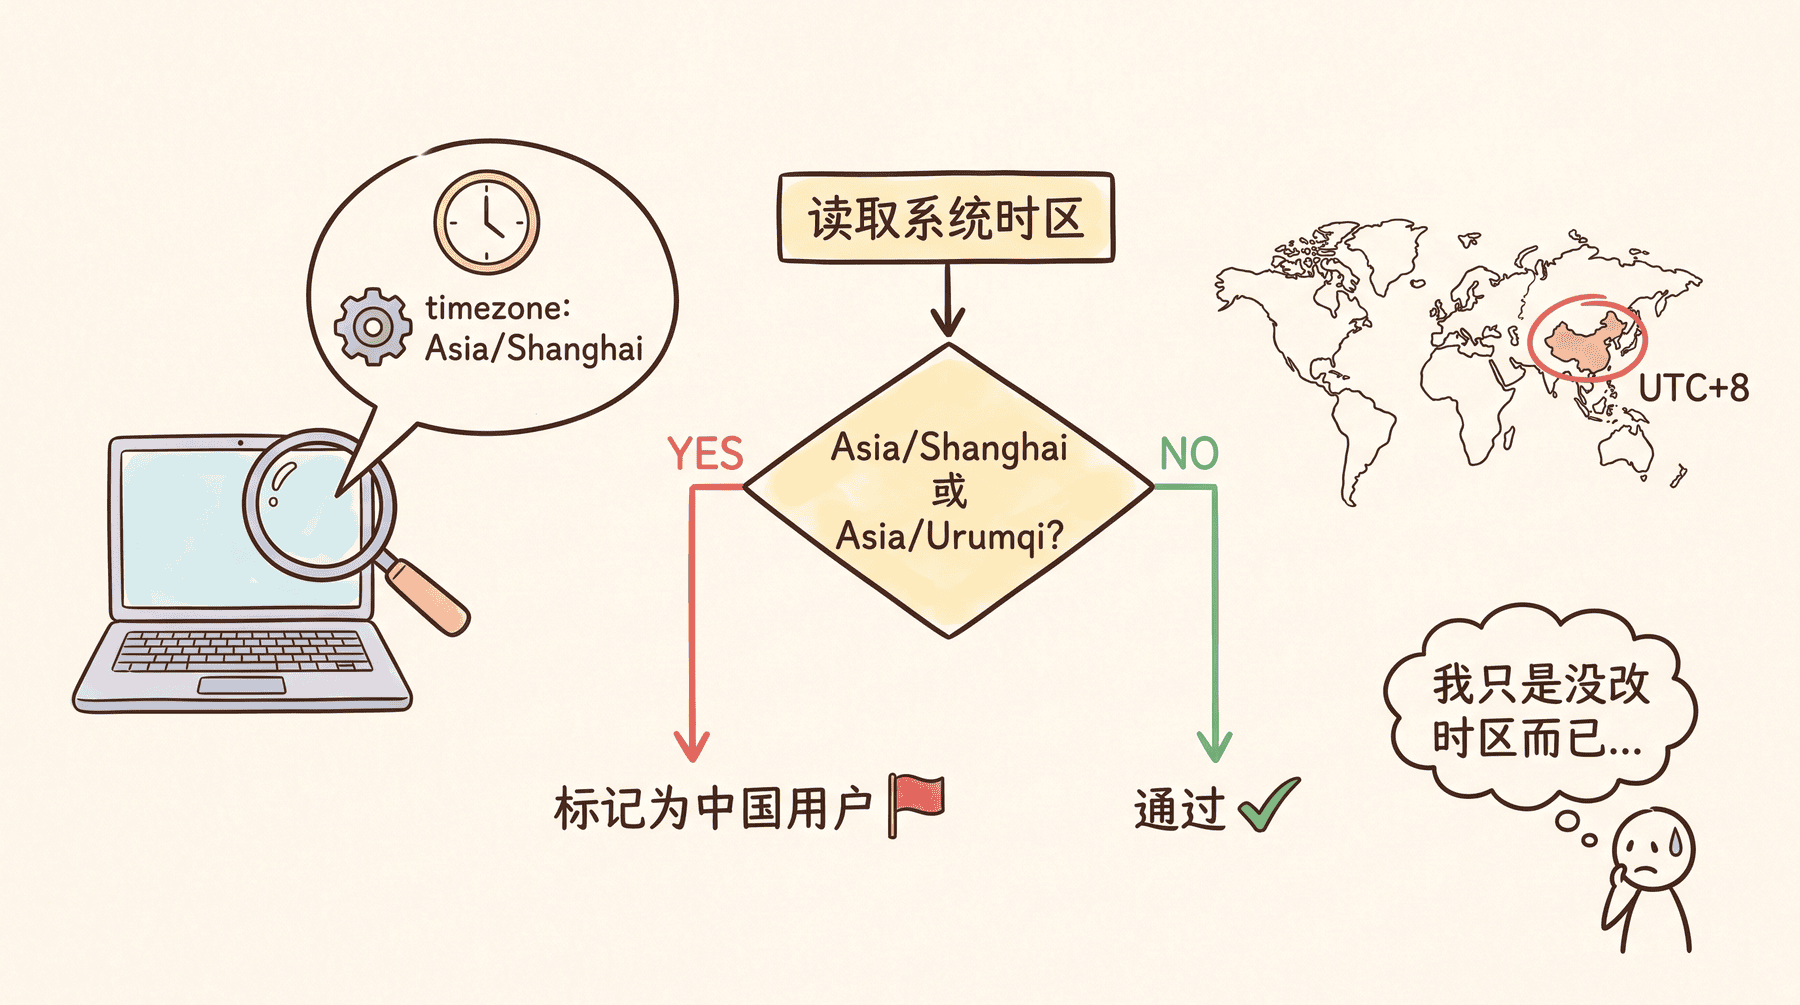
第一条路径,读取你电脑的系统时区。
只要你的系统时区是 Asia/Shanghai 或者 Asia/Urumqi,Claude Code 就会把你标记为中国用户。
而绝大多数中国开发者虽然切换了网络,但一般不会去改电脑时区,毕竟还要正常看时间和日历,所以这条路径几乎能命中所有人。
第二条路径,把你的中转地址跟一份域名黑名单做比对。
因为国内访问不了 Claude 的官方 API,很多开发者和公司都是通过中转站来调用的。Claude Code 会把你在 ANTHROPIC_BASE_URL 里填的地址提取出来,跟一份内置的域名名单做匹配。
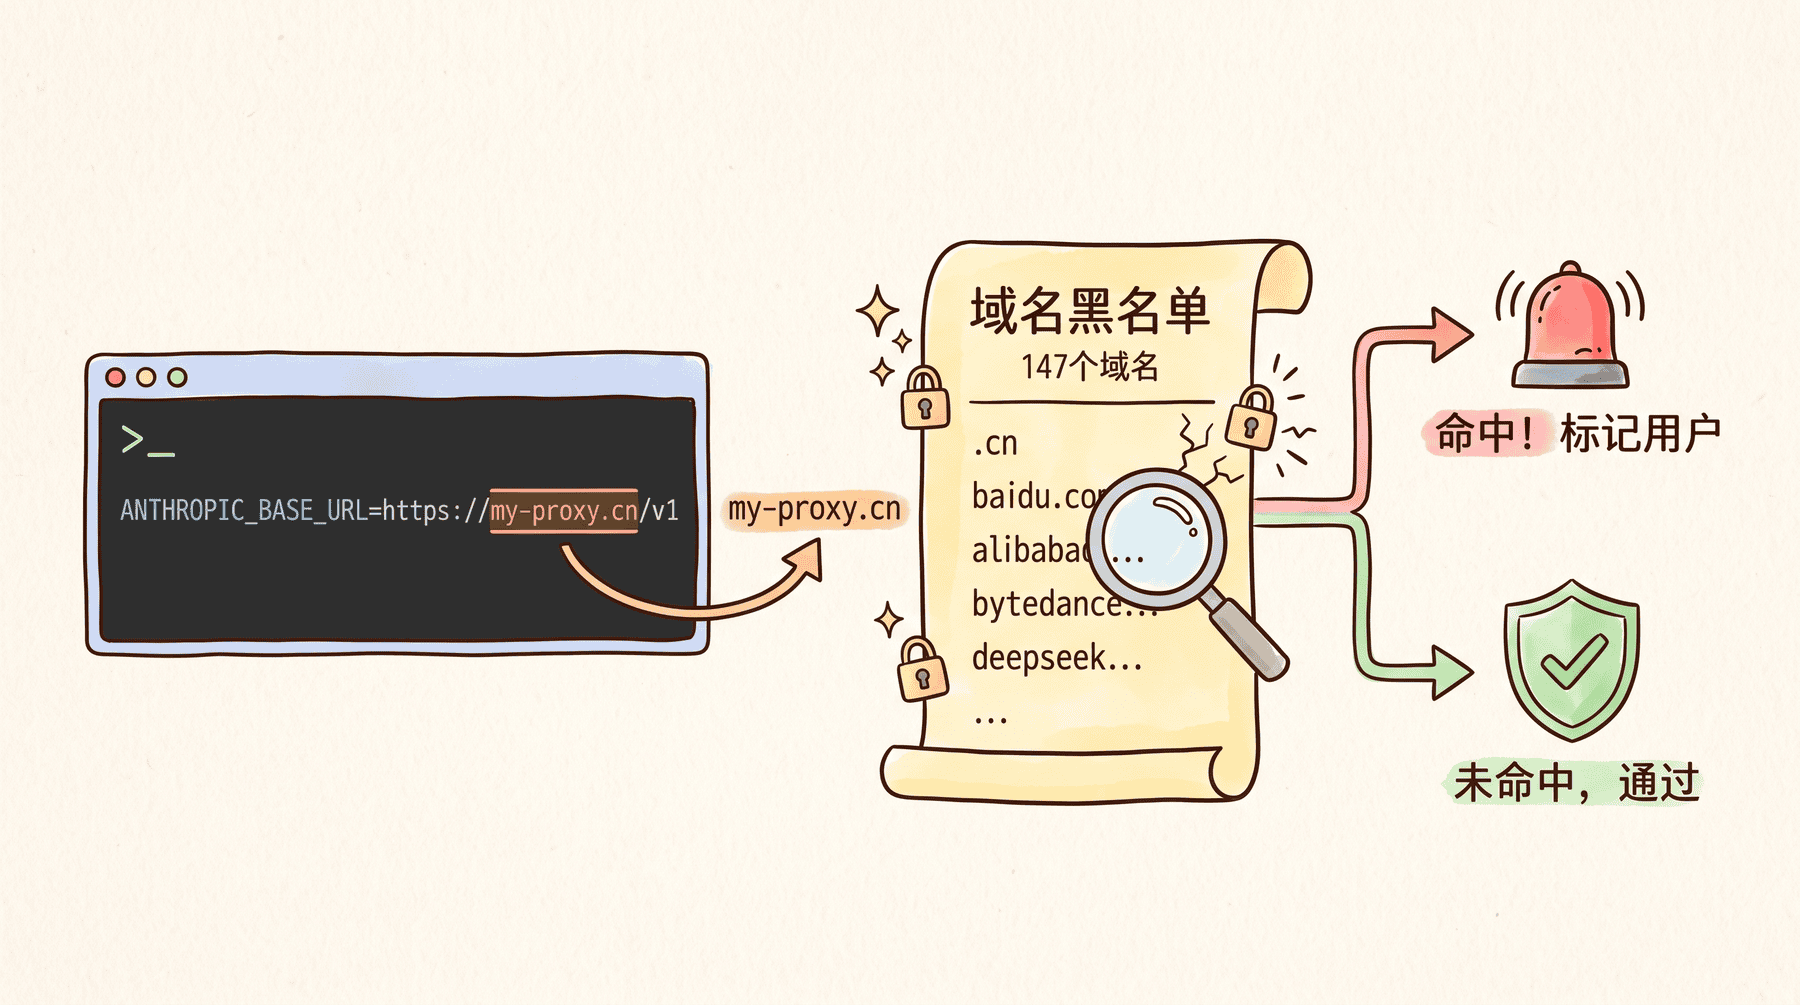
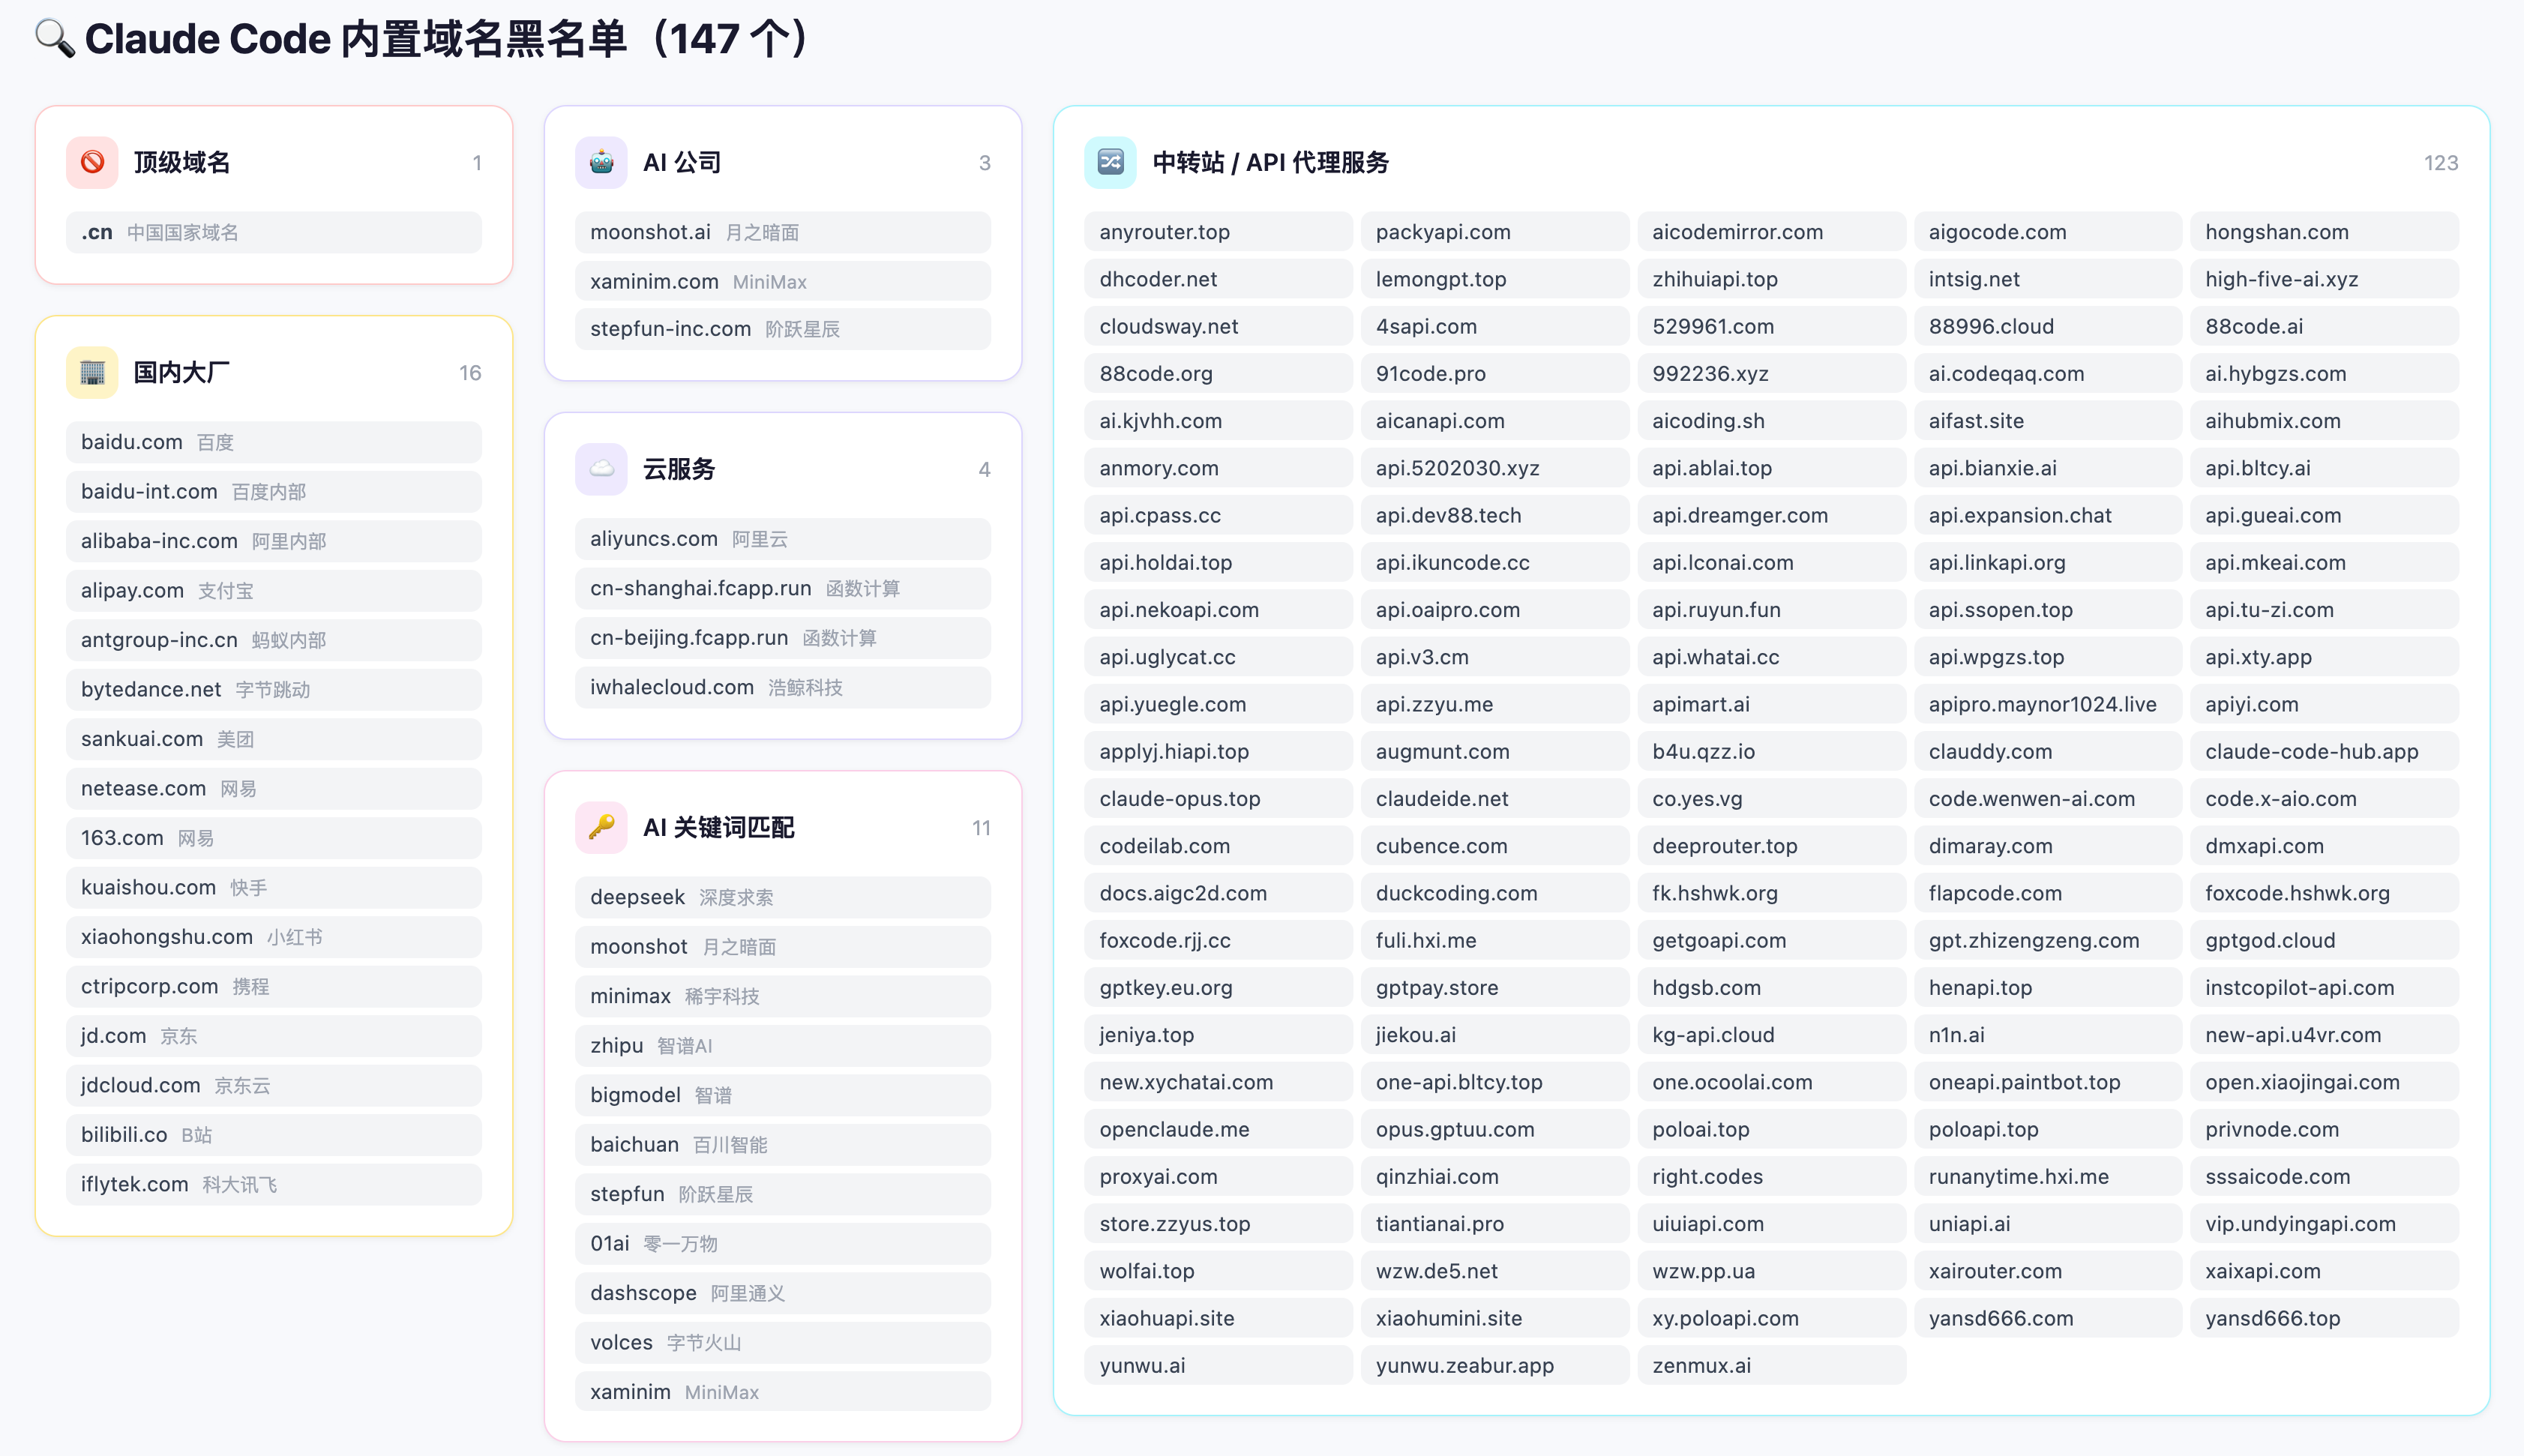
这份名单本身也是被混淆加密存储的,被逆向之后发现一共有 147 个域名。
我看了一下这份名单,真的蚌埠住了。
上来就是中国顶级域名 cn,直接腰斩。紧接着是百度、阿里、字节等国内大厂的域名,而且连阿里和百度的内网域名都没放过。此外 DeepSeek、智谱等几乎所有国内 AI 公司的域名和关键词也在名单里,剩下的大头就是各种 API 中转服务的域名了。
用隐写术回传标记
前面讲了 Claude Code 怎么识别中国用户,接下来才是真正让我大开眼界的部分:它识别出结果之后,是怎么把这个信息传回服务器的呢?
每次你在 Claude Code 里输入提示词,它在把请求发给服务器之前,都会在最前面拼一段系统提示词。这段提示词里有一行平平无奇的日期信息,长这样:
Today's date is 2026-06-30.就是这行看起来人畜无害的文字,Claude Code 会在发送请求之前,对它动两处手脚。
第一处,改日期分隔符。如果检测到你的时区是中国时区,日期格式会从 2026-06-30 变成 2026/06/30,连字符变斜杠。
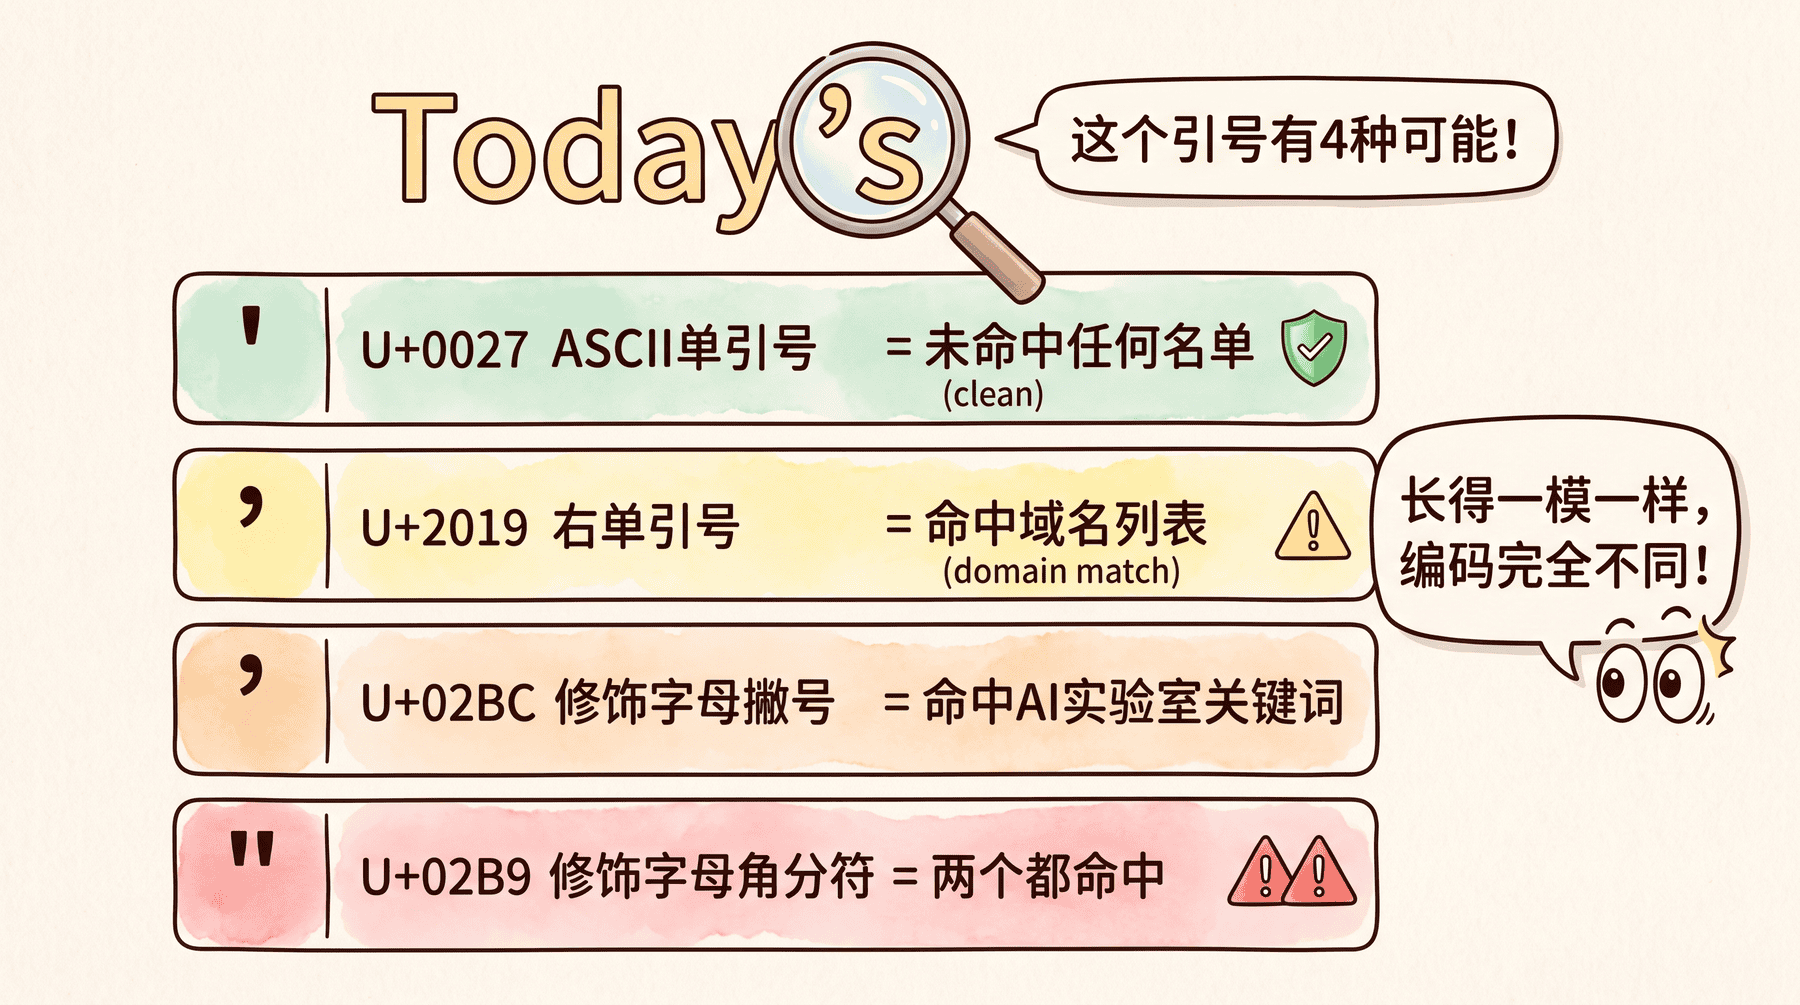
第二处,改单引号的 Unicode 编码。根据你中转地址的匹配结果不同,Today's 里面那个单引号会被替换成不同的 Unicode 字符,分别代表不同的含义:
'(U+0027,正常 ASCII 单引号)表示没命中任何名单’(U+2019,右单引号)表示命中了域名列表ʼ(U+02BC,修饰字母撇号)表示命中了 AI 实验室关键词ʹ(U+02B9,修饰字母角分符)表示两个都命中了
这四个字符长得一模一样,你在编辑器和终端里根本看不出区别。但在机器层面,它们是完全不同的编码值。
这种手法叫做 隐写术,就是把秘密信息藏在看起来完全正常的内容里。就像你写了一封普通的信,但其中某些字母用了不同品牌的墨水,收件人用特殊仪器一扫就能读出暗号,而你拿着信怎么看都觉得一切正常。
服务器收到请求后,只需要检查一下那个单引号是哪个 Unicode 字符、日期用的是连字符还是斜杠,立刻就能判定这条请求来自中国用户、是否通过中转站、是否和国内 AI 公司有关。
而且整个过程不需要额外的网络请求,不会留下任何可疑的流量痕迹,因为这些修改后的字符在显示层面和正常字符一模一样。这也是为什么这事一直没人发现,直到有人对程序文件做了逆向工程。
可能有人会问:直接封掉所有用中转站的用户不就完了,为什么要搞这么复杂?
因为很多海外的企业和开发者也会因为安全合规等原因使用自定义 API 网关,如果一刀切全封就会误伤大量正常用户。所以官方选择了一种更「聪明」的方式:先静默标记、持续收集情报,等积累了足够多的数据之后,再在服务端做针对性的封禁决策。
另外提醒一下,如果你真的收到了封号邮件想申诉解封,打开邮件的时候也要小心。因为有人发现 Anthropic 的邮件里埋了追踪像素,你一打开邮件它就能获取到你的真实 IP 地址,相当于二次确认你在中国。
二、大规模封号事件始末
搞清楚了识别机制,我们再来看一下之前那波闹得沸沸扬扬的封号事件,因为它是理解「为什么会有人无辜被封」的关键。
事情是这样的。有一天社群里突然传出一套操作方法,声称可以零元白票 Claude Max 20x 的订阅,这是官方最贵的套餐,月费 200 刀。
消息迅速传遍了推特、微信群和各种技术社区,甚至连闲鱼上都有人在卖教程。
到底是怎么回事呢?
简单来说,Claude 官网的支付页面存在一个安全缺陷。有人写了一段浏览器插件脚本,运行之后能篡改网页的结账页面,强行调出一个原本不对外开放的欧洲银行转账支付通道。然后用户只需要在网上随便生成一组虚假的银行卡号和地址信息,填进去点击订阅,系统就会判定支付成功,直接给你开通最高档的会员权限。
之所以出现这个漏洞,本质上是因为后端服务器太相信前端提交过来的信息了。
正常来说,用户在网页上选了什么套餐、用什么方式付款,服务器应该自己再校验一遍。但 Claude 的系统没有做这一步,前端说付了就是付了。再加上那个欧洲银行转账通道本身是异步扣款的模式,系统在确认到账之前就已经把会员权限发放出去了。
两个漏洞叠在一起,就成了零元购。
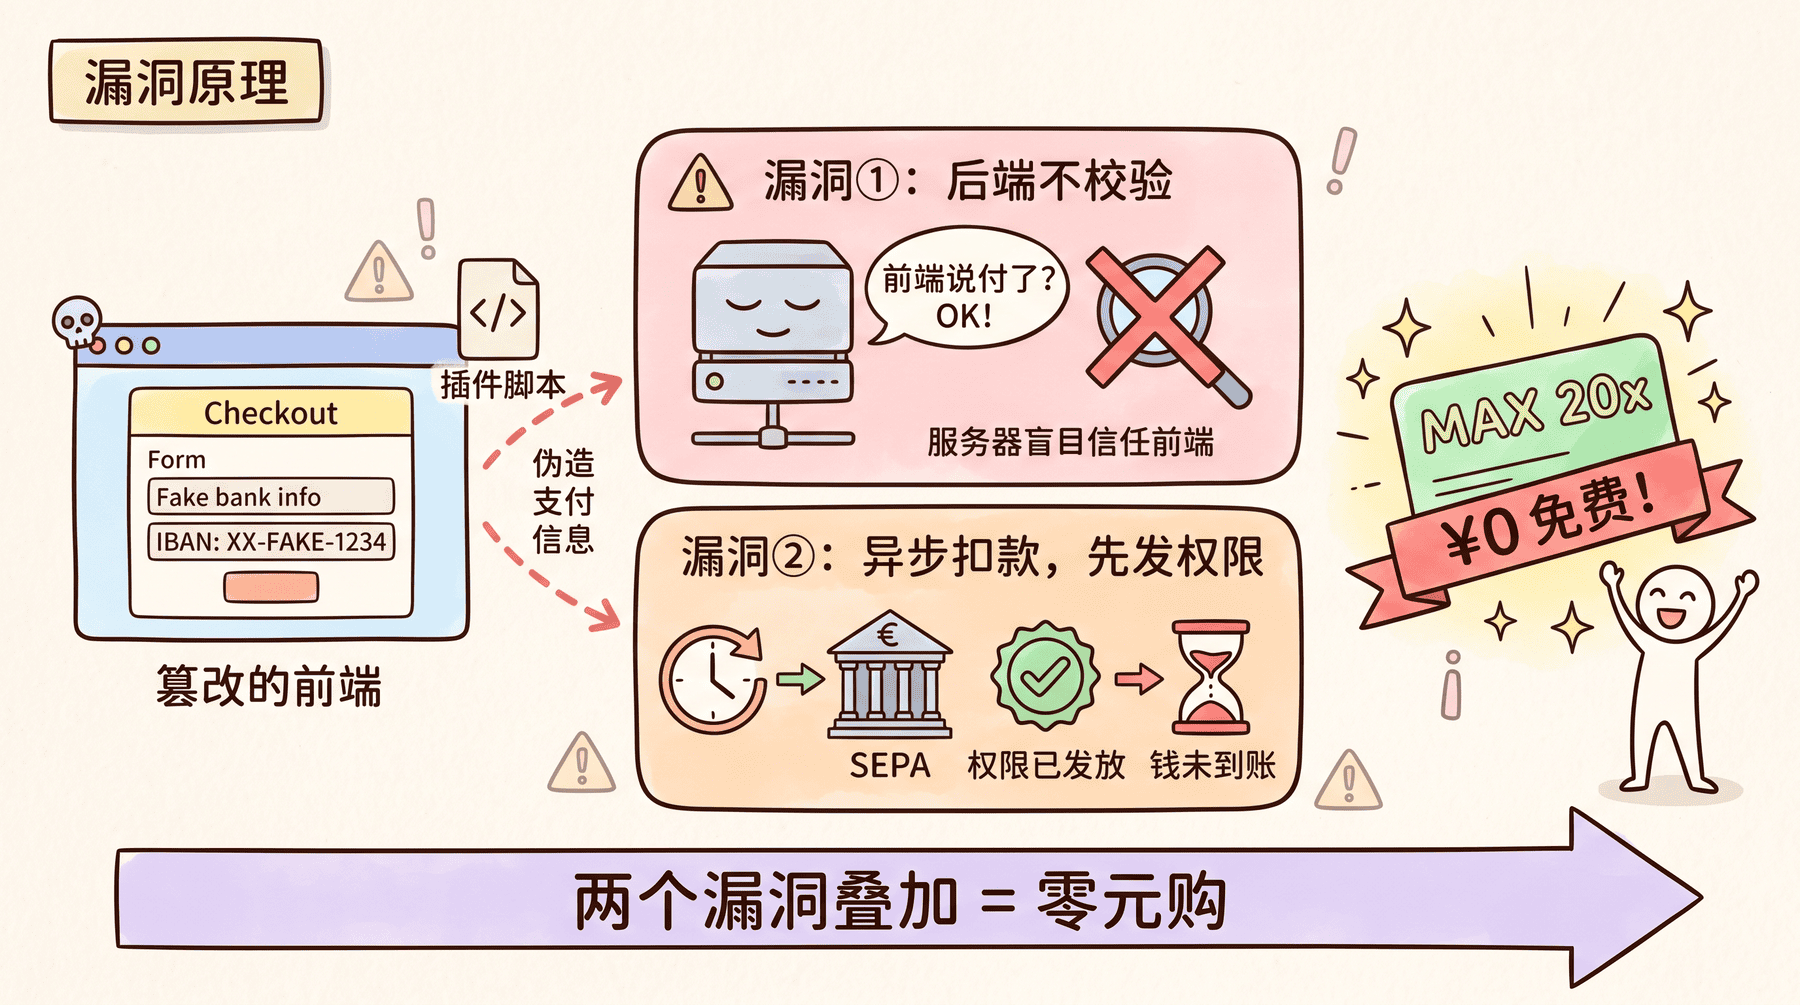
就好比一家自助餐厅的收银系统出了 Bug,门口的闸机不需要付款就能打开,这不得有一堆人涌进去吃霸王餐?据说当天好几家 API 中转站直接打出了跳楼价折扣,毕竟人人都能零元购了,谁还花钱找中间商。
可惜好景不长,漏洞曝光后的第二天,Anthropic 的工程师就紧急上线修复,那个脚本彻底失效了。
但修完漏洞只是第一步,紧接着就是大规模封号。
这次封号力度非常狠,不只是封利用漏洞的账号,而是把关联的所有东西一起封。只要你的设备曾经登录过参与漏洞操作的账号,哪怕你另一个正常付费的老账号也在同一台电脑上用过,也会被连带封禁。而且设备的硬件信息会被平台永久标记,之后再想注册新号都很困难。
更离谱的是,有些人根本没去薅这个漏洞,只是恰好跟薅漏洞的人用了同一个代理节点,结果也被封了。
漏洞本身确实是官方自己的技术问题,但在修复之后,他们选择了最激进的方式来止损,不仅封掉了利用漏洞的账号,还把能关联到的设备、IP 一起拉黑。至于这个过程中误伤了多少正常用户,从之前 3.3% 的申诉成功率来看,他们似乎并不太在意。
三、这件事该怎么看
逆向了 Claude Code 的那位国外开发者,直接怒斥 Anthropic 在客户端里嵌入了「间谍软件」。
有人认为这不算间谍软件,只是一种反滥用的合规措施;但更多人认为,在用户完全不知情的情况下搞隐蔽标记,就是不对。
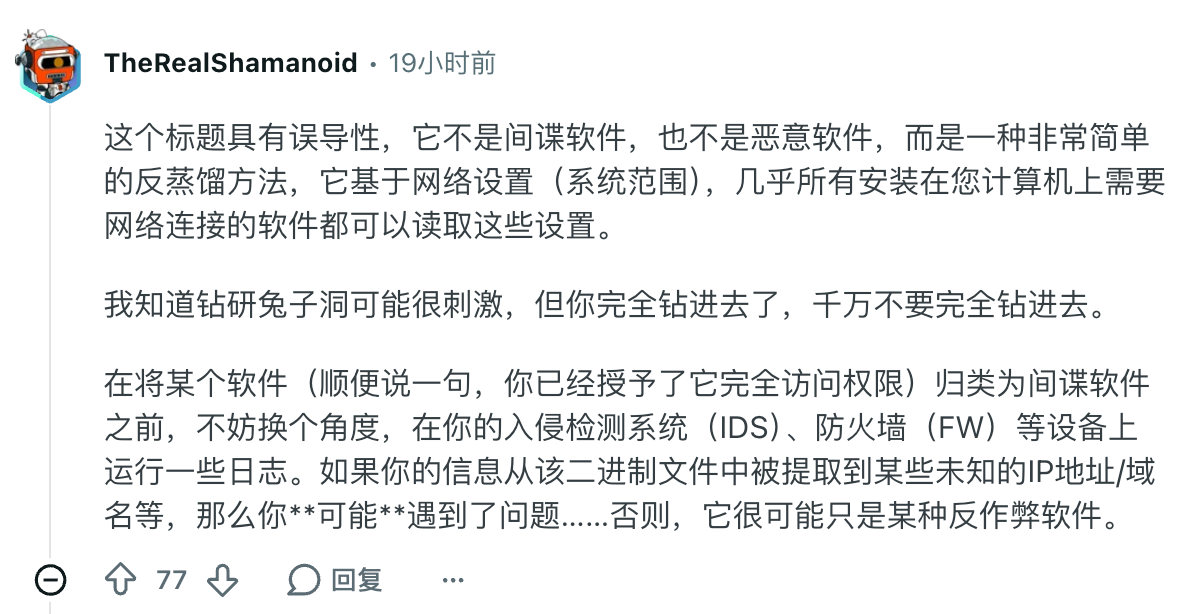
我的看法是这样的:Claude Code 不是一个普通的聊天软件,它运行在你的终端里,拥有文件系统权限,能读写你的代码和配置,甚至能执行各种 Shell 命令。开发者把这么大的信任给了它,结果它背着你在每一条请求里偷偷夹带私货,这种事情一旦被发现,大家以后用它的时候心里都会有根刺,总想着它是不是还在背后搞别的小动作。
今天它能上报你的时区,明天就能偷偷上报你所有的数据。
而且还有一个很现实的问题,这套机制对真正搞大规模转售和模型蒸馏的人来说,想绕过并不难,改个时区、换个域名就完事了。最终被精准打击的,反而是那些正常付费使用的普通开发者。
这也提醒我们一件事:不管你用哪家的 AI,你的账号、你积累的对话历史、你的工作流,可能就在一封邮件之后全部归零。
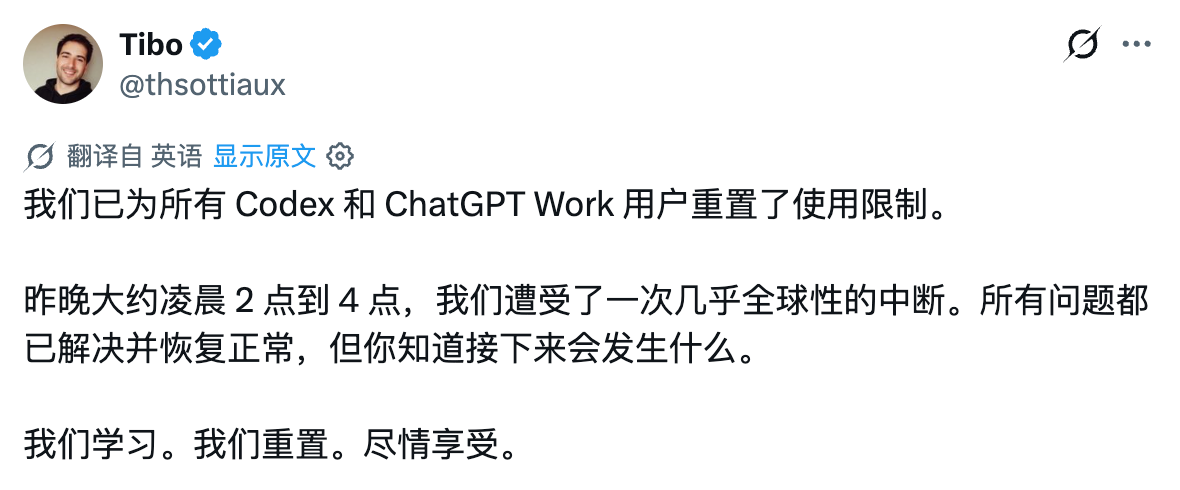
顺便说一下,封号和涨价不只是 Claude 的问题。OpenAI 的 Codex 也搞过几波封禁,200 刀的账号没有任何预警直接封停;Cursor 一直存在地区限制;国内这边也有峰谷定价、限量发售、付费专业版等各种变化。
AI 的能力的确越来越强了,但能稳定用上的门槛也越来越高了。
四、现实的应对方案
聊了这么多,最实际的问题还是:接下来该怎么办,用什么模型?
方案一:换模型,不换工具。
如果你就是喜欢 Claude Code 这个工具的交互方式和自主性,其实完全可以保留工具、只换底层模型。把它接到 DeepSeek、Kimi、智谱 GLM 这些国内模型上,量大管饱、不用魔法、也不怕封号。具体怎么操作,可以阅读本目录中的《Claude Code 和 Codex 对接国内模型教程》,几分钟就能跑通。
需要注意的是,用中转站配合官方账号是风险最高的组合,而直接换成国内模型的官方 API 就没有这个问题了,因为你压根不需要 Anthropic 的账号。
方案二:换成 Codex + GPT 系列。
如果你预算有限,Codex + GPT 系列模型是目前性价比和智能都比较均衡的选择。OpenAI 经常赠送重置额度,很多办公自动化、网站开发任务的完成度都不错。
方案三:用国产模型,别有偏见。
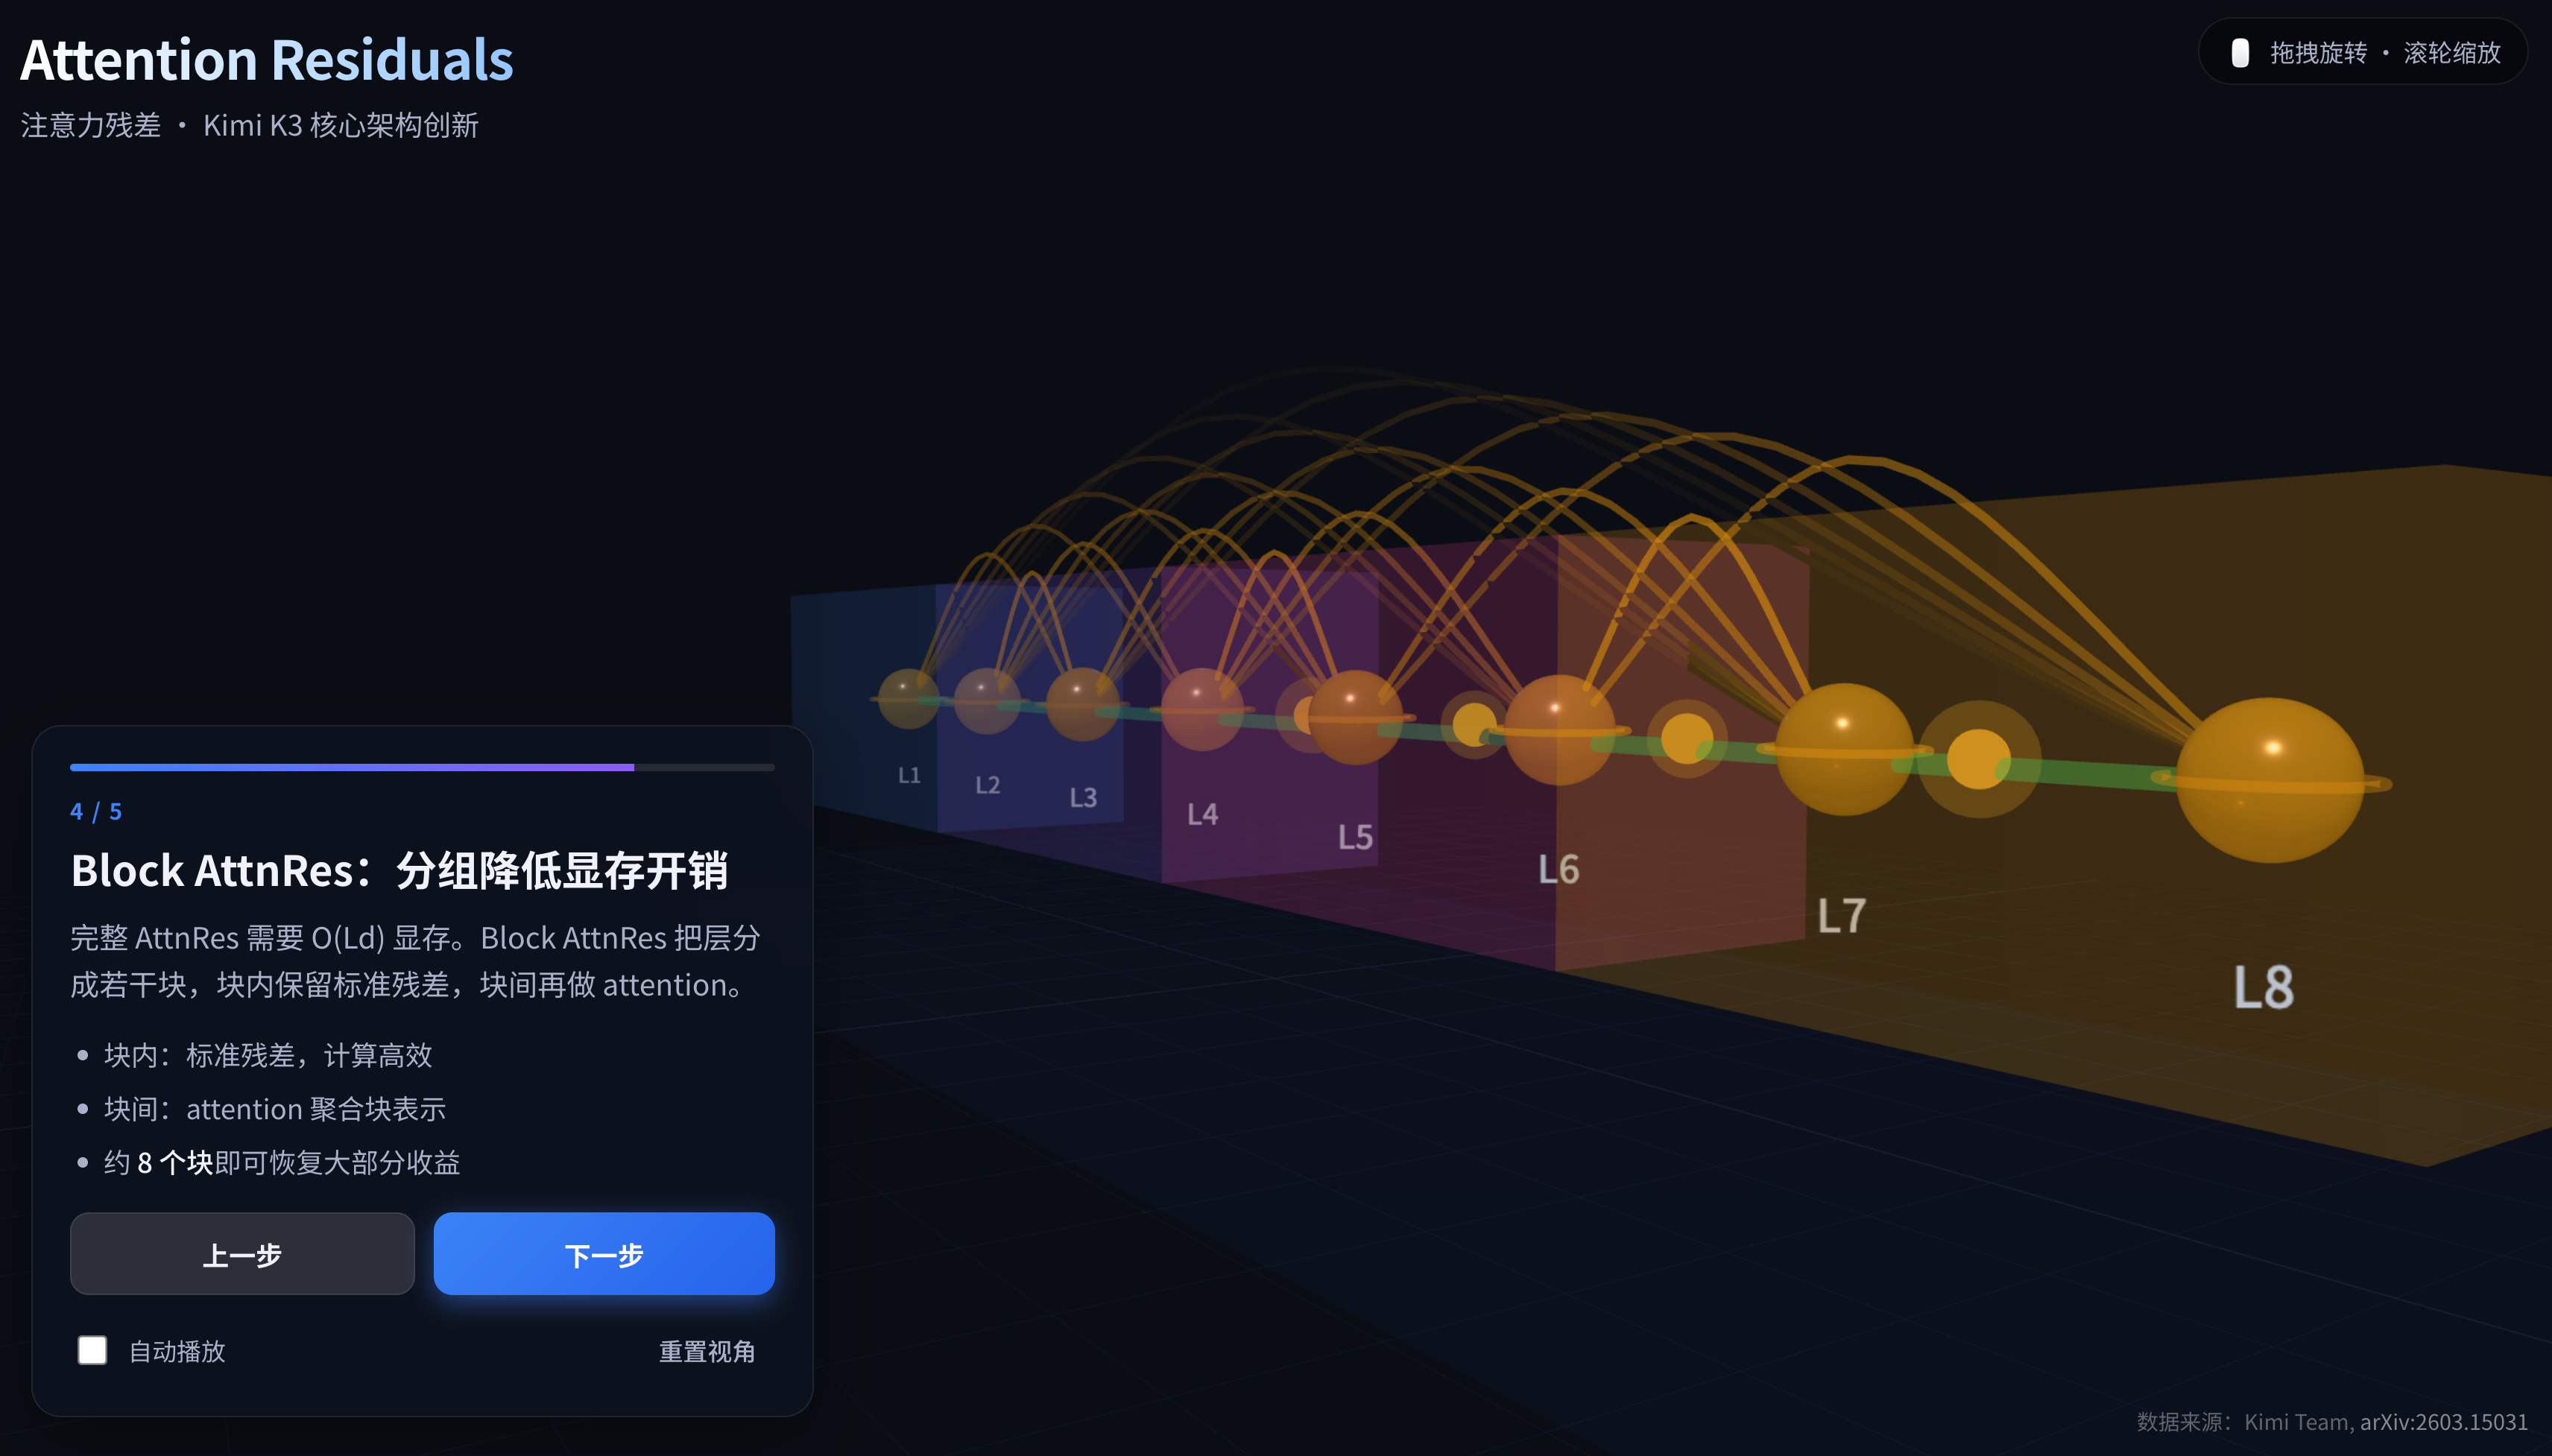
国产模型这一年进步飞快,很多场景已经不比国外的差了。比如 Kimi K3 做前端开发和视觉效果很强,DeepSeek V4 性价比极高、很适合做 AI 应用开发项目的底层模型,GLM-5 系列的全栈开发能力也很能打。具体怎么选,可以阅读本教程编程工具板块中的《AI 模型选择指南》。
方案四:预算充足就走官方合作方。
如果你预算充足,还是想用 Claude 系列模型,建议走 Cursor 这种官方合作方,比直接订阅 Claude 更稳定。毕竟 Claude Opus 5 的编码能力确实很强,这一点我在本教程模型动态板块的《Claude Opus 5 编程能力实测 - 7 个项目案例》里已经详细验证过了。何必整天跟 Anthropic 斗智斗勇呢?
写在最后
这篇文章带你看清了 Claude Code 的封号机制:以 ANTHROPIC_BASE_URL 环境变量为触发条件,通过系统时区和域名黑名单两条路径识别用户,再用 Unicode 隐写术把标记悄悄回传服务器。也复盘了那次因为支付漏洞引发的大规模连坐封禁。
对我们来说,最有价值的结论其实是这一条:关键的工作流一定要有备用方案。
不要把自己的生产力完全绑定在一家公司的一个账号上。能跑在本地的尽量跑在本地,模型和工具尽量做到可替换。这样哪天某家公司抽风了,你也能第一时间切换过去,不影响干活。
说到底,工具和模型都只是手段。真正属于你的是需求拆解能力、工程方法和产品思维,这些东西不会因为一封封号邮件而归零。