AI 基础概念
人工智能(AI)
人工智能(Artificial Intelligence)是让计算机模拟人类智能的技术。简单来说,就是让机器能像人一样思考、学习和解决问题。
在 Vibe Coding 中,AI 就是你的编程助手。你只管告诉它要做什么,它就会嘎嘎帮你做方案、写代码、修 Bug。就像你有一个 24 小时在线的程序员朋友,随时可以帮你干活。
大语言模型(LLM)
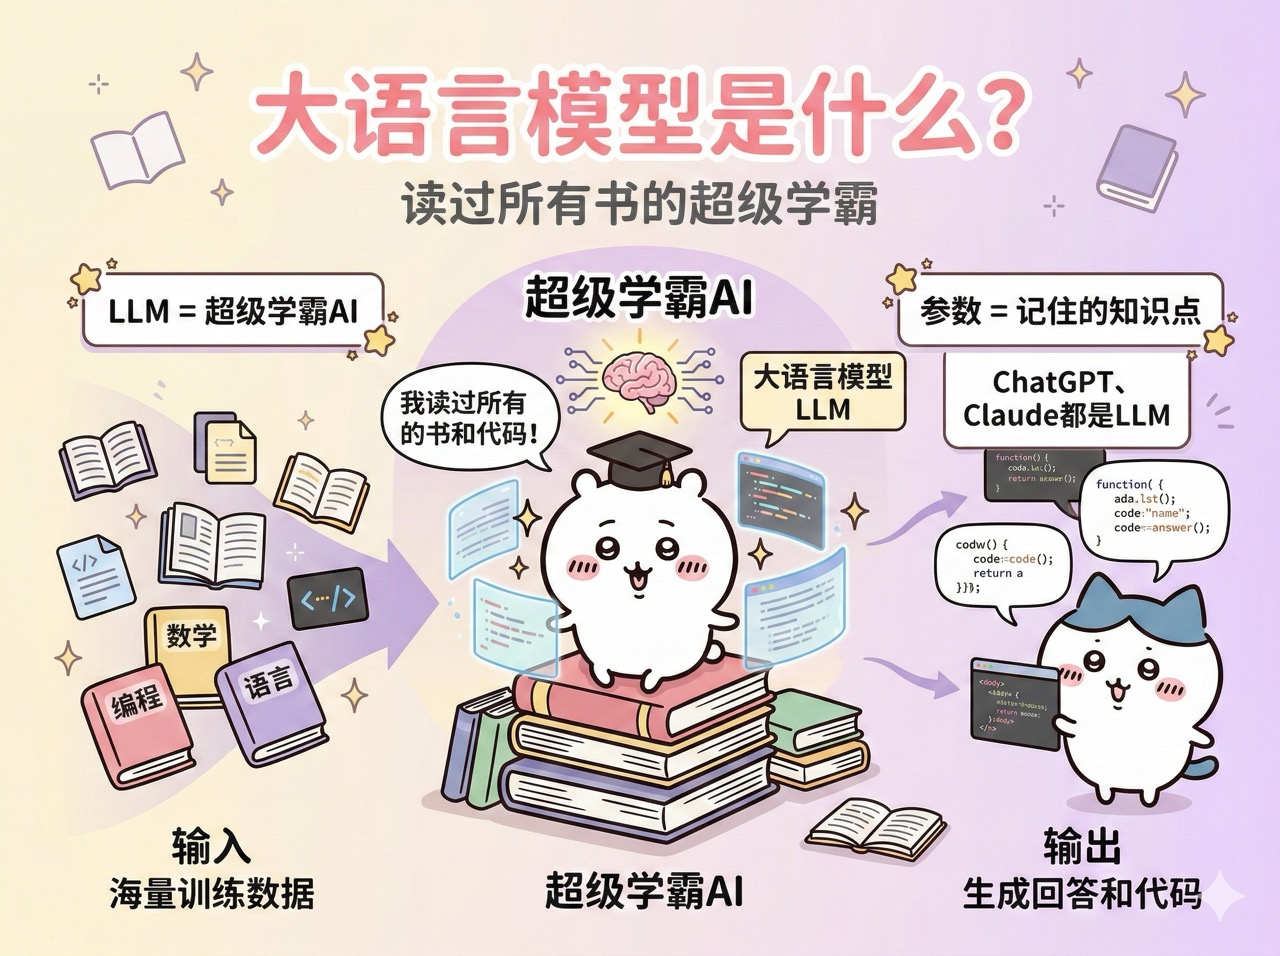
大语言模型(Large Language Model)是一种能够理解和生成人类语言的 AI 系统。ChatGPT、Claude、Gemini、DeepSeek 都是大语言模型。
为什么叫 “大” 模型呢?因为这些模型的 参数量 非常庞大,动辄几十亿甚至上万亿个参数。参数越多,模型通常越聪明,但也越消耗计算资源。
你可以把大语言模型理解成一个读过海量书籍和代码的超级学霸,它见过无数的编程案例,所以能帮你写代码、解释代码、修复 Bug。
除了文本大语言模型之外,AI 领域还有专门处理图片的视觉模型(比如 Stable Diffusion)、处理语音的音频模型(比如 Whisper)、以及能同时处理文字、图片、音频的多模态模型(如 GPT-4o、Gemini)。在 AI 编程时,我们主要和文本大语言模型打交道。
Token(词元)
Token 是 AI 模型处理文本的基本单位,中文叫做 “词元”。你可以简单理解为 “词块”,是大模型把文字拆分后的最小单元。
Token 是你必须掌握的核心概念,因为 AI 服务通常按照 Token 收费。你输入的文字和 AI 输出的文字都会消耗 Token。Token 用得越多,花的钱就越多。
在英文中,一个 Token 大约是一个单词或单词的一部分。在中文中,一个汉字通常是 1 ~ 2 个 Token。不同模型使用的分词器(Tokenizer)不同,所以同一段文字在不同模型中可能对应不同数量的 Token。
值得一提的是,国产大模型(比如通义千问、DeepSeek)针对中文做了专门优化,1 个 Token 大约可以表示 1.5 ~ 1.8 个汉字,比早期的英文模型效率高不少。
举个例子来帮助大家理解:
- "Hello World" 大约是 2 个 Token
- “你好世界” 大约是 4 ~ 6 个 Token
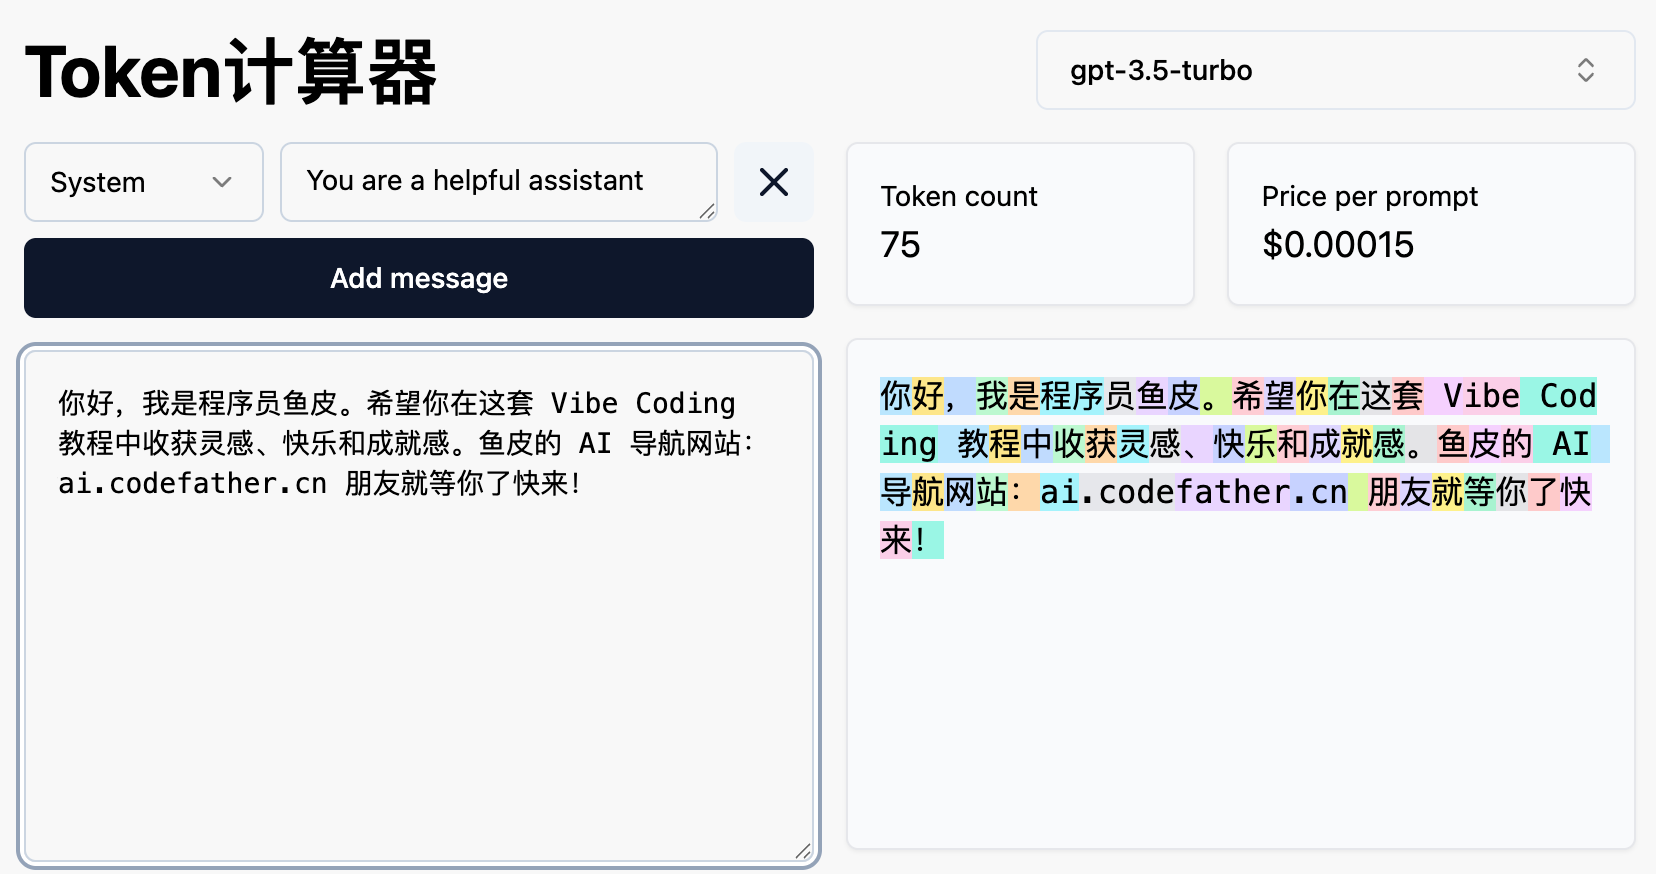
目前很多 AI 编程工具(比如 Cursor、Claude Code)都自带了 Token 消耗量的实时统计和展示,方便你随时掌握用量和成本。
输入 Token 和输出 Token
AI 服务在计费时,一般会分别计算输入和输出的 Token。
- 输入 Token:你发给 AI 的内容,比如提示词、代码、文件等
- 输出 Token:AI 返回给你的内容,比如回答、生成的代码、工具调用指令等
一般来说,输出 Token 比输入 Token 更贵。以 Claude Sonnet 4 为例,输入价格是 3 美元/百万 Token,输出价格是 15 美元/百万 Token,贵了 5 倍。这是因为生成内容比理解内容更消耗算力。
最简单的一个省 Token 小技巧是:用心编写简洁清晰的提示词,让 AI 一次就能理解你的需求,减少反复对话。更多省 Token 技巧可以看看鱼皮分享过的视频:AI 编程省钱技巧
Token 缓存
Token 缓存是一个能帮你省大钱的机制。简单来说,大模型在处理你的提示词时,需要做大量的计算。如果你连续多次对话,很多内容(比如系统提示词、引用的代码文件)是重复的,每次都重新计算就太浪费了。缓存机制会把这些中间计算结果保存下来,下次遇到相同的前缀内容就直接复用,不仅更快,还更便宜。
缓存相关的 Token 分为两种:
- 缓存写入 Token:AI 第一次处理你的上下文时,会把计算结果存起来,比普通输入略贵一点
- 缓存读取 Token:后续再用相同的上下文时,直接复用缓存,价格甚至可以低到普通输入的 1/10,非常便宜
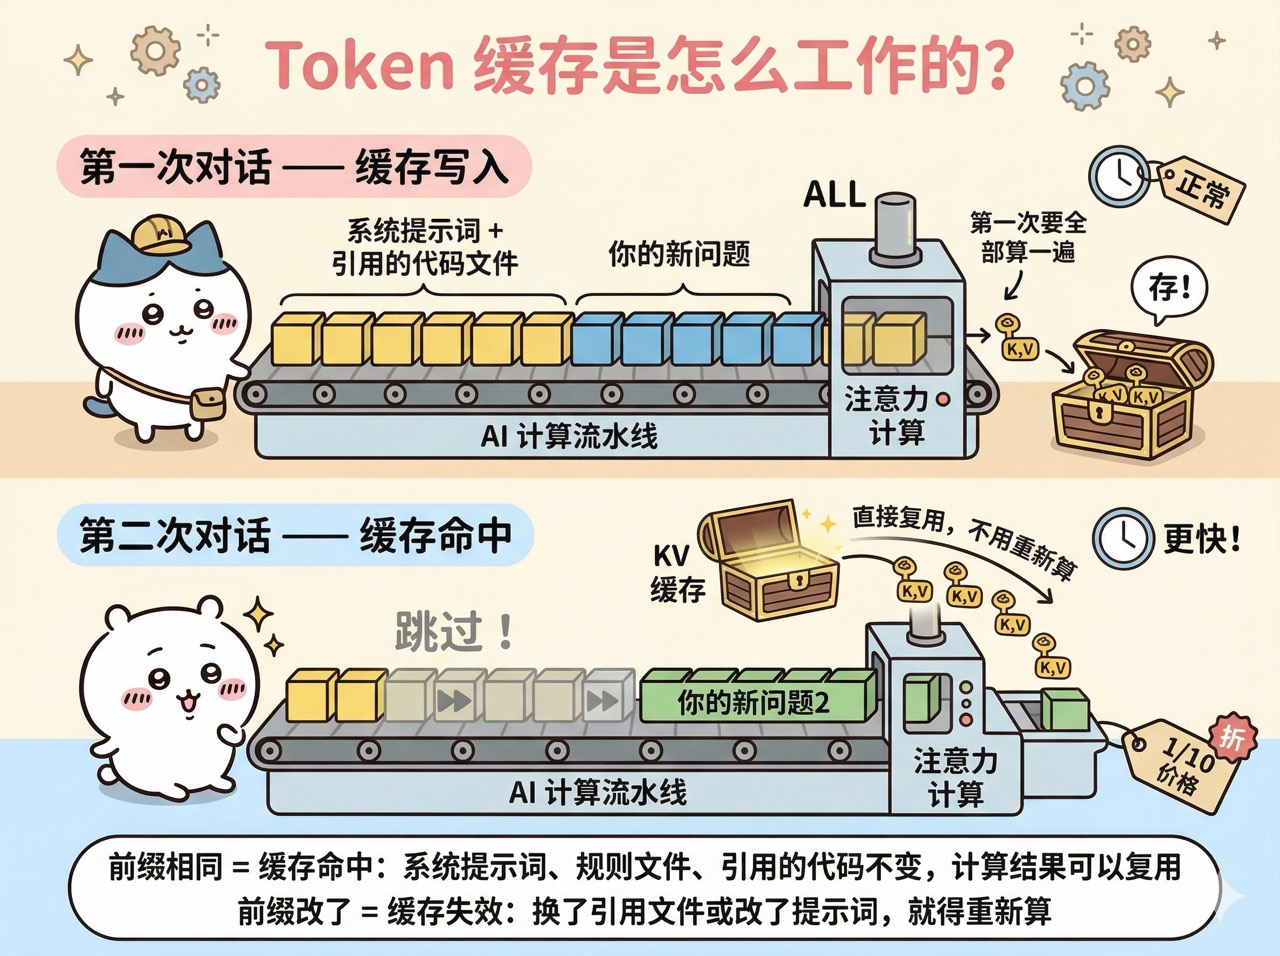
所以在对话时,尽量保持上下文稳定,比如引用的文件、规则文件不要频繁改动,这样能持续享受缓存优惠。有时候你会发现连续对话比开新对话更省钱,就是因为缓存在起作用。
模型参数
参数是模型在训练过程中学到的 “知识点”,用数字的形式存储在模型中。
举个好理解的例子,模型在训练时读到了大量 “天空是蓝色的” 这类内容,它就会在参数中记住 “天空” 和 “蓝色” 之间的关联关系。参数越多,模型能记住的知识和关联就越丰富。
参数量直接影响模型的能力和使用成本。参数越多,模型越聪明,但运行时消耗的算力(GPU 计算资源)也越多,所以价格也越贵。
目前主流大模型中,明确公开参数量的有:
- DeepSeek-V4-Pro:1.6 万亿参数(采用 MoE 混合专家架构,实际激活 490 亿)
- DeepSeek-V4-Flash:2840 亿参数(激活 130 亿)
- Qwen3.8-Max:2.4 万亿参数(通义千问最新旗舰模型,同样是 MoE 架构,实际激活 950 亿,只占总参数的 4% 左右)
- Llama 4 Scout:1090 亿参数(Meta 开源模型,激活 170 亿)
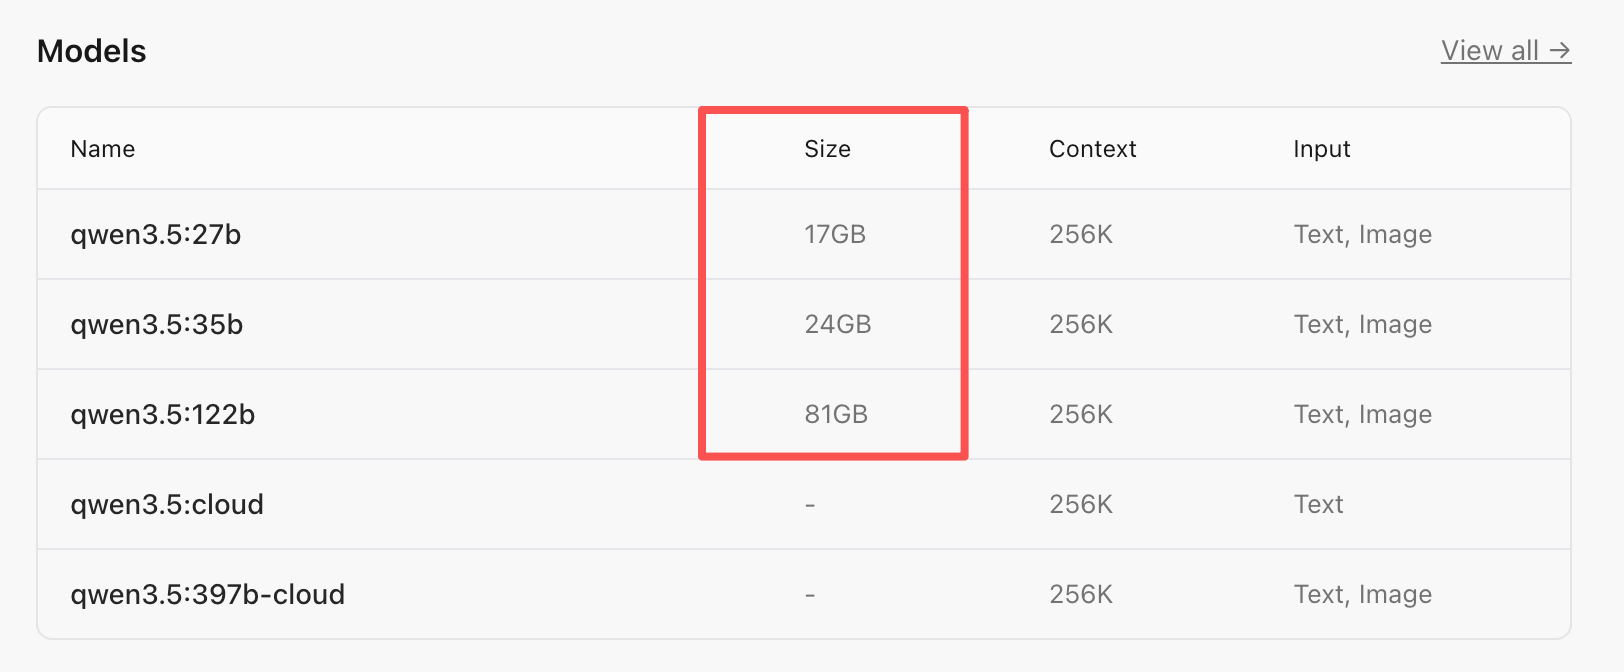
值得一提的是,即使是同一系列的大模型,厂商也会提供不同参数量的版本供你选择。
模型训练和推理
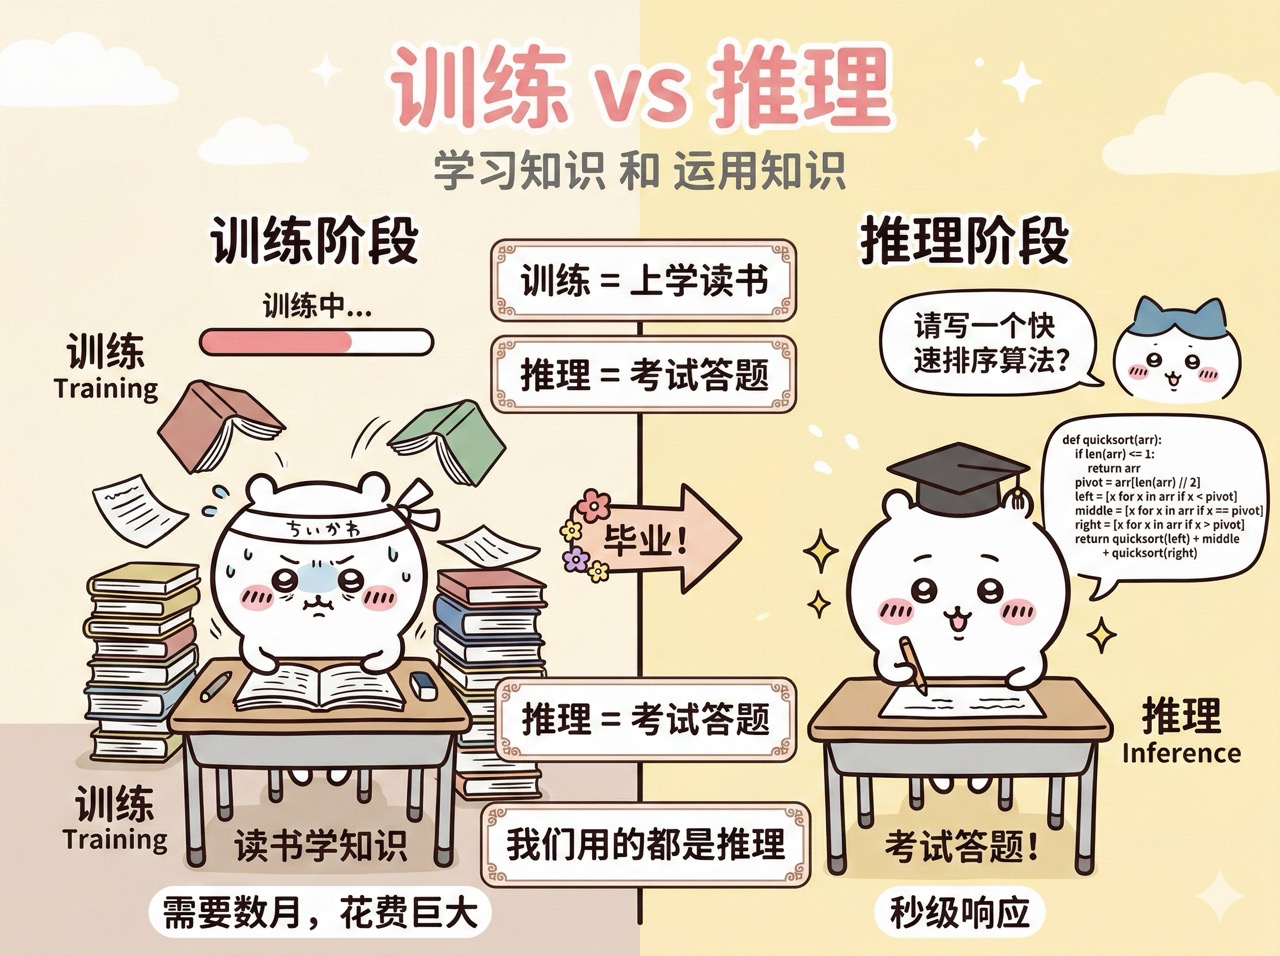
训练(Training)是让 AI 模型从大量数据中学习知识的过程。这个过程需要海量的计算资源和时间,一般由 AI 公司完成。绝大多数情况下,你不需要自己训练模型,直接用训练好的成品就行。
推理(Inference)是模型训练完成、具备了知识之后,用学到的知识来回答问题、生成内容的过程。我们日常使用 AI 工具,比如和 ChatGPT 对话、让 Cursor 写代码,本质上都是 AI 模型在进行推理。
打个比方,训练就像学生上学读书,推理就像学生参加考试答题。
模型微调(Fine-tuning)
微调是在已有模型的基础上,用特定领域的数据继续训练,让模型在某个领域表现更好。
比如,你可以用大量的医学资料微调一个模型,让它成为医学专家。或者用你公司的代码库微调,让它更了解你的项目风格。
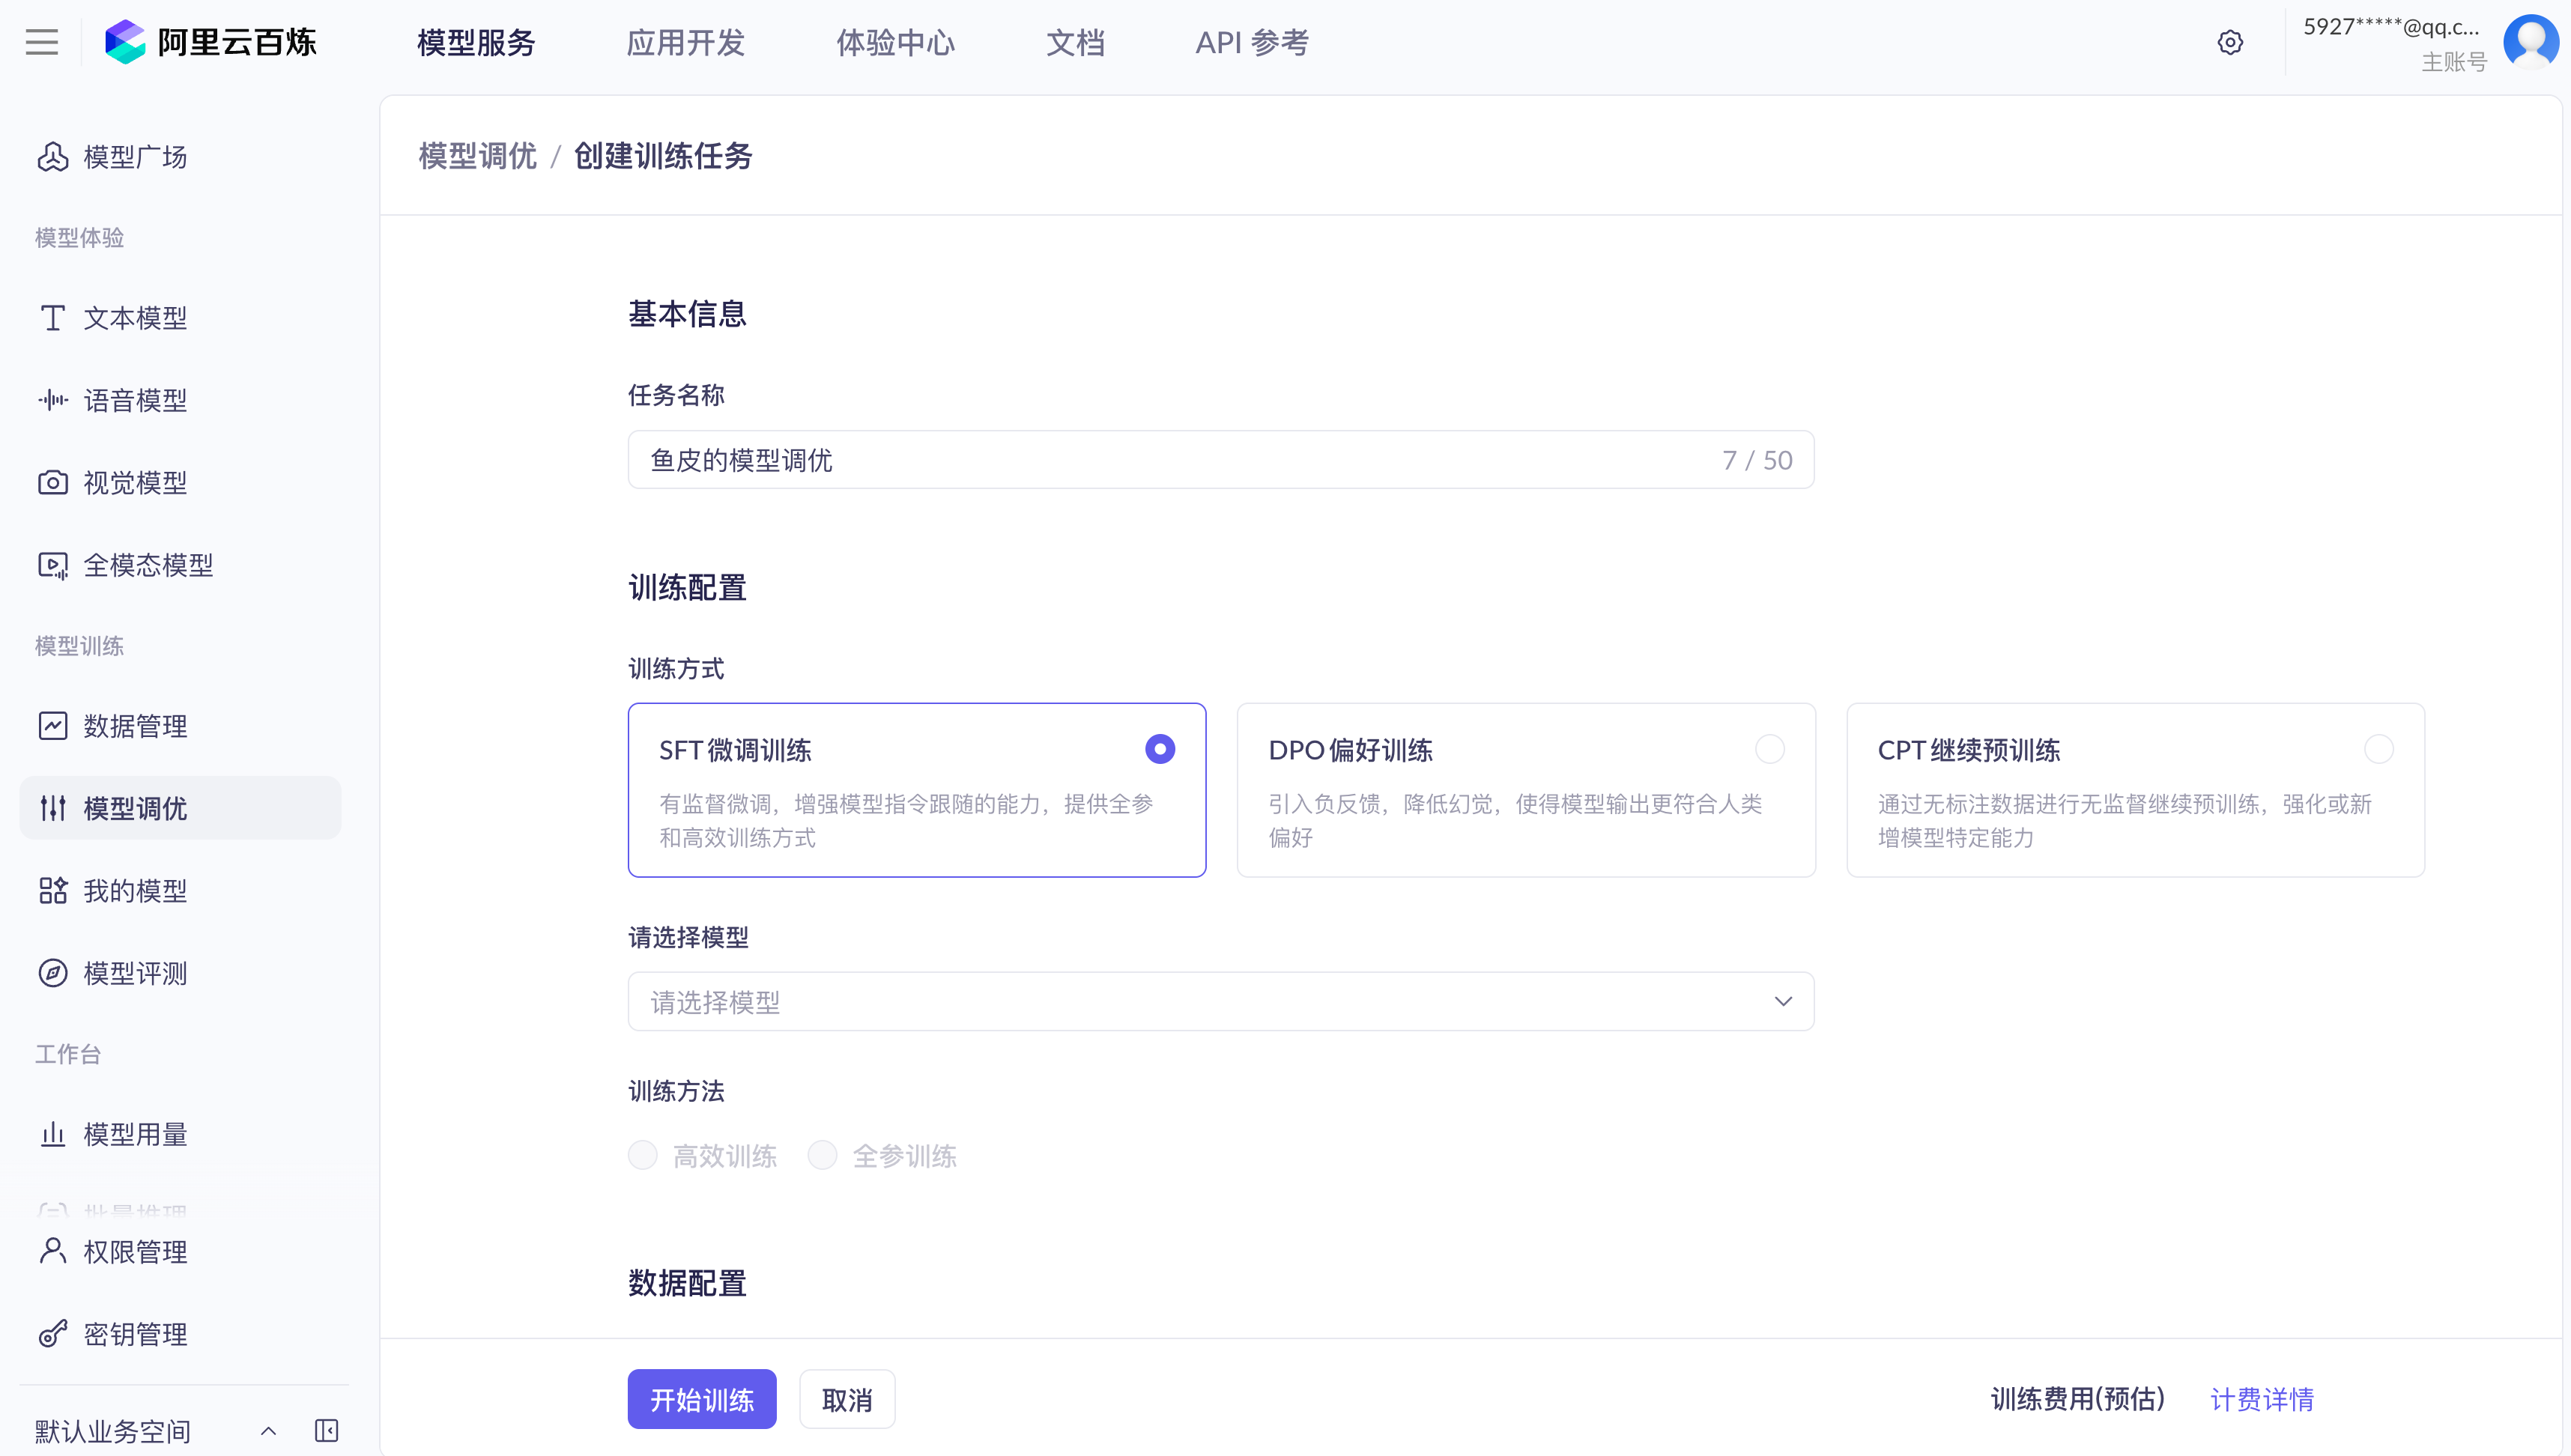
对于普通用户来说,微调成本较高,一般不需要自己做,直接使用现成的模型就够了。不过,很多大模型应用开发平台(比如阿里云百炼、火山引擎等)都提供了模型微调的能力,降低了微调的门槛。
模型蒸馏
模型蒸馏,也叫知识蒸馏(Knowledge Distillation),是一种把大模型的知识 “压缩” 到小模型里的技术。
就像一个经验丰富的高级开发带新人,高级开发(教师模型)不只是告诉新人最终答案,还会分享自己的推理过程和思考逻辑。新人(学生模型)通过学习这些思维方式,能做出接近的决策,但成本低得多。
蒸馏的核心在于 “软标签”。举个例子,让大模型识别一张动物图片,它不会只说 “这是狗”,而是会给出一组概率:狗 92%、猫 5%、狼 3%。那个 5% 的 “猫” 其实包含了珍贵的信息,说明这张图里的动物和猫有某些相似特征。小模型通过学习这些概率分布,能学到类别之间的微妙关系,效果比只看 “对或错” 的硬标签好得多。
蒸馏的好处非常多,比如成本降低 5 ~ 30 倍、推理速度提升 4 倍、性能保留 95% 以上。典型案例就是 DeepSeek-R1 的蒸馏版本,用 671 亿参数的教师模型训练出 32 亿参数的学生模型,性能依然出色。最新的 DeepSeek-V4 系列也延续了这一思路,通过 MoE 架构让 1.6 万亿参数的模型仅激活 490 亿参数就能达到强大的推理能力。
蒸馏和微调有什么区别呢?
微调是在已有模型基础上用特定数据继续训练,让它在某个领域更专业;蒸馏是把大模型的知识转移到小模型里,让小模型更轻量、更便宜。
上下文窗口
上下文窗口(Context Window)是指 AI 模型一次能 “记住” 的最大内容量,用 Token 来衡量。
不同模型的上下文窗口大小不同:
- GPT-4o:128K Token(约 10 万中文字)
- GPT-5.5:1M Token(约 75 万中文字)
- Claude Opus 4.8:标准 200K Token,支持扩展到 1M Token(约 75 万中文字)
- Gemini 3.1 Pro:1M Token(约 75 万中文字),且支持同时处理文字、图片、音频、视频
- DeepSeek-V4-Pro:1M Token(约 75 万中文字)
上下文窗口越大,AI 能处理的代码量就越多,能记住的对话历史就越长。如果你的项目代码很多,或者你不确定 AI 能否在一次对话中完成任务,选择上下文窗口大的模型会更合适。
但要注意,上下文窗口越大,每次请求消耗的 Token 也越多,成本也会更高。比如在 Cursor 中使用 Claude Sonnet 模型时,单次请求超过 20 万 Token,输入价格就会翻倍。