Agentic Harness Engineering:以可观测性驱动的编码 Agent Harness 自动演化
<div align="left"> <p align="left"> </p> </div>
English | 简体中文
本文档为英文 README.md 的中文翻译,可能略有滞后;如有冲突以英文版为准。
📰 动态
- [2026-05-14] 🏆 AHE(基于 GPT-5.5)以 84.7% 登上 Terminal-Bench 2.0 榜单,位列第 3 名(榜单排名截至 2026-05-15)
- [2026-04-30] ✍️ Dawning Road 上的博客(英文 & 中文)—— 关于 AHE 探索过程的更详细记述:Agentic Harness Engineering
- [2026-04-28] 📄 论文已在 arXiv 发布:Agentic Harness Engineering: Observability-Driven Automatic Evolution of Coding-Agent Harnesses
- [2026-04] 🎉 框架开源
🎯 概览
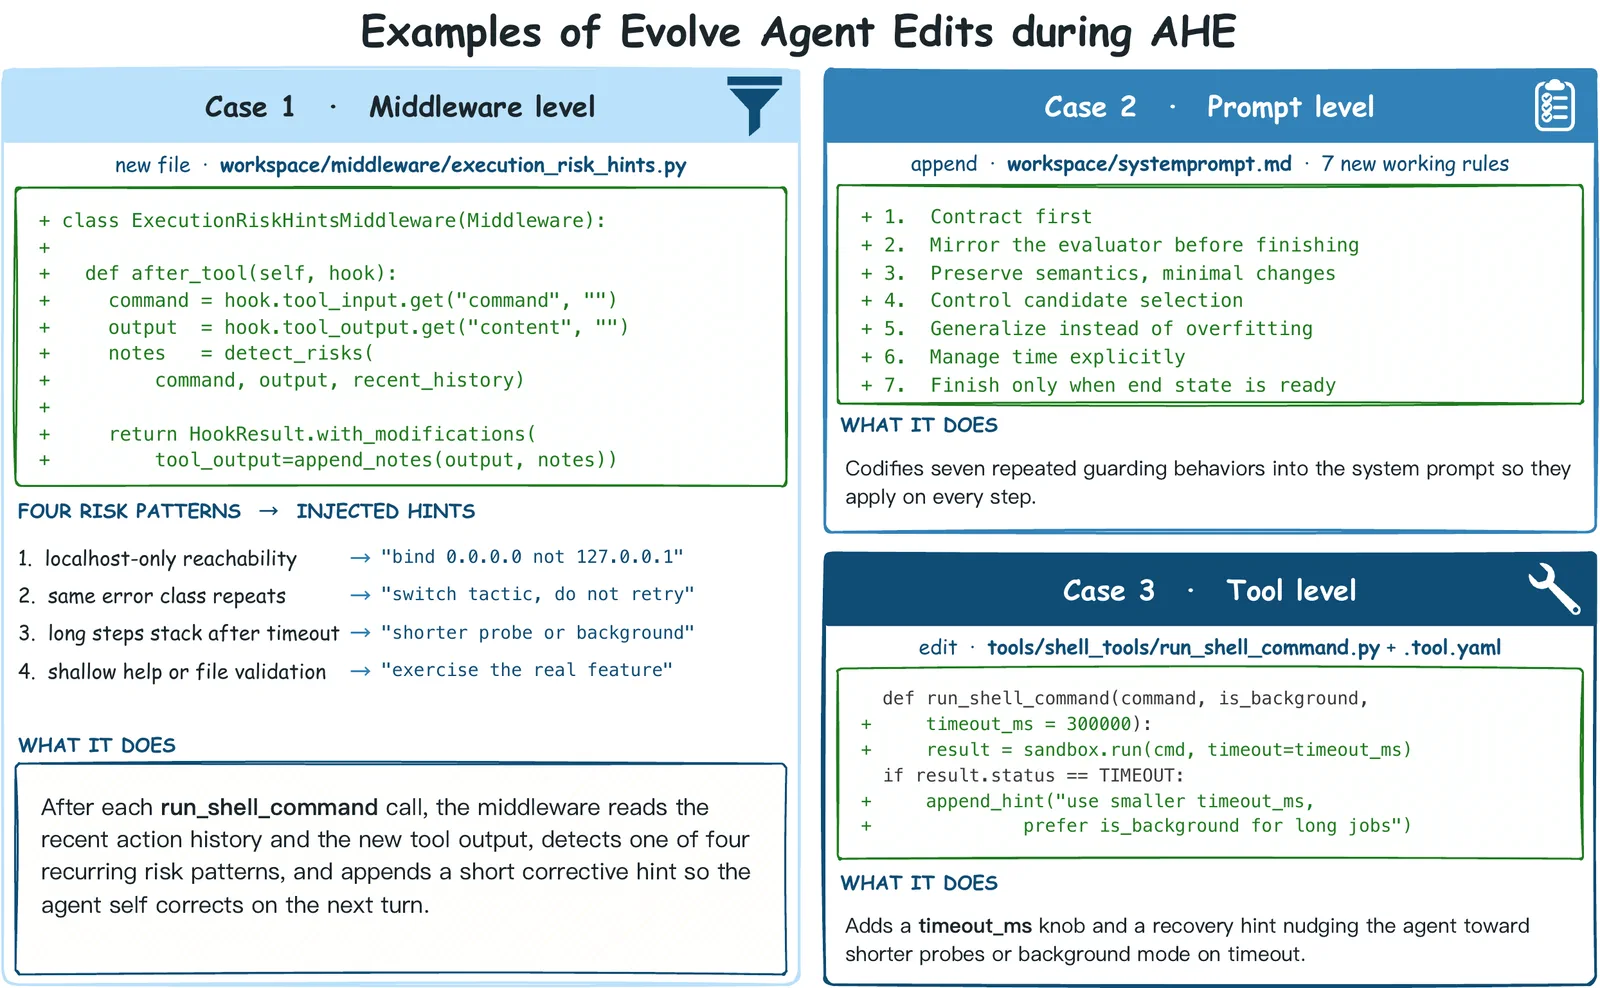
AHE (Agentic Harness Engineering) 是一个开放的可观测性系统,用于自动演化围绕在编码 agent 周围的 harness。基础模型保持不变,演化的是 harness 的各个组件——系统提示词、工具描述、工具实现、中间件、skill、子 agent、以及长期记忆。
AHE 建立在三层可观测性之上:
- 组件可观测性 (Component observability) —— NexAU 把 harness 拆分为七个正交的文件级组件,每一项都纳入 git 追踪,因此每次修改都可审计、可回退。
- 经验可观测性 (Experience observability) —— Agent Debugger 把 ~10M-token 的原始 trace 蒸馏成分层、可溯源的报告;优化器默认读 digest,但任何论断都可以下钻回某次 rollout 的原始 trace。
- 决策可观测性 (Decision observability) —— Evolve Agent 提出有证据支撑的修改、预测其影响,并由下一轮迭代中翻转的任务自动证伪。
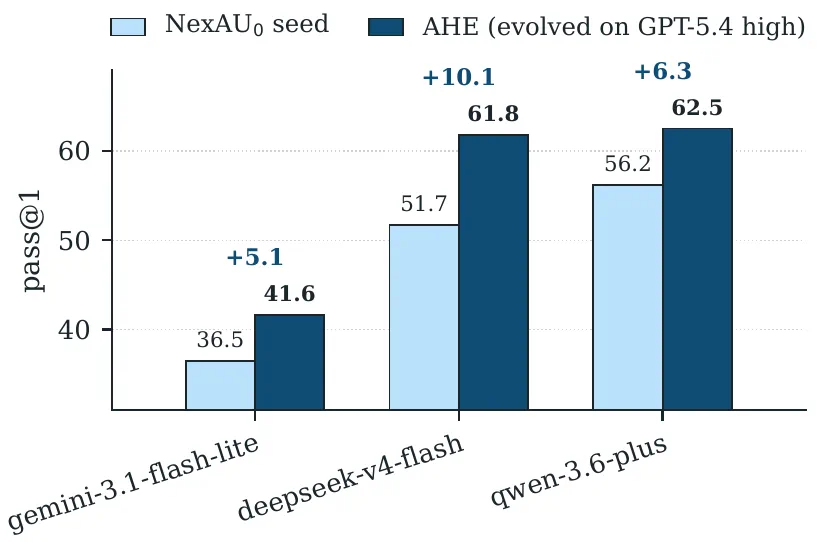
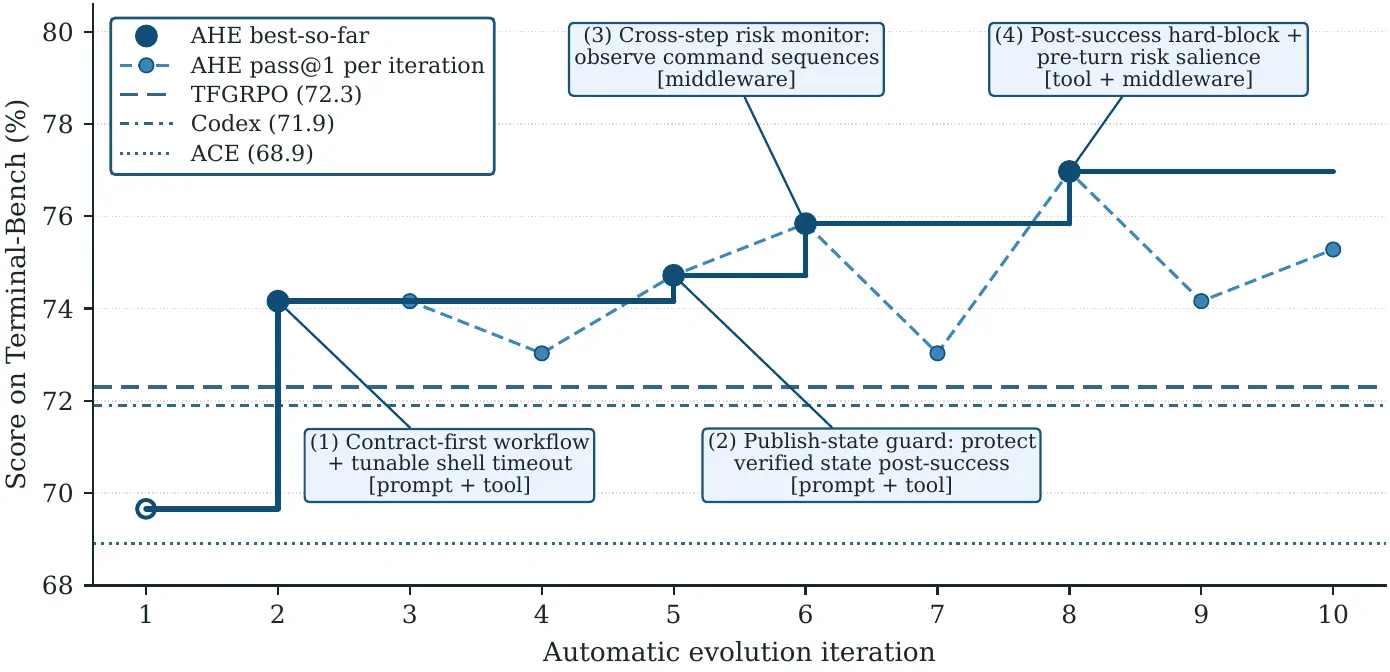
经过十轮 评估 → 分析 → 改进 迭代,AHE 在 GPT-5.4 上把 Terminal-Bench 2 的 pass@1 从 69.7% 提升到 77.0%,超过手写的 Codex (71.9%) 以及自演化的 ACE 与 TF-GRPO 基线;同时产出了一个无需重新演化即可迁移到 SWE-bench-verified 以及四个其他基础模型上的"冻结 harness",表明被演化出的组件编码的是通用工程经验,而非针对单一 benchmark 的调优。
🚀 快速开始
0. 前置依赖
- Python ≥ 3.13
- uv
- tmux
# macOS
brew install uv tmux

# Linux
curl -LsSf https://astral.sh/uv/install.sh | sh
sudo apt install -y tmux
1. 克隆 + 安装依赖
git clone https://github.com/Curry09/agentic-harness-engineering.git
cd agentic-harness-engineering
uv sync
uv sync会安装pyproject.toml中声明的所有依赖。
2. 配置环境变量
cp .env.example .env编辑 .env,至少需要设置:
| 变量 | 用途 |
|---|---|
LLM_API_KEY / LLM_BASE_URL | 主 LLM 端点(code_agent 与 evolve_agent 都消费它) |
E2B_API_KEY | E2B 沙箱——SaaS 与自部署的差异详见下一小节 |
SERPER_API_KEY | evolve_agent 使用的 web 搜索 |
ADB_LLM_* 与 GPT54_LLM_* 是可选项——不设置时回退到 LLM_*,或可用它们让 ADB / gpt-5.4 实验指向更强的模型。LANGFUSE_*、BP_HTML_PARSER_* 与 FEISHU_WEBHOOK 全部是可选的可观测性 / 便利性钩子;完整列表见 .env.example。
E2B 沙箱:SaaS 与自部署
AHE 每一次 rollout 都跑在 E2B 沙箱里,支持两种部署模式:
SaaS E2B(默认)。 只设置
E2B_API_KEY,不要设置E2B_API_URL/E2B_DOMAIN(注释掉即可)。SDK 会自动连到e2b.dev。⚠️ 并发上限。 SaaS E2B 对每个账号有按 tier 划分的并发沙箱上限。如果 harbor 试图启动超出该上限的沙箱,多余的会启动失败,整轮迭代会卡住。在调高 harbor / 实验配置中的并行度之前,请先确认你的 tier 配额并保持安全余量。
自部署 E2B 集群。 设置
E2B_API_KEY并让 SDK 指向你的集群:dotenvE2B_API_KEY="your_e2b_key" E2B_API_URL="https://your-e2b-host.example.com" E2B_DOMAIN="your-e2b-host.example.com"没有共享并发上限,但仍受集群硬件容量约束。
3. 构建 E2B 模板(每个数据集一次性)
这里使用的数据集来自 laude-institute/harbor-datasets 的子集——克隆你需要的部分,然后让 --dataset-dir 指向它的目录。
每次 rollout 都从一个预构建的 E2B 模板里启动沙箱,模板里已经装好了 uv 以及位于 /opt/nexau-venv 的 NexAU/harbor venv。在启动前一次性构建好这些模板:
# 构建数据集声明的所有模板,并发 16
uv run python scripts/build_templates.py --dataset-dir /path/to/dataset -j 16

# 失败后续跑:仅重试当前 E2B 构建状态为 ERROR 的任务
uv run python scripts/build_templates.py --dataset-dir /path/to/dataset --retry-failed

# 只构建某些任务
uv run python scripts/build_templates.py --dataset-dir /path/to/dataset task_a task_b
数据集目录下每个任务必须是一个子目录,里面有声明 [environment].docker_image 的 task.toml(或 environment/Dockerfile 作为 fallback)。每个任务的模板别名是 <task_name>,把 . 替换为 -。