千问办公绿皮书(QwenWorkGuide)
本文来自艾笑AI《【自媒体学 AI 必看】公众号排版 skill 详解》。
很多 Skill 写不好,不是因为提示词不够强。
而是因为一开始就没有把「流程、文件、脚本、模板」拆清楚。
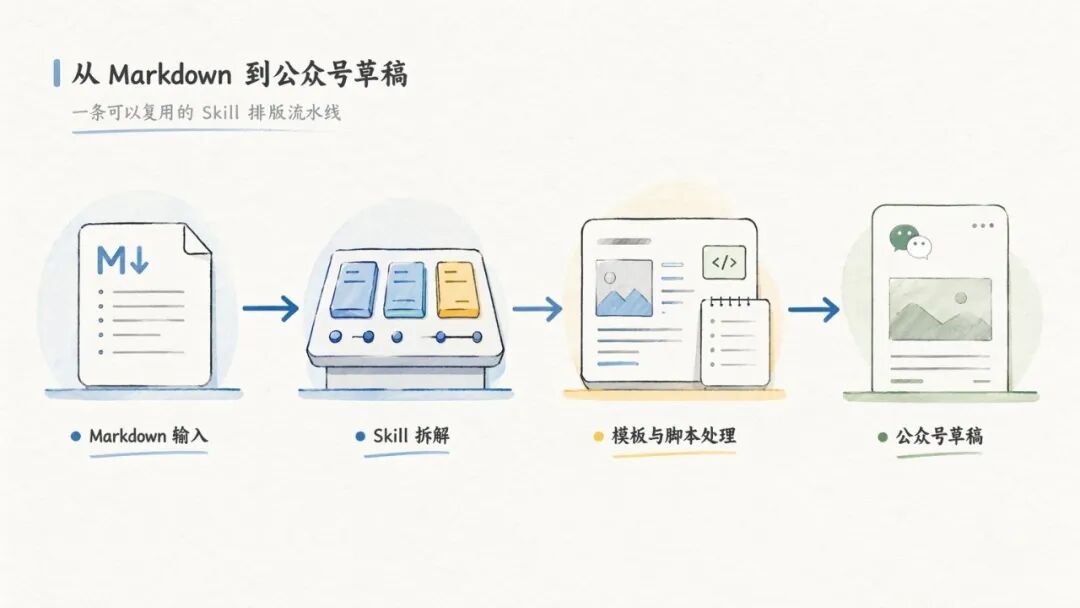
但框架讲多了,会有一个问题:听起来都对,落到手上还是不知道怎么拆。
所以今天换一个公众号排版的案例拆开来,看看这个 skill 怎么做。
公众号排版是一个常见的需求,而且在传统的工作流中也是一个费时间的事,甚至有人专门花钱请排版助理按次收费,每次 50-100元,而也有人专门就做这种自媒体小编的培训来推荐对接这种需求。
但现在这种事,一个 skill 就可以解决。原来自己排版怎么都得花个半小时,而且调整很烦人,现在只需要一句话 agent 自己完成,就像这篇文章一样,超不了一点心。
这个 skill 呢,比较适合来做一个案例。因为它不是一个简单问答,也不是一段提示词就能解决的任务。它里面有输入格式、有排版主题、有 Markdown 到 HTML 的映射、有图片处理、有预览、有校验,还有和公众号草稿同步流程的边界。
一个复杂的 Skill 能不能写好,长期好用,往往就藏在这些结构里。
01 为什么公众号排版值得做成 Skill
我平时写文章,大多先写在 Obsidian 里。源文件是 Markdown。
如果同步到布丁平台,这件事相对顺。因为布丁是我自己的平台,整条 H5 渲染链路可控:Markdown 怎么解析,图片怎么显示,代码块怎么渲染,前端可以直接配合调整。
但公众号不一样。
公众号后台不是 Markdown 编辑器。你把一篇 Markdown 长文直接复制进去,它不会自动理解这些结构:
- ## 是二级标题
- > 是引用块
- - 是列表
- ![图片] 是图片
- 代码块需要保留缩进和底色
- 表格需要在移动端还能读
公众号真正吃进去的,是一套适合它编辑器的 HTML 结构和样式。
也就是说,中间必须有一层映射关系:
Markdown 的文章语义,要被转换成微信公众号能识别、能保存、能展示的 HTML 标签。
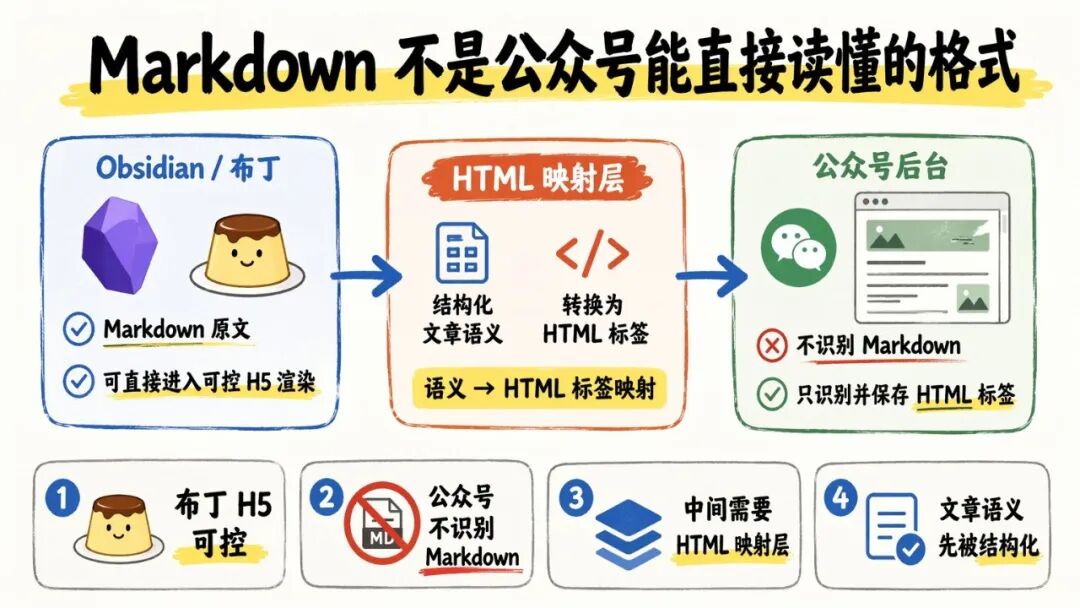
这就是公众号排版麻烦的地方。
以前常见做法是借助第三方公众号排版软件:把 Markdown 或正文粘进去,选一个主题,手动调整,再复制到公众号后台。这个流程能用,但它和自己的内容生产流水线是断开的。
每次发文都要在几个工具之间来回复制,图片还要考虑大小和上传,样式还要人工确认。文章越长、主题越多、发布越频繁,这件事越容易变成重复劳动。
所以想解决的问题不是「做一个更漂亮的模板」。
而是把公众号排版变成一个可复用的 Skill:
输入是一篇 Markdown 长文。
中间由 Skill 负责选择主题模板、加载组件、完成 Markdown 到 HTML 的映射、做微信兼容检查。
输出是一份可以预览、可以继续同步到公众号草稿的 HTML。
这个问题一旦这样定义,Skill 的结构就自然浮出来了。
02 先画出排版流水线,而不是先写提示词
很多人写 Skill 的第一反应是打开 SKILL.md,然后开始写:
「你是一个专业的公众号排版助手,请把下面的 Markdown 转成优雅的微信排版。」
这句话不能说错,但它太简单了,属于许愿式的写法,无法持续准确地完成任务。
因为公众号排版不是一句话任务,它至少要分成几步。
可以先把它画成这样:
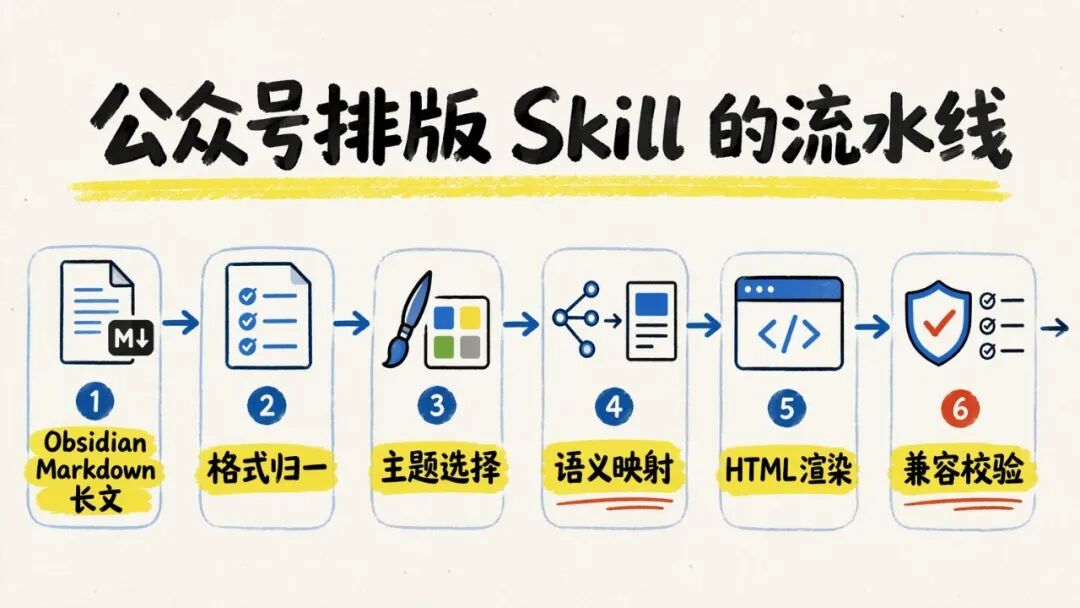
这张流程图一画出来,问题就清楚了。
SKILL.md 不应该包办所有事情,它更像整个流程的入口和调度台。
格式归一应该有说明文档。
主题选择应该有索引。
主题样式应该放在主题文件里。
HTML 渲染和校验应该尽量脚本化。
同步公众号草稿则应该交给另一个 Skill,不要塞进排版 Skill 里。
这就是 Skill 拆解的第一步:不是先问「提示词怎么写」,而是先问「这条链路有几段,每一段应该由谁负责」。
「Skill 的核心不是把一句话写得更聪明,而是让 Agent 知道下一步该读什么、该调用什么、该停在哪里。」
03 文件夹不是收纳,是职责边界
当公众号排版变成一个真正可复用的 Skill,它就不能只剩一个 SKILL.md。
它需要一个清楚的目录结构。
可以把它拆成类似这样:
text
gzh-format/
  SKILL.md
  skill.contract.yaml
  references/
    theme-index.md
    format-normalize.md
    architecture.md
    scripts.md
  themes/
    _shared/
      common-components.md
    minimal/
      components.md
    red/
      components.md
    green/
      components.md
  scripts/
    render_markdown.py
    validate_gzh_html.py
    component_lint.py
    regression.py
  assets/
    sample-article.md
  tests/
    fixtures/
      stress-markdown.md
这个目录不是为了显得工程化,也不是为了给复杂度找理由。
它的核心是把功能放到合适的位置。
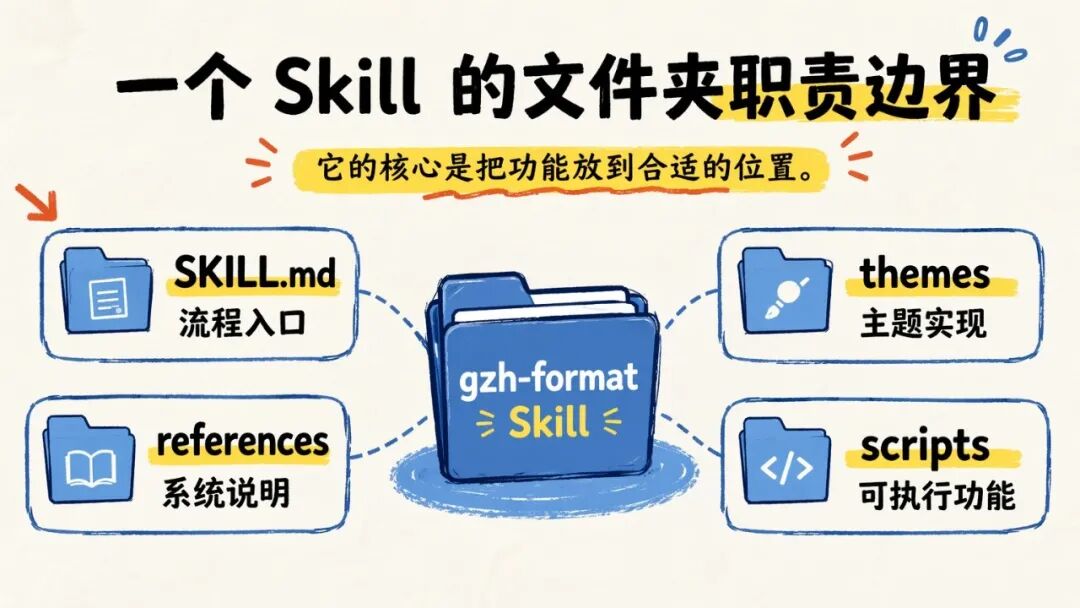
SKILL.md 负责整个流程和判断入口。
更准确一点说,它里面有两层入口。
第一层是 frontmatter 里的 description,负责让 Agent 在真正加载正文之前,就知道这个 Skill 什么时候该被触发。
第二层才是 SKILL.md 正文,负责告诉 Agent:触发之后第一步读什么,默认主题是谁,什么时候只生成预览,什么时候可以把结果交给公众号草稿同步。
references 负责说明系统怎么被理解。
这里不是随便放资料,而是放 Agent 执行时需要参考的规则。比如主题索引、格式归一、架构说明、脚本说明。
themes 负责主题实现。
不同主题的标题、引用、图片、列表、代码块可以有不同视觉风格,但它们都应该响应同一套 Markdown 语义。
scripts 负责真正可执行的功能。
渲染、校验、组件 lint、回归测试,这些都不应该靠 Agent 每次临场发挥。
assets 和 tests/fixtures 负责样例和测试输入。
一个排版 Skill 不能只拿一篇漂亮文章测试。它需要压力样稿:有长标题、有图片、有引用、有列表、有代码块、有表格。这样才能知道主题和脚本是不是真的扛得住。
所以目录结构的意义不是「收纳」。
它是在告诉自己,也是在告诉 Agent:这个系统里,每个文件夹到底承担什么职责。
04 写入口,别堆砌所有内容
很多复杂 Skill 后来变难维护,第一原因就是 SKILL.md 太重。
一开始它只是入口,后来慢慢塞进了模板、样式、脚本说明、主题规则、历史变更、异常处理,最后变成一个什么都写、什么都不清楚的大文档。
我现在更愿意把 SKILL.md 当成主控台。
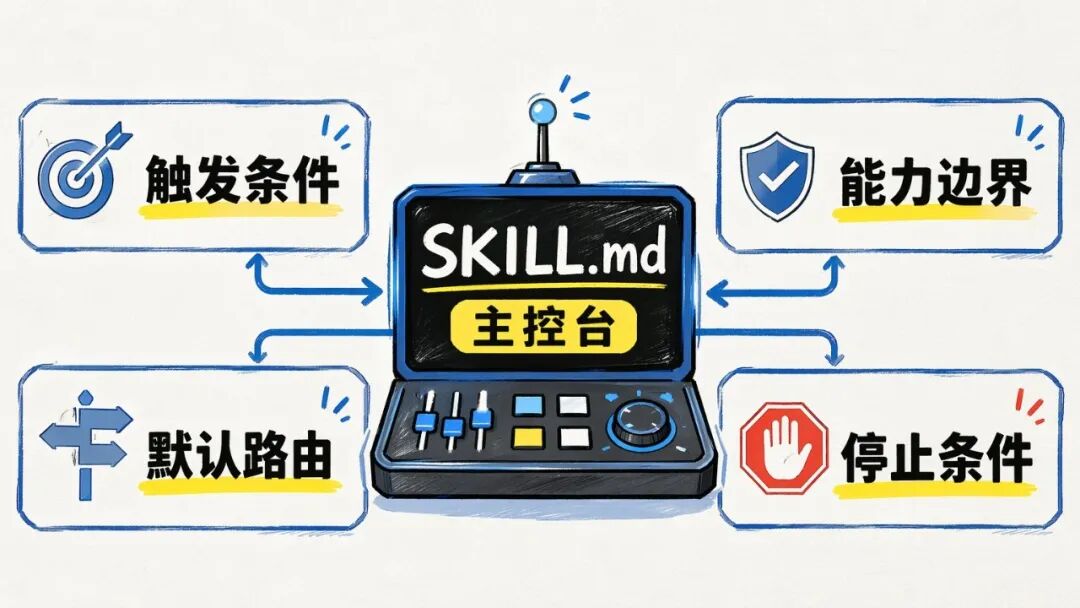
这里还有一个很容易被忽略的细节:Skill 的触发,并不是先读取 SKILL.md 正文。
对于 Agent 来说,第一眼看到的是 frontmatter 里的 name 和 description。
也就是说,description 不是装饰性的摘要,而是第一层路由规则。
它决定了 Agent 在用户说「公众号排版」「Markdown 转 HTML」「生成 H5 预览」时,会不会想到这个 Skill。要会把 description 当成触发合同来写。
一个足够干净的 SKILL.md,可以长这样:
---
name: gzh-format
description: 当用户需要公众号排版、微信排版、把 Markdown/OB 长文转成公众号 HTML、生成布丁 H5 排版、生成预览或维护排版主题时使用。这个 Skill 只负责排版、预览和校验;公众号草稿同步交给 wechat-draft-sync,布丁同步交给 pudding CLI。
---

# gzh-format

## 使用场景

- 把 Markdown 长文转成公众号 HTML
- 生成本地预览
- 为公众号草稿同步准备排版产物

## 资源分层

- references/theme-index: 主题路由表和默认选择规则
- skill.contract.yaml:机器可审契约,声明输入、输出、停止点、脚本